Command Palette
Search for a command to run...
海量土壤微生物数据难以注释,BBERT 从 100bp 短读段中挖掘分类与功能线索
微生物生态系统具有极其复杂的组成结构,理解这种复杂性,对于揭示维持生物圈运转的各种过程至关重要,而这项工作离不开对海量测序数据集的分析。如今,这类数据资源已十分丰富:数以千计的公开宏基因组数据集,覆盖地球上的各种生物群系,均可免费获取和下载。
在这些数据中,土壤宏基因组具有尤为重要的研究价值。 土壤等复杂环境中的鸟枪法宏基因组测序(Shotgun Metagenomics)能够揭示极其丰富的生物多样性。然而,由于缺乏足够全面的参考数据库,鸟枪法测序产生的大多数短读段(Short Reads)无法获得准确的分类学或功能注释,从而使微生物群落的真实结构与功能难以得到全面解析。
在此背景下,来自耶路撒冷希伯来大学的研究团队提出了 BBERT,一种针对短读段分析进行优化的核苷酸大语言模型。 研究人员在大规模土壤宏基因组数据集上开展测试,发现 BBERT 无需依赖参考数据库,即可识别细菌序列的语法特征,并直接从长度仅为 100 bp 的短读段中,准确判断其分类域归属(Taxonomic Domain)、编码潜力(Coding Potential)以及阅读框(Reading Frame)。此外,BBERT 模型能够将短宏基因组读段直接转换为细菌氨基酸序列,为后续研究和应用提供支持。在宏基因组从头组装方面,BBERT 同样展现出优势:它能够减少组装过程中的错配和间隙,同时缩短运行时间。研究人员进一步利用野生豆科植物根瘤的宏基因组数据进行验证,结果表明,通过 BBERT 进行数据过滤,不仅能够显著提升分箱(Binning)质量,还能大幅加快从头组装速度。
相关研究成果以「Fast and accurate taxonomic domain assignment of short metagenomic reads using BBERT」为题,已刊登 Nucleic Acids Research。
研究亮点:
- BBERT 同时突破了此前基于大语言模型的方法在处理吞吐量和准确性方面的局限
- 在宏基因组分析前使用 BBERT 进行预过滤,能够提高功能注释速度和从头组装质量,减少组装错误,并改善分箱质量
- BBERT 为短读段提供了一种快速、无需参考数据库的分类方法,有望释放现有大量宏基因组数据档案的研究价值
论文地址:
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false
数据集:从细菌基因组训练到复杂宏基因组环境验证
在 BBERT 的开发与评估过程中,研究人员整理并构建了两类数据集。
- 第一类用于模型预训练,包含来自 1416 个细菌物种的基因组数据。 为了使数据能够较好地覆盖细菌生命进化树,从 RefSeq 数据库中的每个细菌科随机抽取两个基因组。
- 第二类用于模型校准与评估,包含来自 396 个不同属的 899 个细菌物种,以及来自 823 个不同属的 1200 个真核生物物种。 值得注意的是,这两类数据集在属这一分类层级上完全分离,彼此之间不存在任何属的重叠。
同时,为了构建一套经过筛选、能够代表土壤环境中真核生物多样性的参考基因组数据集,研究人员首先通过查阅土壤微生物群落的 18S rRNA 和 ITS 扩增子宏条形码研究(Amplicon Metabarcoding Studies),确定目标分类群列表。相关研究包括地球微生物组计划、泛欧洲 LUCAS 土壤调查项目,以及针对全球土壤原生生物和真菌多样性的调查研究。
通过对上述文献进行综合分析,确定了八个在土壤微生物群落中持续表现出较高丰度的主要真核生物谱系,分别为:
- 丝足虫类(Cercozoa)
- 纤毛虫类(Ciliophora)
- 卵菌门(Oomycota,异鞭毛类群)
- 球囊菌门(Glomeromycota,即丛枝菌根真菌)
- 毛霉菌门(Mucoromycota)
- 子囊菌门(Ascomycota)
- 自由生活线虫(Free-living Nematoda)
- 变形虫类(Amoebozoa)
此外,数据集还补充纳入了与土壤环境相关的绿藻门,以及已有基因组测序数据的陆生植物分类群。
为了考虑物种分组过程中可能存在的随机性,按照属这一分类层级,分别将校准与评估数据集中的所有基因组登录条目划分为 20 个等量组,其中细菌和真核生物各分为 20 组。在每个组内,按照对数正态分布(Log-normal Distribution)随机分配物种丰度。随后,将两类数据集中的分组进行两两合并,形成 20 个组合子集。每个子集均具有独立的细菌与真核生物属组成。在这 20 个子集中,前 10 个子集(数据集1–10)用于模型微调,其余 10 个子集(数据集11–20)则保留用于模型评估。
BBERT 框架:让大语言模型从 DNA 序列中学习细菌特征
BBERT 是一种基于 BERT 架构开发的模型,旨在对来源于细菌基因组的核苷酸序列进行分布外检测(OOD),其核心思路是仅使用细菌序列进行训练,从而判断给定序列是否来源于细菌。为了构建一种基于核苷酸序列、能够对细菌基因组进行分布外检测的大语言模型,研究人员采用了三个阶段的开发流程:
- 仅使用细菌基因组读段对 BERT 架构进行预训练;
- 针对细菌/非细菌分类任务进行微调;
- 评估模型在细菌读段分类任务中的表现,并与 BERTax、Tiara 和 REMME 进行比较。
① 模型预训练
BBERT 的预训练使用了一个细菌数据集,其中包含经过采样生成的合成短核苷酸序列,每条序列长度均为 100 bp,旨在模拟宏基因组测序读段及其可能出现的测序错误。 在训练过程中,研究人员采用掩码语言模型作为优化目标,即对输入序列中 30% 的 Token 进行掩码,并优化模型根据上下文推断这些被掩码词元的能力。通过这一过程,模型能够学习基于已有读段信息来表征缺失核苷酸的能力。
预训练的优化过程以每轮 5–10 个训练周期(Epochs)为一个阶段持续进行,直至获得最优结果,同时保存所有中间检查点(Checkpoints,即模型权重)。通常情况下,观察到训练损失持续下降的同时,分类准确率也在不断提高。当训练进展陷入停滞,模型性能不再出现明显改善时,即终止训练。
② 模型微调
接下来,为了使 BBERT 能够执行细菌读段分类任务,研究人员在模型上增加了一个轻量级分类头(Classification Head):在 BBERT 编码器(Encoder)生成的词元嵌入之上添加一个线性层,用于直接预测某条读段是否来源于细菌。
该分类头采用有监督学习方式进行训练。训练过程中,没有冻结预训练 BBERT 的模型权重,而是将编码器与分类头进行联合微调,使编码器学习到的特征表征能够适应当前分类任务。为了避免预训练权重受到不稳定影响,分别为分类头和编码器设置了不同的学习率:编码器学习率为 1×10⁻⁶,分类头学习率为 1×10⁻⁵,并使用 AdamW 优化器。
研究发现,冻结 Transformer 编码器底部两层、微调其余层的策略效果较好。 模型最终输出读段属于细菌来源的概率,记为 bact_prob;当 bact_prob 大于 0.5 时,即将该读段判定为细菌来源。
③ 模型评估和比较
最后,研究人员在数据集上统计并报告模型的整体分类性能指标,并将基准测试结果与 BERTax、Tiara 和 REMME 进行比较。
成果: BBERT 分类准确率、功能注释与组装效率均得到验证
① BBERT 的性能优于现有先进深度学习分类工具
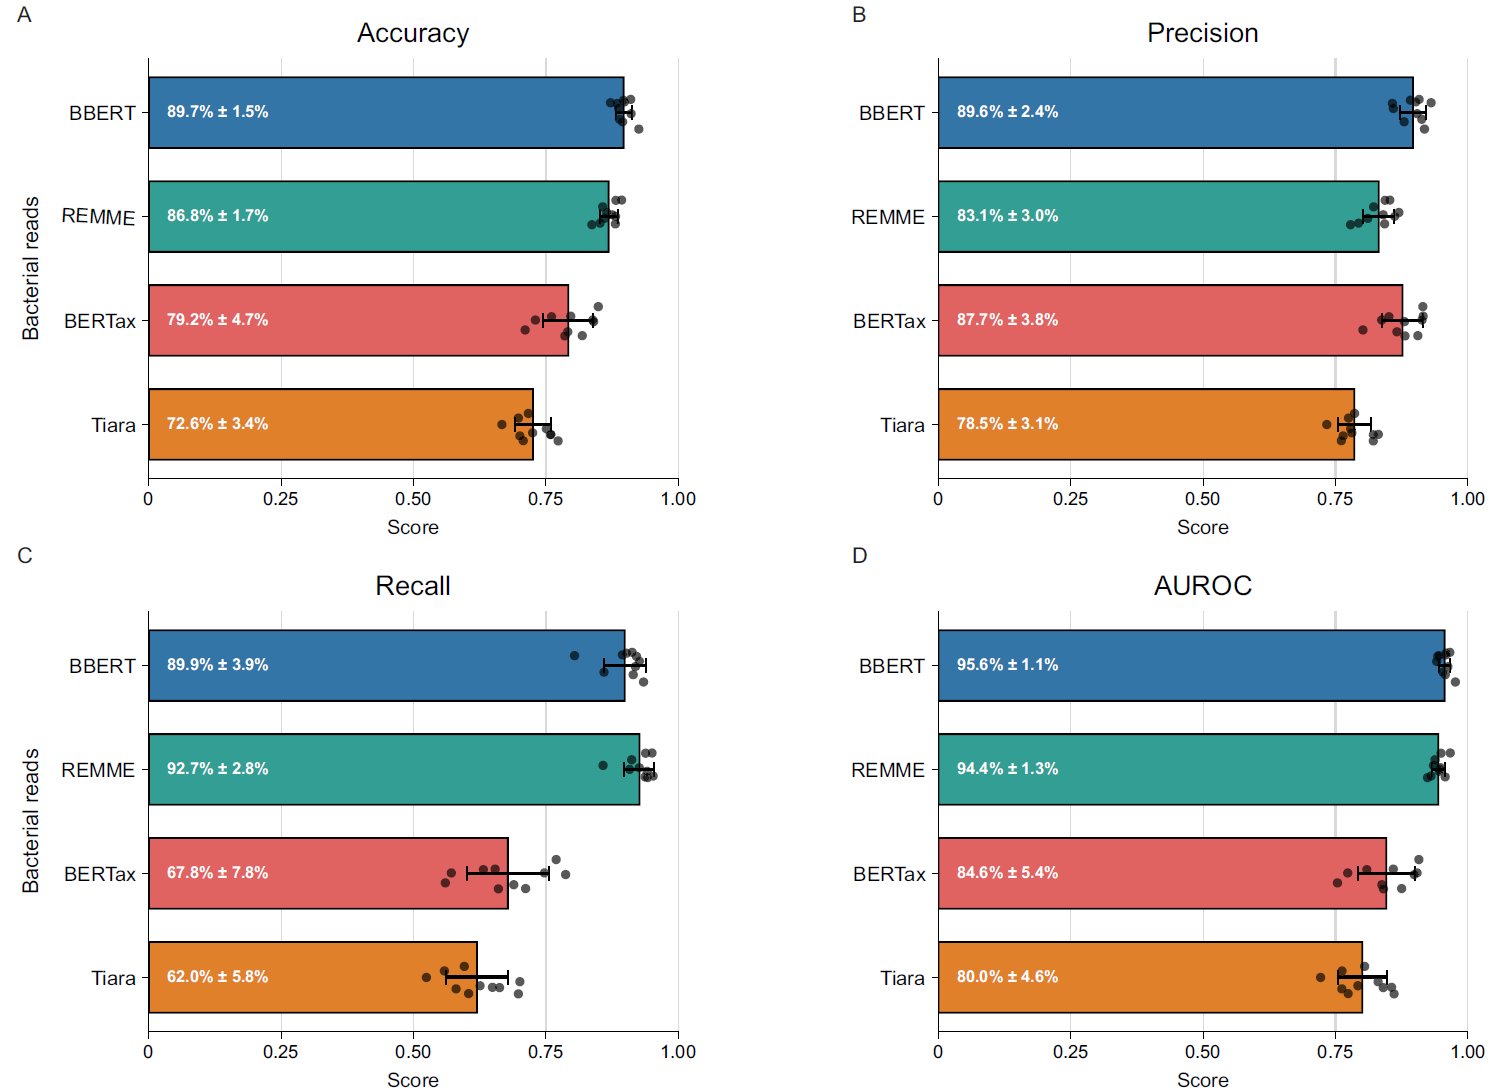
首先,在细菌与非细菌读段分类任务中,BBERT 表现出较强的识别能力 ——如下图,在准确率、精确率、召回率(与 REMME 表现相当)和 AUROC 等标准分类指标上,BBERT 的表现均优于 BERTax、Tiara 和经过优化的 REMME。BBERT 在 10 个测试集上的域分类平均准确率为 89.7% ± 1.7%,而 REMME 为 86.8% ± 1.7%,BERTax 为 79.2% ± 4.7%,Tiara 为 72.6% ± 3.4%。
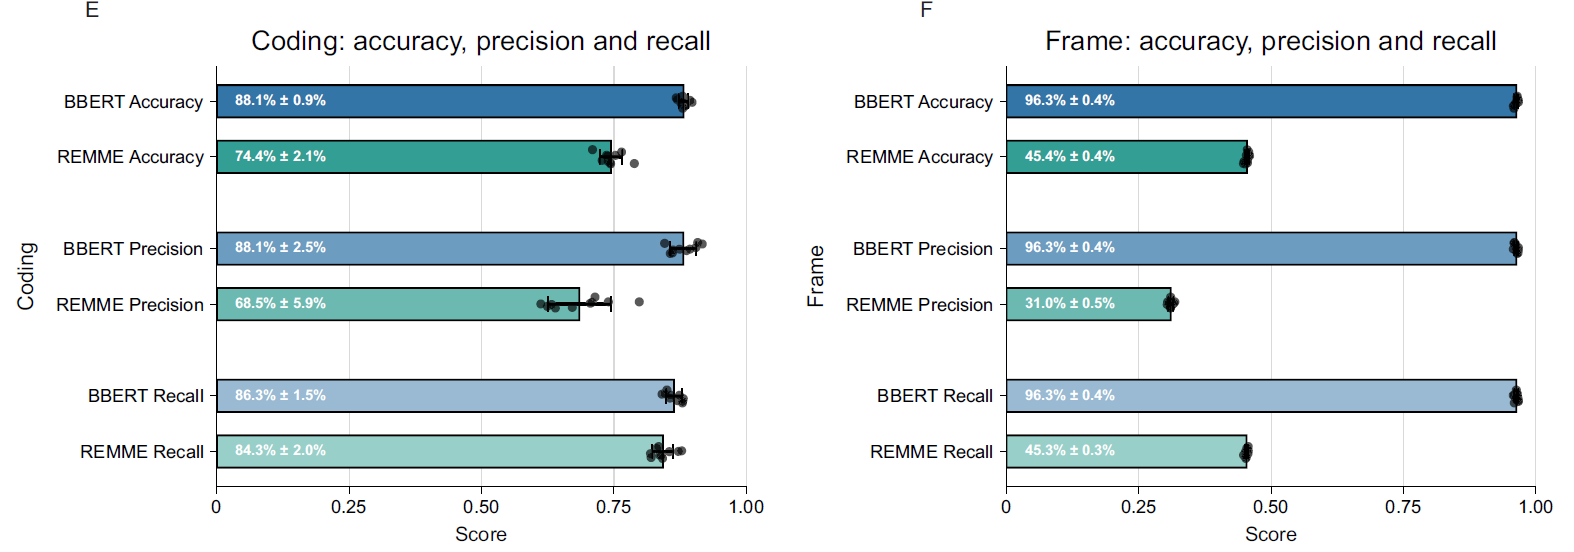
在识别编码序列及其阅读框方面,BBERT 的性能优于 REMME,后者是唯一具有此功能的同类工具(下图 E,编码准确率:BBERT 为 88.1% ± 0.9%,REMME 为 74.4% ± 2.1%;下图 F,阅读框准确率:BBERT 为 96.3% ± 0.3%,REMME 为 45.4% ± 0.4%)。
在计算性能方面,BBERT 也展现出较好的实用性。 BBERT 在配备专用 NVIDIA H200 GPU 的计算节点上,每秒可处理 45,912 条读段(reads per second,rps),而 BERTax 和 Tiara 分别为 413 rps 和 347 rps。不过,经过代码优化后的 REMME 速度略快,达到 50,745 rps。在搭载 NVIDIA RTX 3090 GPU 的 Windows 10 个人电脑上运行时,BBERT 的处理速度为 15,373 rps。这意味着,即使不依赖高性能计算集群,用户也能够使用 BBERT 开展分析,而大多数同类工具难以实现这一点。
② BBERT 是一种具有较高灵敏度的细菌识别工具
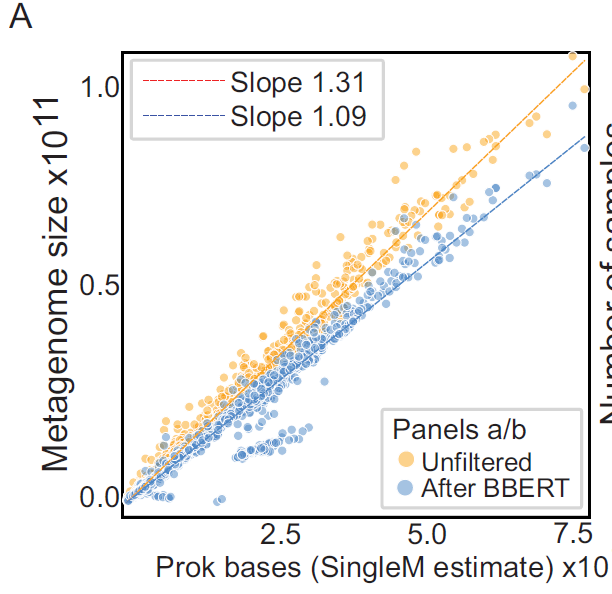
研究人员也将 BBERT 应用于整理得到的 1969 个公开土壤宏基因组数据集,采用 SingleM 估算的原核生物碱基数量作为参考,以进一步验证其在这些缺乏真实分类结果的实际数据上的表现。如下图所示,在未经筛选的情况下,宏基因组数据中的碱基总数比 SingleM 估算的原核生物碱基数高出 31%(斜率为1.31±0.01);经过 BBERT 筛选后,这一差距缩小至 9%(斜率为1.09±0.01)。
与 SingleM 不同,Kraken2 支持在单条读段层面进行比较,因此研究人员还将 BBERT 与 Kraken2 进行了直接对比。结果显示:对于 Kraken2 已识别为细菌来源的读段,BBERT 的判定结果与之基本一致;与此同时,BBERT 还能够识别出相当一部分 Kraken2 无法分类的读段(如下图);反过来,Kraken2 能够识别、而 BBERT 未能识别的读段则非常少。
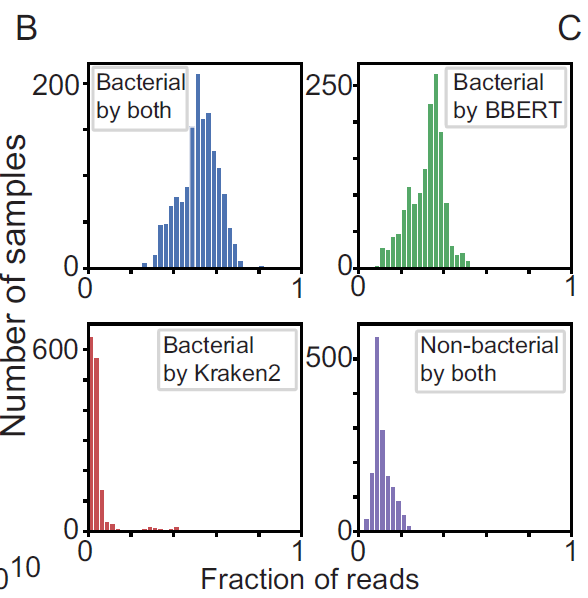
因此,BBERT 是一种具有较高灵敏度的细菌识别工具, 既能像 Kraken2 一样在读段层面进行分类,又不受参考数据库覆盖不完整的限制。
③ BBERT 可将短 DNA 读段直接翻译为氨基酸序列
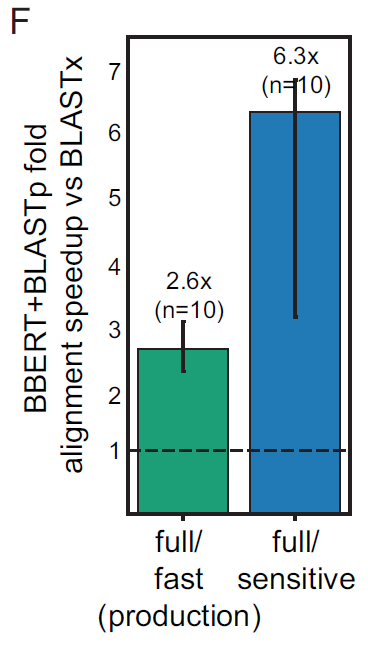
鉴于 BBERT 能够识别细菌来源的编码读段及其阅读框,因此也可以将短宏基因组读段直接翻译为氨基酸序列。 研究发现,与未经筛选的 DNA 读段采用 BLASTx 进行注释相比,这种方法能够获得基本一致的注释结果,但处理速度更快:在 fast 模式下提升约 2.6 倍,在 sensitive 模式下提升约 6.3 倍(如下图)。这意味着 BBERT 不仅可以帮助研究人员筛选数据,还可能进一步优化宏基因组功能注释流程。
④ BBERT加速宏基因组从头组装,并减少组装错误
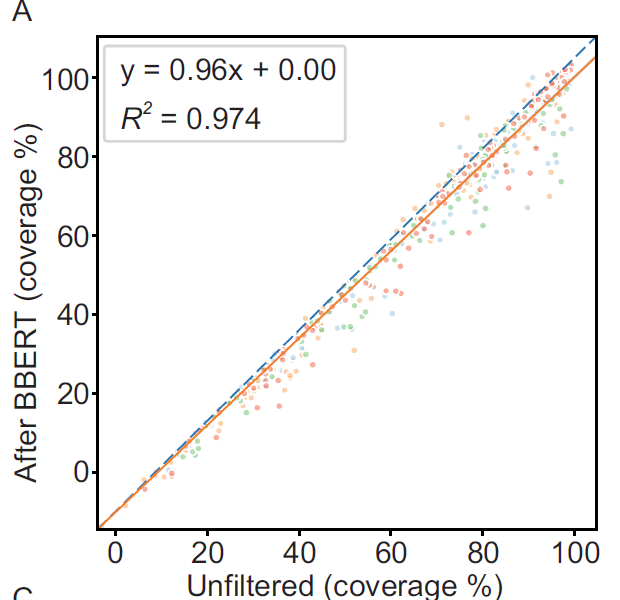
在宏基因组组装方面,BBERT的作用更加直观。 研究团队发现,在未经筛选的数据中,大量非目标序列会增加组装负担,并可能引入错误缺口和错配。对模拟宏基因组数据进行 BBERT 筛选后,细菌基因组覆盖率的非加权平均值由 68.23% 下降至 65.22%,覆盖率损失约 4.4%(如下图)。与此同时,组装时间由 66±8 小时缩短至 25±2 小时,效率提升约2.7倍。
组装准确性也得到改善。 以 512 个基因组的非加权平均值进行计算,并将各项指标按照参考基因组长度归一化,则可以发现:每 100 bp 参考序列中的缺口开启次数从 0.51 次降至 0.36 次,减少了 0.15 次,相对降幅为 29.3%;错配次数从 3.31 次降至 2.64 次,减少了 0.67 次,相对降幅为 20.2%。两项指标合计下降约21.4%。
⑤ 真实根瘤宏基因组数据
为了评估 BBERT 筛选在真实数据集中的潜在收益,研究人员进一步将其应用于豆科植物根瘤宏基因组数据。经过 BBERT 筛选后的联合组装结果体积缩小了 61%,从 577.6 Mb 降至 222.4 Mb;重叠群数量减少了 57%;GC 含量则从 40.4% 升至 58.5%。
这一变化与豆科植物基因组约 40% 的 GC 含量以及根瘤菌目基因组约 62% 的 GC 含量相符,表明被过滤掉的读段绝大多数来源于宿主。此外,BBERT 筛选使组装结果的 N50 值翻倍,从 0.9 kb 升至 1.8 kb,组装运行时间缩短了一半,同时峰值内存占用也从 188 GB 降至 82 GB。
结语
BBERT 展示了大语言模型处理短 DNA 序列的另一种可能:即使面对缺乏参考数据库支持的 100 bp 读段,也能通过学习序列本身的特征,完成分类域判定、编码潜力识别和阅读框预测。更重要的是,这种能力不仅可以用于识别宏基因组中的非目标序列,还能够进一步改善功能注释、基因组组装和分箱等下游流程。
研究也表明,BBERT 对可移动遗传元件等特殊序列的识别偏差,可能反映出这些序列与宿主基因组之间不同的进化特征。未来,大语言模型对独特 DNA 序列模式的敏感性,或许还能为追溯基因水平转移事件提供新的工具。随着相关模型持续发展,其应用有望从微生物分类扩展至更广泛的生态基因组学研究。
参考文献:
https://phys.org/news/2026-10-ai-tool-scientists-bacteria-hidden.html
https://academic.oup.com/nar/article/54/19/gkag1002/8971853?login=false