HyperAIHyperAI

Command Palette

Search for a command to run...

用于持续学习的快速权重注意力

摘要

循环快速权重记忆和选择性状态空间模型将不断扩展的上下文压缩为固定大小的循环状态,使状态转换成为一种在线学习规则。我们在写后读自回归语义下研究该规则。对于此处考虑的前缀预测目标,在步骤 t 处揭示的局部快速记忆示例是前缀对齐对 (xt,yt) = (ϕ(kt−1),vt)( \mathbf { x } _ { t } , \mathbf { y } _ { t } ) \ = \ ( \phi ( \mathbf { k } _ { t - 1 } ) , \mathbf { v } _ { t } )(xt​,yt​) = (ϕ(kt−1​),vt​)。常见的同一步关联 (ϕ(kt), vt) 仍然是因果的,但优化了不同的内部目标。我们推导了平方误差回归和负内积目标的归一化一阶更新。回归族包括 Falcon-1(标量 NLMS 更新)、Falcon-2(其逐列扩展)和 Falcon-3(滑动窗口小批量更新);Falcon-1A/Falcon-2A/Falcon-3A 是对应的内积变体。我们提供了循环、掩码并行和分块并行形式,以及数值稳定的正衰减重归一化。代表性变体在语言建模中保持竞争力,并在变长数字加法上改善了长度外推。该框架将循环序列模型中的时间对齐、可塑性、遗忘和有界排练分离开来。

一句话总结

来自字节跳动 Seed、普林斯顿大学、清华大学、加州大学洛杉矶分校和 Hyperbolic Labs 的研究者提出了一种用于持续学习的快权重注意力框架,该框架为平方误差回归和负内积目标推导了归一化一阶更新,引入了 Falcon-1/2/3\text{Falcon-1/2/3}Falcon-1/2/3 变体(及其内积对应版本 Falcon-1A/2A/3A\text{Falcon-1A/2A/3A}Falcon-1A/2A/3A),这些变体在语言建模中保持竞争力,并改善了变长数字加法任务上的长度外推能力。

核心贡献

  • 引入了一个统一的归一化快权重更新家族:Falcon-1/2/3 用于平方误差回归,Falcon-1A/2A/3A 用于负内积目标,这些更新在读写后置的自回归语义下推导,使用前缀对齐的因果配对 (ϕ(kt−1),vt)(\phi(k_{t-1}), v_t)(ϕ(kt−1​),vt​)。
  • 提供了循环、掩码并行和分块并行实现,具有数值稳定的正衰减重归一化,将时间对齐、可塑性、遗忘和有界排练分离,同时保持与 SSD 风格分块并行训练的兼容性。
  • 展示了具有代表性的标量回归和标量/滑动内积变体在语言建模中保持竞争力,且最佳内积变体改善了变长数字加法上的长度外推能力。

引言

Transformer 主导现代语言建模,因为自注意力能够捕获全局依赖关系,但其序列长度的二次方缩放带来了计算和内存方面的主要瓶颈,尤其是在长上下文场景中。诸如 SSM 和快权重模型之类的循环替代方案将内存压缩为固定状态,但其状态更新规则往往在架构层面呈现,使得底层学习目标隐含不清。这种模糊性导致了时间对齐不匹配:许多循环机制绑定同一步配对(键,值),而自回归预测要求将新揭示的目标与预测时可用的前缀特征配对,这一区别影响了快内存的训练方式。

作者通过将基于状态的序列建模重新定义为自回归下一潜在变量预测来解决这一问题,使快内存训练目标显式化。他们推导了一个统一的归一化一阶更新家族,即 Falcon-1、Falcon-2 和 Falcon-3,以及内积对应版本 Falcon-1A、Falcon-2A 和 Falcon-3A,这些更新分离了时间对齐、可塑性、遗忘和有界排练。这些更新保持与分块并行训练的兼容性,作者提供了实现和实证评估,展示了有竞争力的语言建模性能和改进的算术长度外推能力。
方法

2 背景

2.2 线性注意力

线性注意力通过用核特征映射 ϕ(⋅):Rd→Rm\phi(\cdot): \mathbb{R}^d \to \mathbb{R}^mϕ(⋅):Rd→Rm 替代 softmax 来规避标准注意力的 O(N2)O(N^2)O(N2) 复杂度,使得 κ(qt,kj)=ϕ(qt)⊤ϕ(kj)\kappa(\mathbf{q}_t, \mathbf{k}_j) = \phi(\mathbf{q}_t)^\top \phi(\mathbf{k}_j)κ(qt​,kj​)=ϕ(qt​)⊤ϕ(kj​)。利用矩阵乘法的结合性,第 ttt 个 token 的输出 ot∈Rdv\mathbf{o}_t \in \mathbb{R}^{d_v}ot​∈Rdv​ 为:

ot=∑j=1tϕ(qt)⊤ϕ(kj)vj∑j=1tϕ(qt)⊤ϕ(kj)=(∑j=1tϕ(kj)vj⊤)⊤ϕ(qt)ϕ(qt)⊤∑j=1tϕ(kj),\mathbf{o}_t = \frac{\sum_{j=1}^t \phi(\mathbf{q}_t)^\top \phi(\mathbf{k}_j) \mathbf{v}_j}{\sum_{j=1}^t \phi(\mathbf{q}_t)^\top \phi(\mathbf{k}_j)} = \frac{\left(\sum_{j=1}^t \phi(\mathbf{k}_j) \mathbf{v}_j^\top\right)^\top \phi(\mathbf{q}_t)}{\phi(\mathbf{q}_t)^\top \sum_{j=1}^t \phi(\mathbf{k}_j)},ot​=∑j=1t​ϕ(qt​)⊤ϕ(kj​)∑j=1t​ϕ(qt​)⊤ϕ(kj​)vj​​=ϕ(qt​)⊤∑j=1t​ϕ(kj​)(∑j=1t​ϕ(kj​)vj⊤​)⊤ϕ(qt​)​,

该公式允许将上下文压缩为循环矩阵状态 St∈Rm×dv\mathbf{S}_t \in \mathbb{R}^{m \times d_v}St​∈Rm×dv​ 和归一化器 zt∈Rm\mathbf{z}_t \in \mathbb{R}^mzt​∈Rm:

ot=St⊤ϕ(qt)zt⊤ϕ(qt)+εattn,St=St−1+ϕ(kt)vt⊤,zt=zt−1+ϕ(kt).\mathbf{o}_t = \frac{\mathbf{S}_t^\top \phi(\mathbf{q}_t)}{\mathbf{z}_t^\top \phi(\mathbf{q}_t) + \varepsilon_{\mathrm{attn}}}, \quad \mathbf{S}_t = \mathbf{S}_{t-1} + \phi(\mathbf{k}_t) \mathbf{v}_t^\top, \quad \mathbf{z}_t = \mathbf{z}_{t-1} + \phi(\mathbf{k}_t).ot​=zt⊤​ϕ(qt​)+εattn​St⊤​ϕ(qt​)​,St​=St−1​+ϕ(kt​)vt⊤​,zt​=zt−1​+ϕ(kt​).

对于新序列,当 S0=0\mathbf{S}_0 = \mathbf{0}S0​=0、z0=0\mathbf{z}_0 = \mathbf{0}z0​=0、εattn=0\varepsilon_{\mathrm{attn}} = 0εattn​=0 且分母非零时,式 (2.2) 与式 (2.1) 完全等价。当 εattn>0\varepsilon_{\mathrm{attn}} > 0εattn​>0 时,这是通常的稳定正特征变体。归一化形式仅在读取归一化器非负时才具有注意力类似的形式;有符号特征的注意事项见附录 C.2。

因果性与索引。 式 (2.2) 遵循标准 Transformer 约定:在位置 ttt,从更新后的状态 (St,zt)(\mathbf{S}_t, \mathbf{z}_t)(St​,zt​) 读取,所得表示用于预测 token t+1t+1t+1。作者的下一潜在变量对齐将写入流偏移一位:在观察到 vt\mathbf{v}_tvt​ 后,将其写入前一个写入特征 ϕ(kt−1)\phi(\mathbf{k}_{t-1})ϕ(kt−1​) 之下,等价地,在标准索引下为 (ϕ(ki),vi+1)(\phi(\mathbf{k}_i), \mathbf{v}_{i+1})(ϕ(ki​),vi+1​),其中 i=t−1i = t-1i=t−1。这产生了读写后置的循环:

ot=St⊤ϕ(qt)zt⊤ϕ(qt)+εattn,St=St−1+ϕ(kt−1)vt⊤,zt=zt−1+ϕ(kt−1),\mathbf{o}_t = \frac{\mathbf{S}_t^\top \phi(\mathbf{q}_t)}{\mathbf{z}_t^\top \phi(\mathbf{q}_t) + \varepsilon_{\mathrm{attn}}}, \quad \mathbf{S}_t = \mathbf{S}_{t-1} + \phi(\mathbf{k}_{t-1}) \mathbf{v}_t^\top, \quad \mathbf{z}_t = \mathbf{z}_{t-1} + \phi(\mathbf{k}_{t-1}),ot​=zt⊤​ϕ(qt​)+εattn​St⊤​ϕ(qt​)​,St​=St−1​+ϕ(kt−1​)vt⊤​,zt​=zt−1​+ϕ(kt−1​),

其中 εattn≥0\varepsilon_{\mathrm{attn}} \geq 0εattn​≥0 是一个小的稳定化常数。定义偏移后的写入特征流:

x~1:=0,x~t:=ϕ(kt−1)for t≥2,\widetilde{\mathbf{x}}_1 := \mathbf{0}, \qquad \widetilde{\mathbf{x}}_t := \phi(\mathbf{k}_{t-1}) \quad \text{for } t \geq 2,x1​:=0,xt​:=ϕ(kt−1​)for t≥2,

当 εattn=0\varepsilon_{\mathrm{attn}} = 0εattn​=0 时,式 (2.3) 与式 (2.2) 完全相同,只需将标准写入特征流 {ϕ(kt)}t=1T\{\phi(\mathbf{k}_t)\}_{t=1}^T{ϕ(kt​)}t=1T​ 替换为 {x~t}t=1T\{\widetilde{\mathbf{x}}_t\}_{t=1}^T{xt​}t=1T​;当 εattn>0\varepsilon_{\mathrm{attn}} > 0εattn​>0 时,这是对应的稳定化偏移变体。因此,边界条件在特征空间中施加,而非在原始键空间中。

归一化与非归一化线性注意力。 式 (2.1) 中的分母使用归一化器状态 zt\mathbf{z}_tzt​ 来重新缩放读取输出。许多 SSM/SSD 风格架构则丢弃分母(以及 zt\mathbf{z}_tzt​),使用非归一化的内积读取:

ot=St⊤ϕ(qt),St=(1−ηtλt)St−1+ηtϕ(kt−1)vt⊤,\mathbf{o}_t = \mathbf{S}_t^\top \phi(\mathbf{q}_t), \quad \mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \phi(\mathbf{k}_{t-1}) \mathbf{v}_t^\top,ot​=St⊤​ϕ(qt​),St​=(1−ηt​λt​)St−1​+ηt​ϕ(kt−1​)vt⊤​,

通过将 kt−1\mathbf{k}_{t-1}kt−1​ 替换为 kt\mathbf{k}_tkt​ 可恢复非偏移约定。在这种无分母形式中,状态幅度和有效内存时间尺度由显式衰减(例如 λt>0\lambda_t > 0λt​>0)和/或增益控制来管理。第 4.3 节表明,式 (2.4) 中的分子状态更新正是内积目标上的梯度下降。归一化变体中的辅助归一化器 zt\mathbf{z}_tzt​ 是读取分母的独立簿记状态;它本身并非由该目标获得。

相应地,式 (2.4) 是第 4.3 节内积目标的梯度下降更新。当 λt=0\lambda_t = 0λt​=0 时,写入是纯加性的秩一 Hebbian 学习;当 λt>0\lambda_t > 0λt​>0 时,是加性加标量收缩。如第 2.1 节所述,Mamba-2 证明了无归一化器循环在 SSD 框架下功能上等价于特定类别的 SSM。

2.3 Delta 网络

快权重编程器和 Delta 网络将序列建模表述为值检索函数的在线学习。设 St−1∈Rd×dv\mathbf{S}_{t-1} \in \mathbb{R}^{d \times d_v}St−1​∈Rd×dv​ 为快权重状态矩阵。标准 Delta 网络不是纯加性累积,而是采用由状态对当前键和值的重建之间的瞬时平方误差梯度推导的误差驱动更新:

ℓt(S):=12∥S⊤kt−vt∥22.\ell_t(\mathbf{S}) := \frac{1}{2} \left\| \mathbf{S}^\top \mathbf{k}_t - \mathbf{v}_t \right\|_2^2.ℓt​(S):=21​​S⊤kt​−vt​​22​.

这里,S⊤k\mathbf{S}^\top \mathbf{k}S⊤k 表示模型在给定键 k\mathbf{k}k 时对值 vt\mathbf{v}_tvt​ 的预测。关于状态的梯度为 ∇Sℓt(S)=kt(S⊤kt−vt)⊤\nabla_{\mathbf{S}} \ell_t(\mathbf{S}) = \mathbf{k}_t \left( \mathbf{S}^\top \mathbf{k}_t - \mathbf{v}_t \right)^\top∇S​ℓt​(S)=kt​(S⊤kt​−vt​)⊤。

Delta 规则。 用 ηt\eta_tηt​ 表示梯度步长;后续 βt\beta_tβt​ 表示无量纲归一化增益,ηt\eta_tηt​ 表示由此产生的步长。单步在线梯度更新为:

St=St−1−ηtkt(St−1⊤kt−vt)⊤=(I−ηtktkt⊤)St−1+ηtktvt⊤.\mathbf{S}_t = \mathbf{S}_{t-1} - \eta_t \mathbf{k}_t (\mathbf{S}_{t-1}^\top \mathbf{k}_t - \mathbf{v}_t)^\top = (\mathbf{I} - \eta_t \mathbf{k}_t \mathbf{k}_t^\top) \mathbf{S}_{t-1} + \eta_t \mathbf{k}_t \mathbf{v}_t^\top.St​=St−1​−ηt​kt​(St−1⊤​kt​−vt​)⊤=(I−ηt​kt​kt⊤​)St−1​+ηt​kt​vt⊤​.

秩一因子沿当前键方向执行定向收缩/编辑;仅当 ηt=1/∥kt∥22\eta_t = 1 / \|\mathbf{k}_t\|_2^2ηt​=1/∥kt​∥22​ 时才成为正交投影。门控 Delta 网络增加了显式的全局衰减门;符号和比较细节见附录 C.3。

3 自回归下一潜在变量预测

在本节中,作者将循环写入表述为显式的在线优化问题。在读写后置约定下,第 ttt 步揭示的因果示例将新观察到的目标与预测该目标时可用的前缀写入特征配对,即 xt=ϕ(kt−1)\mathbf{x}_t = \phi(\mathbf{k}_{t-1})xt​=ϕ(kt−1​) 和 yt=vt\mathbf{y}_t = \mathbf{v}_tyt​=vt​。标准 DeltaNet 使用同一步配对 (ϕ(kt),vt)(\phi(\mathbf{k}_t), \mathbf{v}_t)(ϕ(kt​),vt​);该配对仍然是因果的,但对应于不同的局部快内存目标。因此,作者将 S\mathbf{S}S 建模为从 xt\mathbf{x}_txt​ 到 yt\mathbf{y}_tyt​ 的在线线性预测器,并优化瞬时岭回归损失:

ℓt(S)≜12∥S⊤xt−yt∥22+λt2∥S∥F2,\ell_t(\mathbf{S}) \triangleq \frac{1}{2} \left\| \mathbf{S}^\top \mathbf{x}_t - \mathbf{y}_t \right\|_2^2 + \frac{\lambda_t}{2} \|\mathbf{S}\|_F^2,ℓt​(S)≜21​​S⊤xt​−yt​​22​+2λt​​∥S∥F2​,

其中 λt≥0\lambda_t \geq 0λt​≥0 是正则化系数。虽然累积损失的完整批次最小化对应于 MesaNet 等方法中的离线解,但高效的自回归建模需要在线近似。因此,作者采用在线梯度下降(OGD)。

符号说明。 在核化线性注意力中,写入内存的键通常是特征向量 ϕ(k)∈Rm\phi(\mathbf{k}) \in \mathbb{R}^mϕ(k)∈Rm 而非原始键 k∈Rd\mathbf{k} \in \mathbb{R}^dk∈Rd。本节中的所有推导均按以下方式解释:

xt≡ϕ(kt−1)∈Rm,St∈Rm×dv,\mathbf{x}_t \equiv \phi(\mathbf{k}_{t-1}) \in \mathbb{R}^m, \qquad \mathbf{S}_t \in \mathbb{R}^{m \times d_v},xt​≡ϕ(kt−1​)∈Rm,St​∈Rm×dv​,

因此 xt\mathbf{x}_txt​ 被视为通用写入特征。用于检索的查询(例如线性注意力中的 ϕ(qt)\phi(\mathbf{q}_t)ϕ(qt​))位于同一特征空间中,但不必等于 xt\mathbf{x}_txt​。当摘要句非正式地提及原始键空间中的配对时,数学上精确的核化对象是对应的写入特征。

隐式快内存目标。 式 (3.1) 是瞬时目标,其梯度步定义了快内存写入规则;它不是外层自回归似然之外的额外监督损失。在训练期间,作者通过更新进行微分,使得慢权重(产生 (q,k,v)(\mathbf{q}, \mathbf{k}, \mathbf{v})(q,k,v) 以及 βt,λt\beta_t, \lambda_tβt​,λt​)学习使这些局部更新有用的表示和门控。

索引与因果性约定。 全程使用读写后置(RAW)约定:在观察到 token ttt 并写入后,读取更新后的状态 St\mathbf{S}_tSt​ 以预测 token t+1t+1t+1。在下一潜在变量对齐下,因果写入对为 (ϕ(kt−1),vt)(\phi(\mathbf{k}_{t-1}), \mathbf{v}_t)(ϕ(kt−1​),vt​),等价地,在标准索引下为 (ϕ(ki),vi+1)(\phi(\mathbf{k}_i), \mathbf{v}_{i+1})(ϕ(ki​),vi+1​)。作者设置 S0=0\mathbf{S}_0 = \mathbf{0}S0​=0 并施加特征空间边界 x1:=0\mathbf{x}_1 := \mathbf{0}x1​:=0。对于具有显式收缩的更新规则,边界哨兵也分配 η1:=0\eta_1 := 0η1​:=0(等价地,在对数空间符号中 α1=0,γ1=1\alpha_1 = 0, \gamma_1 = 1α1​=0,γ1​=1);否则 λ1>0\lambda_1 > 0λ1​>0 会衰减携带的状态,即使没有写入数据对。详细的 RAW/RBW 和边界约定见附录 C.5。

在此约定下,内部快内存预测为 y^t:=St−1⊤xt\widehat{\mathbf{y}}_t := \mathbf{S}_{t-1}^\top \mathbf{x}_ty​t​:=St−1⊤​xt​,残差为 rt=yt−y^t\mathbf{r}_t = \mathbf{y}_t - \widehat{\mathbf{y}}_trt​=yt​−y​t​。这与位置 ttt 处的模型读出不同,后者在 RAW 下使用更新后的状态 St\mathbf{S}_tSt​。

快内存作为持续学习。 循环状态是在前向传播中更新的快内存;每个 token 提供一个局部训练对 (xt,yt)(\mathbf{x}_t, \mathbf{y}_t)(xt​,yt​)。在整个家族中,βt\beta_tβt​ 控制可塑性,λt\lambda_tλt​ 控制收缩/遗忘;实际实现的 ηt\eta_tηt​ 取决于局部归一化统计量,该统计量对于回归是平滑度匹配的,对于内积实现是基于能量的。

3.1 在线梯度下降更新

式 (3.1) 中瞬时损失关于状态 S\mathbf{S}S 的梯度为:

∇Sℓt(S)=xt(S⊤xt−yt)⊤+λtS.\nabla_{\mathbf{S}} \ell_t(\mathbf{S}) = \mathbf{x}_t (\mathbf{S}^\top \mathbf{x}_t - \mathbf{y}_t)^\top + \lambda_t \mathbf{S}.∇S​ℓt​(S)=xt​(S⊤xt​−yt​)⊤+λt​S.

以学习率 ηt\eta_tηt​ 应用单步梯度下降得到更新规则:

St←St−1−ηt∇Sℓt(St−1)=St−1−ηt[xt(St−1⊤xt−yt)⊤+λtSt−1]=(1−ηtλt)St−1+ηtxtrt⊤,\begin{aligned} \mathbf{S}_t &\leftarrow \mathbf{S}_{t-1} - \eta_t \nabla_{\mathbf{S}} \ell_t(\mathbf{S}_{t-1}) \\ &= \mathbf{S}_{t-1} - \eta_t \left[ \mathbf{x}_t (\mathbf{S}_{t-1}^\top \mathbf{x}_t - \mathbf{y}_t)^\top + \lambda_t \mathbf{S}_{t-1} \right] \\ &= (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{r}_t^\top, \end{aligned}St​​←St−1​−ηt​∇S​ℓt​(St−1​)=St−1​−ηt​[xt​(St−1⊤​xt​−yt​)⊤+λt​St−1​]=(1−ηt​λt​)St−1​+ηt​xt​rt⊤​,​

其中 rt≜yt−St−1⊤xt\mathbf{r}_t \triangleq \mathbf{y}_t - \mathbf{S}_{t-1}^\top \mathbf{x}_trt​≜yt​−St−1⊤​xt​ 是残差(预测误差)。注意,与标准 Delta 网络不同,rt\mathbf{r}_trt​ 衡量的是从前一个写入特征 xt=ϕ(kt−1)\mathbf{x}_t = \phi(\mathbf{k}_{t-1})xt​=ϕ(kt−1​) 的预测与当前值 vt\mathbf{v}_tvt​ 之间的差异。

这是瞬时岭目标上的梯度下降。使用下面的归一化步长后,它变为归一化更新。在特殊情况 λt=0\lambda_t = 0λt​=0 和 ε=0\varepsilon = 0ε=0 下,它精确退化为经典 NLMS 递归;当 ε>0\varepsilon > 0ε>0 时,是通常的稳定化 NLMS 变体。具体而言,损失 ℓt\ell_tℓt​ 关于 Frobenius 范数是 LtL_tLt​-光滑的,光滑常数为 Lt=∥xt∥22+λtL_t = \|\mathbf{x}_t\|_2^2 + \lambda_tLt​=∥xt​∥22​+λt​。为确保数值稳定性和尺度鲁棒性,作者采用归一化步长:

ηt=βt∥xt∥22+λt+ε,βt∈(0,2),ε≥0.\eta_t = \frac{\beta_t}{\|\mathbf{x}_t\|_2^2 + \lambda_t + \varepsilon}, \quad \beta_t \in (0, 2), \varepsilon \geq 0.ηt​=∥xt​∥22​+λt​+εβt​​,βt​∈(0,2),ε≥0.

作者约定当 ∥xt∥22+λt+ε=0\|\mathbf{x}_t\|_2^2 + \lambda_t + \varepsilon = 0∥xt​∥22​+λt​+ε=0 时 ηt:=0\eta_t := 0ηt​:=0,并且在边界哨兵 t=1t = 1t=1 处使用 x1=0\mathbf{x}_1 = \mathbf{0}x1​=0 表示"无因果对"时同样如此。在分析中,可取 ε=0\varepsilon = 0ε=0 并假设 Lt>0L_t > 0Lt​>0。在实现中,使用 ε>0\varepsilon > 0ε>0 以保证数值鲁棒性;任何 ε>0\varepsilon > 0ε>0 只会减小 ηt\eta_tηt​,因此保留下面的下降保证。

附录 C.6 记录了次要实现细节,包括 βt>1\beta_t > 1βt​>1 的符号翻转区间和对数空间展开下岭收缩的正衰减解释。

3.2 分析

作者证明了归一化步长在瞬时正则化目标 ℓt\ell_tℓt​ 上产生每步下降,这是一个基本的局部稳定性性质。该陈述在 ttt 上是逐点的:它不意味着累积在线损失 ∑sℓs\sum_s \ell_s∑s​ℓs​ 或外层自回归训练目标的单调递减。

引理 3.1(光滑损失的每步下降)。 设 f:Rdx×dv→Rf: \mathbb{R}^{d_x \times d_v} \to \mathbb{R}f:Rdx​×dv​→R 关于 Frobenius 范数是 LLL-光滑的。对于任意步长 η∈(0,2/L)\eta \in (0, 2/L)η∈(0,2/L),梯度步 S+=S−η∇f(S)\mathbf{S}^+ = \mathbf{S} - \eta \nabla f(\mathbf{S})S+=S−η∇f(S) 满足:

f(S+)≤f(S)−η(2−ηL)2∥∇f(S)∥F2.f(\mathbf{S}^+) \leq f(\mathbf{S}) - \frac{\eta (2 - \eta L)}{2} \|\nabla f(\mathbf{S})\|_F^2.f(S+)≤f(S)−2η(2−ηL)​∥∇f(S)∥F2​.

证明。 由 LLL-光滑性,对于任意 S\mathbf{S}S 和 S′\mathbf{S}'S′:

f(S′)≤f(S)+⟨∇f(S),S′−S⟩+L2∥S′−S∥F2.f(\mathbf{S}') \leq f(\mathbf{S}) + \langle \nabla f(\mathbf{S}), \mathbf{S}' - \mathbf{S} \rangle + \frac{L}{2} \|\mathbf{S}' - \mathbf{S}\|_F^2.f(S′)≤f(S)+⟨∇f(S),S′−S⟩+2L​∥S′−S∥F2​.

令 S′=S+=S−η∇f(S)\mathbf{S}' = \mathbf{S}^+ = \mathbf{S} - \eta \nabla f(\mathbf{S})S′=S+=S−η∇f(S) 并化简。

步长参数化。 选择 η=β/L\eta = \beta / Lη=β/L 且 β∈(0,2)\beta \in (0, 2)β∈(0,2)(因此要求 L>0L > 0L>0)产生下降系数 β(2−β)/(2L)\beta (2 - \beta) / (2L)β(2−β)/(2L)。对于 L>0L > 0L>0,稳定化选择 η=β/(L+ε)\eta = \beta / (L + \varepsilon)η=β/(L+ε) 且 ε≥0\varepsilon \geq 0ε≥0 也位于 (0,2/L)(0, 2/L)(0,2/L) 内。当 L=0L = 0L=0 时,该区间未定义;在此处出现的退化情况中(xt=0\mathbf{x}_t = \mathbf{0}xt​=0 且 λt=0\lambda_t = 0λt​=0,或对应的窗口化类似物),梯度为零,因此通过设置 η:=0\eta := 0η:=0 将更新定义为无操作。

3.3 Delta 网络作为回归

在本节中,作者在此优化框架下解释许多先前的快权重模型。他们观察到 Delta 网络和线性注意力可以视为由特定在线目标函数诱导的梯度更新。

通过代入回归赋值 xt←ϕ(kt−1)\mathbf{x}_t \gets \phi(\mathbf{k}_{t-1})xt​←ϕ(kt−1​) 和 yt←vt\mathbf{y}_t \gets \mathbf{v}_tyt​←vt​,式 (3.3) 恢复了 Delta 网络更新规则的函数形式,但具有关键的索引偏移:

St=((1−ηtλt)Idx−ηtxtxt⊤)⏟Decay & Targeted ForgetSt−1+ηtxtyt⊤⏟Write,xt=ϕ(kt−1),yt=vt.\mathbf{S}_t = \underbrace{\left((1 - \eta_t \lambda_t) \mathbf{I}_{d_x} - \eta_t \mathbf{x}_t \mathbf{x}_t^\top\right)}_{\text{Decay \& Targeted Forget}} \mathbf{S}_{t-1} + \underbrace{\eta_t \mathbf{x}_t \mathbf{y}_t^\top}_{\text{Write}}, \quad \mathbf{x}_t = \phi(\mathbf{k}_{t-1}), \mathbf{y}_t = \mathbf{v}_t.St​=Decay & Targeted Forget((1−ηt​λt​)Idx​​−ηt​xt​xt⊤​)​​St−1​+Writeηt​xt​yt⊤​​​,xt​=ϕ(kt−1​),yt​=vt​.

这里,秩一项 xtxt⊤St−1\mathbf{x}_t \mathbf{x}_t^\top \mathbf{S}_{t-1}xt​xt⊤​St−1​ 是平方误差损失沿当前写入特征方向的左 Hessian 作用。直观上,它在添加新目标 yt=vt\mathbf{y}_t = \mathbf{v}_tyt​=vt​ 之前减少了当前预测器作用于 xt=ϕ(kt−1)\mathbf{x}_t = \phi(\mathbf{k}_{t-1})xt​=ϕ(kt−1​) 的分量。

相反,将回归(MSE)损失替换为第 4.3 节的内积目标会移除残差项并产生加性写入。使用标准的非偏移赋值 (xt,yt)=(ϕ(kt),vt)(\mathbf{x}_t, \mathbf{y}_t) = (\phi(\mathbf{k}_t), \mathbf{v}_t)(xt​,yt​)=(ϕ(kt​),vt​)(或非核化情况下的 (kt,vt)(\mathbf{k}_t, \mathbf{v}_t)(kt​,vt​)),这就是熟悉的线性注意力/Mamba-2 累积。使用下一潜在变量赋值 (xt,yt)=(ϕ(kt−1),vt)(\mathbf{x}_t, \mathbf{y}_t) = (\phi(\mathbf{k}_{t-1}), \mathbf{v}_t)(xt​,yt​)=(ϕ(kt−1​),vt​),它变为作者方法中使用的一步偏移变体(例如第 4.5 节的 Falcon-3A)。

这种回归视角激发了一个关键的算法改进,作者在第 4 节中分析:使用目标匹配的归一化时,秩一回归步使用 Lt=∥xt∥22+λtL_t = \|\mathbf{x}_t\|_2^2 + \lambda_tLt​=∥xt​∥22​+λt​,而滑动规则使用 Lt(B)=λmax⁡(Cˉt(B))+λtL_t^{(B)} = \lambda_{\max}(\bar{\mathbf{C}}_t^{(B)}) + \lambda_tLt(B)​=λmax​(Cˉt(B)​)+λt​。这表明固定学习率对于回归风格快权重更新是尺度不匹配的;对于内积写入,相同的归一化更适合视为幅度稳定器而非曲率要求。

附录 A.2 给出了顺序一阶在线岭更新的参考伪代码。

4 Falcon:快权重注意力

快权重内存和线性注意力架构可以解释为在前向传播期间更新循环内存的在线模型,可追溯到经典的快权重机制及其在线性 Transformer 和 Delta 风格规则中的现代实例化。在本节中,作者在偏移的 ϕ(kt−1)vt\phi(\mathbf{k}_{t-1}) \mathbf{v}_tϕ(kt−1​)vt​ 对齐下从两个局部目标推导 Falcon:平方误差回归和负内积目标。这产生了归一化步长、显式遗忘控制和滑动窗口变体。

命名和公式总结。 所有变体使用相同的因果对:

xt:=ϕ(kt−1),yt:=vt,x1:=0,η1:=0,\mathbf{x}_t := \phi(\mathbf{k}_{t-1}), \qquad \mathbf{y}_t := \mathbf{v}_t, \qquad \mathbf{x}_1 := \mathbf{0}, \qquad \eta_1 := 0,xt​:=ϕ(kt−1​),yt​:=vt​,x1​:=0,η1​:=0,

并在写入后读取,ot=St⊤ϕ(qt)\mathbf{o}_t = \mathbf{S}_t^\top \phi(\mathbf{q}_t)ot​=St⊤​ϕ(qt​)。设 rt:=yt−St−1⊤xt\mathbf{r}_t := \mathbf{y}_t - \mathbf{S}_{t-1}^\top \mathbf{x}_trt​:=yt​−St−1⊤​xt​,Diag(ηt)\mathrm{Diag}(\boldsymbol{\eta}_t)Diag(ηt​) 表示逐列步长的对角矩阵。回归家族为:

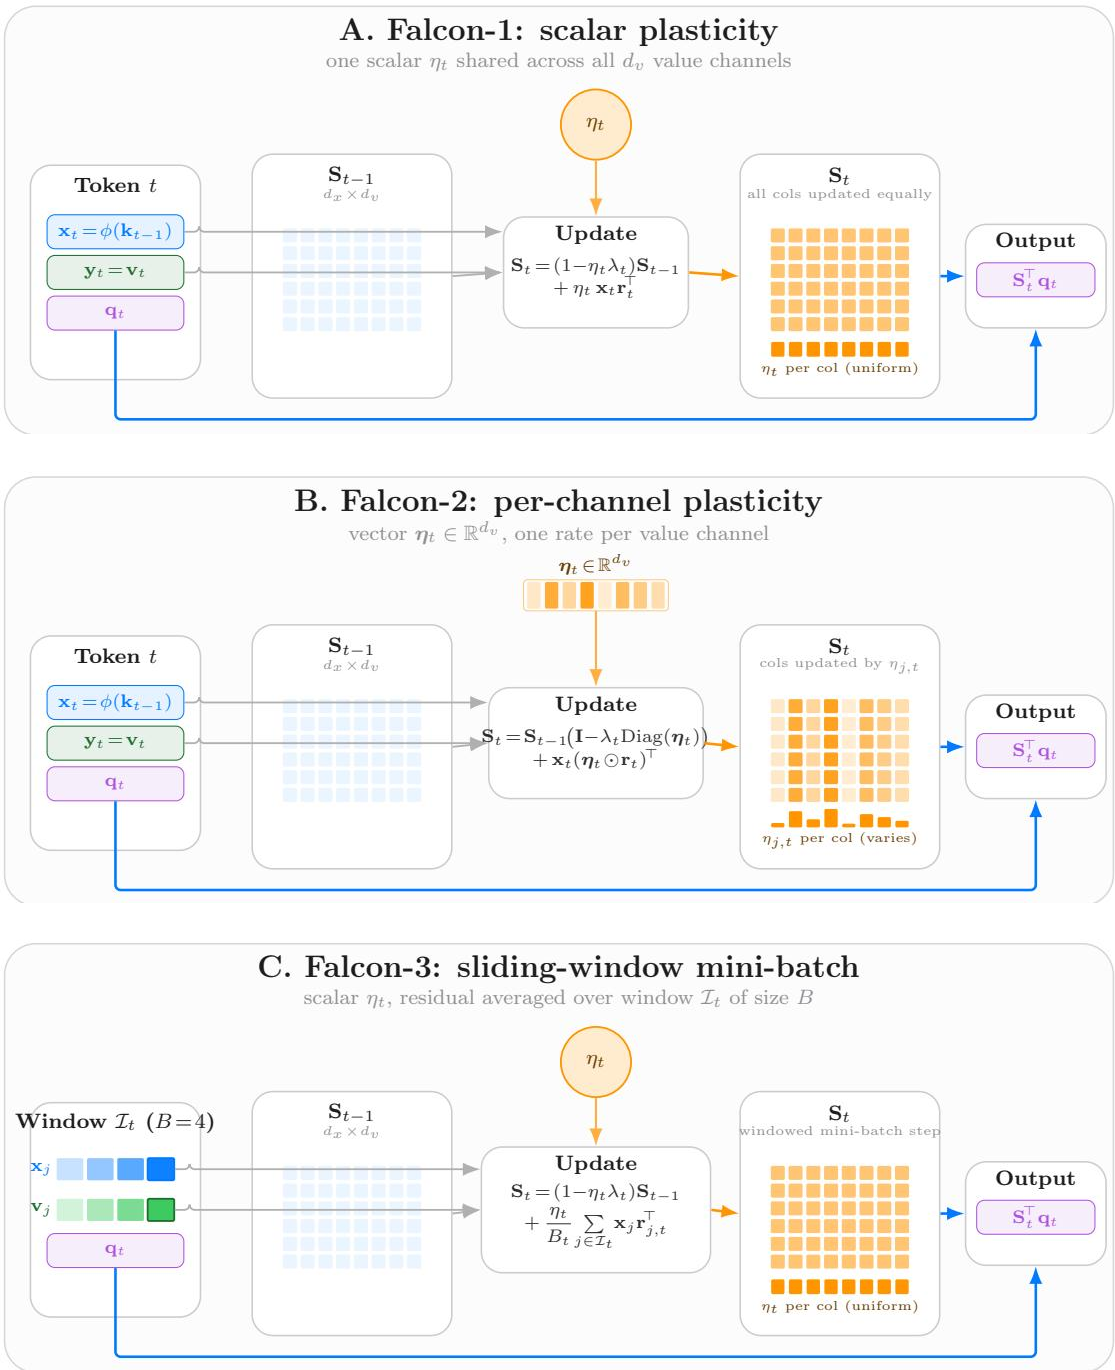
Falcon-1:St=(1−ηtλt)St−1+ηtxtrt⊤,ηt=βt∥xt∥22+λt+ε,\text{Falcon-1:} \quad \mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{r}_t^\top, \quad \eta_t = \frac{\beta_t}{\|\mathbf{x}_t\|_2^2 + \lambda_t + \varepsilon},Falcon-1:St​=(1−ηt​λt​)St−1​+ηt​xt​rt⊤​,ηt​=∥xt​∥22​+λt​+εβt​​, Falcon-2:St=St−1(Idv−λtDiag(ηt))+xt(ηt⊙rt)⊤,ηj,t=βj,t∥xt∥22+λt+ε,\text{Falcon-2:} \quad \mathbf{S}_t = \mathbf{S}_{t-1} (\mathbf{I}_{d_v} - \lambda_t \mathrm{Diag}(\boldsymbol{\eta}_t)) + \mathbf{x}_t (\boldsymbol{\eta}_t \odot \mathbf{r}_t)^\top, \quad \eta_{j,t} = \frac{\beta_{j,t}}{\|\mathbf{x}_t\|_2^2 + \lambda_t + \varepsilon},Falcon-2:St​=St−1​(Idv​​−λt​Diag(ηt​))+xt​(ηt​⊙rt​)⊤,ηj,t​=∥xt​∥22​+λt​+εβj,t​​, Falcon-3:St=(1−ηtλt)St−1+ηtBt∑j∈Itxj(yj−St−1⊤xj)⊤,ηt=βtμt(B)+λt+ε.\text{Falcon-3:} \quad \mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \frac{\eta_t}{B_t} \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \left(\mathbf{y}_j - \mathbf{S}_{t-1}^\top \mathbf{x}_j\right)^\top, \quad \eta_t = \frac{\beta_t}{\mu_t^{(B)} + \lambda_t + \varepsilon}.Falcon-3:St​=(1−ηt​λt​)St−1​+Bt​ηt​​j∈It​∑​xj​(yj​−St−1⊤​xj​)⊤,ηt​=μt(B)​+λt​+εβt​​.

这里 μt(B)=λmax⁡(Bt−1∑j∈Itxjxj⊤)\mu_t^{(B)} = \lambda_{\max}\left( B_t^{-1} \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \mathbf{x}_j^\top \right)μt(B)​=λmax​(Bt−1​∑j∈It​​xj​xj⊤​)。内积家族将残差回归写入替换为直接目标写入:

Falcon-1A:St=(1−ηtλt)St−1+ηtxtyt⊤,ηt=βtEt+λt+ε,\text{Falcon-1A:} \quad \mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{y}_t^\top, \quad \eta_t = \frac{\beta_t}{E_t + \lambda_t + \varepsilon},Falcon-1A:St​=(1−ηt​λt​)St−1​+ηt​xt​yt⊤​,ηt​=Et​+λt​+εβt​​, Falcon-2A:St=St−1(Idv−λtDiag(ηt))+xt(ηt⊙yt)⊤,ηj,t=βj,tEt+λt+ε,\text{Falcon-2A:} \quad \mathbf{S}_t = \mathbf{S}_{t-1} (\mathbf{I}_{d_v} - \lambda_t \mathrm{Diag}(\boldsymbol{\eta}_t)) + \mathbf{x}_t (\boldsymbol{\eta}_t \odot \mathbf{y}_t)^\top, \qquad \eta_{j,t} = \frac{\beta_{j,t}}{E_t + \lambda_t + \varepsilon},Falcon-2A:St​=St−1​(Idv​​−λt​Diag(ηt​))+xt​(ηt​⊙yt​)⊤,ηj,t​=Et​+λt​+εβj,t​​, Falcon-3A:St=(1−ηtλt)St−1+ηtNˉt(B),ηt=βtEˉt(B)+λt+ε,\text{Falcon-3A:} \quad \mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \bar{\mathbf{N}}_t^{(B)}, \quad \eta_t = \frac{\beta_t}{\bar{E}_t^{(B)} + \lambda_t + \varepsilon},Falcon-3A:St​=(1−ηt​λt​)St−1​+ηt​Nˉt(B)​,ηt​=Eˉt(B)​+λt​+εβt​​,

其中 Et=∥xt∥22\mathcal{E}_t = \|\mathbf{x}_t\|_2^2Et​=∥xt​∥22​,Nˉt(B)=Bt−1∑j∈Itxjyj⊤\bar{\mathbf{N}}_t^{(B)} = B_t^{-1} \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \mathbf{y}_j^\topNˉt(B)​=Bt−1​∑j∈It​​xj​yj⊤​,Eˉt(B)=Bt−1∑j∈It∥xj∥22\bar{E}_t^{(B)} = B_t^{-1} \sum_{j \in \mathcal{I}_t} \|\mathbf{x}_j\|_2^2Eˉt(B)​=Bt−1​∑j∈It​​∥xj​∥22​。因此,索引 1/2/31/2/31/2/3 分别表示标量、逐列和滑动窗口动态。后缀"A"表示内积目标。

4.1 缩放线性注意力和缩放 DeltaNet

与使用缩放点积 ⟨q,k⟩/d\langle \mathbf{q}, \mathbf{k} \rangle / \sqrt{d}⟨q,k⟩/d​ 的 softmax 注意力不同,快权重循环直接对查询和键的范数敏感:(i) 点积读取随 ∥qt∥2∥k∥2\|\mathbf{q}_t\|_2 \|\mathbf{k}\|_2∥qt​∥2​∥k∥2​ 增长,(ii) 加性(内积)写入随写入特征范数增长。为稳定读取和写入流,尤其是在长解码范围和混合精度下,作者使用显式特征缩放/归一化。

缩放特征。 作者为向量 u∈Rdu\mathbf{u} \in \mathbb{R}^{d_u}u∈Rdu​ 定义通用 RMS 归一化算子:

RMSNorm(u):=u∥u∥22/du+εrms,\mathrm{RMSNorm}(\mathbf{u}) := \frac{\mathbf{u}}{\sqrt{\|\mathbf{u}\|_2^2 / d_u + \varepsilon_{\mathrm{rms}}}},RMSNorm(u):=∥u∥22​/du​+εrms​​u​,

其中 εrms>0\varepsilon_{\mathrm{rms}} > 0εrms​>0 是一个小的稳定化常数。除非另有说明,RMSNorm 应用于快权重读取/写入使用的 (qt,kt)(\mathbf{q}_t, \mathbf{k}_t)(qt​,kt​) 投影,在形成点积或外积之前。该默认设置不同于常见的 ℓ2\ell_2ℓ2​ 归一化 DeltaNet 变体(例如 Gated DeltaNet 实现中),并且在混合精度下显著更稳定,因为标准 RMSNorm 保持坐标幅度为 Θ(1)\Theta(1)Θ(1)。此外:

∥RMSNorm(u)∥22=du∥u∥22∥u∥22+duεrms≤du,\left\| \mathrm{RMSNorm}(\mathbf{u}) \right\|_2^2 = \frac{d_u \|\mathbf{u}\|_2^2}{\|\mathbf{u}\|_2^2 + d_u \varepsilon_{\mathrm{rms}}} \leq d_u,∥RMSNorm(u)∥22​=∥u∥22​+du​εrms​du​∥u∥22​​≤du​,

因此在通常的 ∥u∥22≫duεrms\|\mathbf{u}\|_2^2 \gg d_u \varepsilon_{\mathrm{rms}}∥u∥22​≫du​εrms​ 区间内,确实有 ∥RMSNorm(u)∥22≈du\|\mathrm{RMSNorm}(\mathbf{u})\|_2^2 \approx d_u∥RMSNorm(u)∥22​≈du​。默认情况下,值 vt\mathbf{v}_tvt​ 不被归一化;值归一化(VNorm)是可选的,除非显式启用否则禁用。

缩放线性注意力。 在下一潜在变量对齐下,RMS 归一化投影在特征空间中使用。标量无分母内积循环,记为 Falcon-1A,为:

ot=St⊤ϕ(qt),St=(1−ηtλt)St−1+ηtxtvt⊤,xt:=ϕ(kt−1).\mathbf{o}_t = \mathbf{S}_t^\top \phi(\mathbf{q}_t), \quad \mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{v}_t^\top, \quad \mathbf{x}_t := \phi(\mathbf{k}_{t-1}).ot​=St⊤​ϕ(qt​),St​=(1−ηt​λt​)St−1​+ηt​xt​vt⊤​,xt​:=ϕ(kt−1​).

其逐列对应版本 Falcon-2A 将标量写入增益替换为向量 ηt∈Rdv\boldsymbol{\eta}_t \in \mathbb{R}^{d_v}ηt​∈Rdv​:

St=St−1(Idv−λtDiag(ηt))+xt(ηt⊙vt)⊤.\mathbf{S}_t = \mathbf{S}_{t-1} (\mathbf{I}_{d_v} - \lambda_t \mathrm{Diag}(\boldsymbol{\eta}_t)) + \mathbf{x}_t (\boldsymbol{\eta}_t \odot \mathbf{v}_t)^\top.St​=St−1​(Idv​​−λt​Diag(ηt​))+xt​(ηt​⊙vt​)⊤.

对应的归一化分子/分母循环记录在附录 C.1 中;在有符号特征设置中,附录 C.2 中的分母注意事项适用。

缩放 DeltaNet 和常见岭参数化。 对于回归风格快权重,相同的缩放写入特征 xt\mathbf{x}_txt​ 在 NLMS 更新中使用:

St=(1−ηtλt)St−1+ηtxt(vt−St−1⊤xt)⊤,ηt=βt∥xt∥22+λt+ε.\mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \left(\mathbf{v}_t - \mathbf{S}_{t-1}^\top \mathbf{x}_t\right)^\top, \quad \eta_t = \frac{\beta_t}{\|\mathbf{x}_t\|_2^2 + \lambda_t + \varepsilon}.St​=(1−ηt​λt​)St−1​+ηt​xt​(vt​−St−1⊤​xt​)⊤,ηt​=∥xt​∥22​+λt​+εβt​​.

在缩放实现中,网络可以输出无量纲基础岭 λˉt\bar{\lambda}_tλˉt​,该值转换为循环使用的实际系数 λt=λˉtEt\lambda_t = \bar{\lambda}_t E_tλt​=λˉt​Et​,其中 EtE_tEt​ 是适当的归一化统计量:Falcon-2 使用 ∥xt∥22\|\mathbf{x}_t\|_2^2∥xt​∥22​,Falcon-3 使用 μt(B):=λmax⁡(Cˉt(B))\mu_t^{(B)} := \lambda_{\max}(\bar{\mathbf{C}}_t^{(B)})μt(B)​:=λmax​(Cˉt(B)​)。然后设置:

ηt=βtEt+λt+ε,αt:=ηtλt,γt:=1−αt.\eta_t = \frac{\beta_t}{E_t + \lambda_t + \varepsilon}, \quad \alpha_t := \eta_t \lambda_t, \quad \gamma_t := 1 - \alpha_t.ηt​=Et​+λt​+εβt​​,αt​:=ηt​λt​,γt​:=1−αt​.

这里,对于非滑动标量/逐列规则(Falcon-1/Falcon-2 和 Falcon-1A/Falcon-2A),Et=∥xt∥22E_t = \|\mathbf{x}_t\|_2^2Et​=∥xt​∥22​,而 Falcon-3 使用 Et=μt(B)E_t = \mu_t^{(B)}Et​=μt(B)​,Falcon-3A 使用 Et=E^t(B)E_t = \hat{E}_t^{(B)}Et​=E^t(B)​。对于回归,EtE_tEt​ 是数据项的局部平滑度尺度;对于内积写入,第 4.3 和 4.5 节中对应的能量统计量是实际的写入幅度控制。精确的尺度鲁棒性恒等式、分离统计量细节、归一化线性注意力循环和对数空间正衰减处理见附录 C.1 和附录 C.6。

4.2 回归损失(Delta 网络)

作者将状态更新表述为自回归线性回归问题。在时间步 ttt,设状态为 St−1∈Rdx×dv\mathbf{S}_{t-1} \in \mathbb{R}^{d_x \times d_v}St−1​∈Rdx​×dv​,写入特征为 xt≜ϕ(kt−1)∈Rdx\mathbf{x}_t \triangleq \phi(\mathbf{k}_{t-1}) \in \mathbb{R}^{d_x}xt​≜ϕ(kt−1​)∈Rdx​,目标为 yt≜vt∈Rdv\mathbf{y}_t \triangleq \mathbf{v}_t \in \mathbb{R}^{d_v}yt​≜vt​∈Rdv​。(在非核化情况下,ϕ\phiϕ 为恒等映射,dx=dd_x = ddx​=d。)状态 St−1\mathbf{S}_{t-1}St−1​ 充当线性预测器,将前缀特征 xt\mathbf{x}_txt​ 映射到新观察到的目标 yt\mathbf{y}_tyt​。

瞬时平方误差损失为:

ft(S):=12∥S⊤xt−yt∥22.f_t(\mathbf{S}) := \frac{1}{2} \left\| \mathbf{S}^\top \mathbf{x}_t - \mathbf{y}_t \right\|_2^2.ft​(S):=21​​S⊤xt​−yt​​22​.

在更新前状态处评估时,残差为 rt≜yt−St−1⊤xt\mathbf{r}_t \triangleq \mathbf{y}_t - \mathbf{S}_{t-1}^\top \mathbf{x}_trt​≜yt​−St−1⊤​xt​。关于状态的梯度为:

∇Sft(St−1)=xt(St−1⊤xt−yt)⊤=−xtrt⊤.\nabla_{\mathbf{S}} f_t(\mathbf{S}_{t-1}) = \mathbf{x}_t (\mathbf{S}_{t-1}^\top \mathbf{x}_t - \mathbf{y}_t)^\top = -\mathbf{x}_t \mathbf{r}_t^\top.∇S​ft​(St−1​)=xt​(St−1⊤​xt​−yt​)⊤=−xt​rt⊤​.

Delta 更新(标准 vs. 下一潜在变量)。 以学习率 ηt\eta_tηt​ 执行单步在线梯度下降(OGD)得到 Delta 更新:

St=St−1−ηt∇Sft(St−1)=St−1+ηtxtrt⊤=(Idx−ηtxtxt⊤)St−1+ηtxtyt⊤.\begin{aligned} \mathbf{S}_t &= \mathbf{S}_{t-1} - \eta_t \nabla_{\mathbf{S}} f_t(\mathbf{S}_{t-1}) \\ &= \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{r}_t^\top \\ &= (\mathbf{I}_{d_x} - \eta_t \mathbf{x}_t \mathbf{x}_t^\top) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{y}_t^\top. \end{aligned}St​​=St−1​−ηt​∇S​ft​(St−1​)=St−1​+ηt​xt​rt⊤​=(Idx​​−ηt​xt​xt⊤​)St−1​+ηt​xt​yt⊤​.​

在下一潜在变量对齐下,有 xt=ϕ(kt−1)\mathbf{x}_t = \phi(\mathbf{k}_{t-1})xt​=ϕ(kt−1​) 和 yt=vt\mathbf{y}_t = \mathbf{v}_tyt​=vt​。将 kt−1\mathbf{k}_{t-1}kt−1​ 替换为 kt\mathbf{k}_tkt​(等价地,xt←ϕ(kt)\mathbf{x}_t \gets \phi(\mathbf{k}_t)xt​←ϕ(kt​))恢复 Schlag 等人的非偏移 DeltaNet 更新。

L2L_2L2​ 正则化。 在瞬时损失中添加 L2L_2L2​ 惩罚 λt2∥S∥F2\frac{\lambda_t}{2} \|\mathbf{S}\|_F^22λt​​∥S∥F2​ 会在在线更新中产生收缩项 −ηtλtSt−1-\eta_t \lambda_t \mathbf{S}_{t-1}−ηt​λt​St−1​(参见式 (3.3))。在归一化步长下,这产生乘法因子 (1−ηtλt)(1 - \eta_t \lambda_t)(1−ηt​λt​),作者将其视为简单可控的遗忘机制。

Falcon-2:自适应学习率。 作者提出 Falcon-2,将 NLMS 风格归一化与逐通道自适应学习率相结合。在附录 F 中,他们推导了向量化对偶形式,使逐列自适应性在 GPU 上计算可行。这允许步长为向量 ηt∈Rdv\boldsymbol{\eta}_t \in \mathbb{R}^{d_v}ηt​∈Rdv​,为每个值通道(S\mathbf{S}S 的列)独立定制更新幅度。在此处研究的模型中,使用标准多头分解:每个头携带自己的快状态,并在该头内独立应用相同的逐列规则。

逐列 NLMS 步长。 具体而言,使用跨列共享的 NLMS 风格归一化器,并带有学习的逐列增益(等价地,逐输出特征/列增益):

ηj,t=βj,t∥xt∥22+λt+ε,βj,t∈(0,2),ε>0.\eta_{j,t} = \frac{\beta_{j,t}}{\|\mathbf{x}_t\|_2^2 + \lambda_t + \varepsilon}, \quad \beta_{j,t} \in (0, 2), \varepsilon > 0.ηj,t​=∥xt​∥22​+λt​+εβj,t​​,βj,t​∈(0,2),ε>0.

当 λt=0\lambda_t = 0λt​=0、ε=0\varepsilon = 0ε=0 且增益跨通道绑定时(βj,t≡βt\beta_{j,t} \equiv \beta_tβj,t​≡βt​),这退化为经典标量 NLMS 步长;否则,它是具有共享归一化器的逐列 NLMS 推广。由于平方误差(岭)损失在值坐标(S\mathbf{S}S 的列)上分解,引理 3.1 的每步下降论证在 0<βj,t<20 < \beta_{j,t} < 20<βj,t​<2 对所有 jjj 成立时逐列适用。等价地,Falcon-2 是在可分离目标上的一组 dvd_vdv​ 个独立标量步更新,而非具有完整矩阵值学习率的单个 Frobenius 梯度步。

更新规则。 设 ηt=(η1,t,…,ηdv,t)⊤\boldsymbol{\eta}_t = (\eta_{1,t}, \dots, \eta_{d_v,t})^\topηt​=(η1,t​,…,ηdv​,t​)⊤。更新可以紧凑地写为:

St=St−1(Idv−λtDiag(ηt))+xt(ηt⊙rt)⊤,\mathbf{S}_t = \mathbf{S}_{t-1} \left( \mathbf{I}_{d_v} - \lambda_t \mathrm{Diag}(\boldsymbol{\eta}_t) \right) + \mathbf{x}_t \left( \boldsymbol{\eta}_t \odot \mathbf{r}_t \right)^\top,St​=St−1​(Idv​​−λt​Diag(ηt​))+xt​(ηt​⊙rt​)⊤,

展开的编辑分解(将逐列收缩路径与特征方向编辑分离)见附录 F。

与 RWKV-7 和 Kimi 线性注意力的关系。 与 RWKV-7 和 Kimi 线性注意力的简要比较移至附录 C.6。

等价的逐列递归和分块并行核使用的对数空间正衰减重归一化见附录 F。

分块并行实现。 Falcon-2 可以通过沿长度轴分块并在每个块内使用 Gram/WY 表示来进行序列并行训练。在此处使用的多头设置中,该计算在每个头内独立应用。在块内,WY/Gram 形式构建共享键 Gram 矩阵和通道相关的单位下三角系统。注入值和投影历史路径共享该三角因子,因此实现求解一个合并的残差系统而非两个。这在前向传播中移除了每个块的一个批量 TriSolve,而不改变循环或渐近复杂度,并反映了 Comba 中强调的单求逆形式。算法 1 给出了单头 Falcon-2 分块前向传播,使用与实现相同的正衰减约定。无岭秩一情况通过设置 λt=0\lambda_t = 0λt​=0 恢复,此时 γt,j=1\gamma_{t,j} = 1γt,j​=1 且块局部重缩放变为恒等映射。附录 F 给出了精确的 WY/Gram 代数和复杂度分析。

4.3 内积损失(线性注意力和 Mamba-2)

作者现在考虑一个鼓励状态预测与目标对齐的内积目标。它以最小化形式写出,带有可选的 L2L_2L2​ 惩罚:

ℓtip(S)≜−⟨S⊤xt,yt⟩+λt2∥S∥F2,λt≥0.\ell_t^{\mathrm{ip}}(\mathbf{S}) \triangleq -\langle \mathbf{S}^\top \mathbf{x}_t, \mathbf{y}_t \rangle + \frac{\lambda_t}{2} \|\mathbf{S}\|_F^2, \quad \lambda_t \geq 0.ℓtip​(S)≜−⟨S⊤xt​,yt​⟩+2λt​​∥S∥F2​,λt​≥0.

当 λt=0\lambda_t = 0λt​=0 时,目标关于 S\mathbf{S}S 是线性的(无有限最小化器),梯度下降退化为纯加性 Hebbian 写入。

标准 vs. 下一潜在变量对齐。 如果选择非偏移特征 (xt,yt)=(ϕ(kt),vt)(\mathbf{x}_t, \mathbf{y}_t) = (\phi(\mathbf{k}_t), \mathbf{v}_t)(xt​,yt​)=(ϕ(kt​),vt​)(或非核化情况下的 (kt,vt)(\mathbf{k}_t, \mathbf{v}_t)(kt​,vt​)),下面的加性更新匹配通常的线性注意力写入 ϕ(kt)vt⊤\phi(\mathbf{k}_t) \mathbf{v}_t^\topϕ(kt​)vt⊤​(式 (2.2))。下一潜在变量框架则使用 (xt,yt)=(ϕ(kt−1),vt)(\mathbf{x}_t, \mathbf{y}_t) = (\phi(\mathbf{k}_{t-1}), \mathbf{v}_t)(xt​,yt​)=(ϕ(kt−1​),vt​),产生一步偏移的写入流。

Falcon-A 变体和符号。 后缀"A"用于内积目标,数字索引与回归家族保持对齐。因此 Falcon-1A 是标量非滑动内积规则,Falcon-2A 是逐列非滑动内积规则,Falcon-3A 是第 4.5 节中的滑动窗口内积规则。与 Falcon-1/Falcon-2/Falcon-3 一样,βt\beta_tβt​ 表示无量纲增益,λt\lambda_tλt​ 表示循环使用的实际收缩系数(直接获得或通过上述相同的尺度耦合构造获得),ηt\eta_tηt​ 表示由此产生的步长。对于内积家族,该步长应理解为能量归一化写入增益,而非曲率匹配分母。任何衰减分数 αt:=ηtλt\alpha_t := \eta_t \lambda_tαt​:=ηt​λt​ 都是推导出来的,而非独立参数化的。

梯度和更新。 式 (4.5) 的梯度为:

∇Sℓtip(S)=−xtyt⊤+λtS.\nabla_{\mathbf{S}} \ell_t^{\mathrm{ip}}(\mathbf{S}) = -\mathbf{x}_t \mathbf{y}_t^\top + \lambda_t \mathbf{S}.∇S​ℓtip​(S)=−xt​yt⊤​+λt​S.

标量梯度步给出线性注意力/Mamba-2 风格更新,作者记为 Falcon-1A:

St=(1−ηtλt)St−1+ηtxtyt⊤,\mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{y}_t^\top,St​=(1−ηt​λt​)St−1​+ηt​xt​yt⊤​,

其中在下一潜在变量对齐下 xt=ϕ(kt−1)\mathbf{x}_t = \phi(\mathbf{k}_{t-1})xt​=ϕ(kt−1​) 和 yt=vt\mathbf{y}_t = \mathbf{v}_tyt​=vt​。设置 λt=0\lambda_t = 0λt​=0 恢复通常的加性写入 St=St−1+ηtxtyt⊤\mathbf{S}_t = \mathbf{S}_{t-1} + \eta_t \mathbf{x}_t \mathbf{y}_t^\topSt​=St−1​+ηt​xt​yt⊤​。

Falcon-2A:逐列内积写入。 由于式 (4.5) 在值坐标上分解,每列可以使用自己的能量归一化学习率。定义:

ηt:=(η1,t,…,ηdv,t)⊤.\boldsymbol{\eta}_t := \left( \eta_{1,t}, \dots, \eta_{d_v,t} \right)^\top.ηt​:=(η1,t​,…,ηdv​,t​)⊤.

逐列内积更新为:

St=St−1(Idv−λtDiag(ηt))+xt(ηt⊙yt)⊤.\mathbf{S}_t = \mathbf{S}_{t-1} (\mathbf{I}_{d_v} - \lambda_t \mathrm{Diag}(\boldsymbol{\eta}_t)) + \mathbf{x}_t (\boldsymbol{\eta}_t \odot \mathbf{y}_t)^\top.St​=St−1​(Idv​​−λt​Diag(ηt​))+xt​(ηt​⊙yt​)⊤.

等价地,第 jjj 列演化如下:

st,j=(1−ηj,tλt)st−1,j+ηj,tyt,jxt.\mathbf{s}_{t,j} = (1 - \eta_{j,t} \lambda_t) \mathbf{s}_{t-1,j} + \eta_{j,t} y_{t,j} \mathbf{x}_t.st,j​=(1−ηj,t​λt​)st−1,j​+ηj,t​yt,j​xt​.

因此 Falcon-2A 不是标量内积规则;它是 Falcon-2 的逐列内积类似物。

Falcon-1A/Falcon-2A 步长。 与回归不同,内积目标是 λt\lambda_tλt​-光滑的,与写入特征能量无关。因此,目标匹配的分母将仅依赖于 λt\lambda_tλt​;在此处研究的内积实现中,保留能量归一化写入增益以控制加性写入的幅度。设 Et:=∥xt∥22E_t := \|\mathbf{x}_t\|_2^2Et​:=∥xt​∥22​,如果尺度耦合参数化激活,则在应用更新前设置 λt:=λˉtEt\lambda_t := \bar{\lambda}_t E_tλt​:=λˉt​Et​。标量 Falcon-1A 步长为:

ηt=βtEt+λt+ε,βt∈(0,2),ε≥0.\eta_t = \frac{\beta_t}{E_t + \lambda_t + \varepsilon}, \quad \beta_t \in (0, 2), \varepsilon \geq 0.ηt​=Et​+λt​+εβt​​,βt​∈(0,2),ε≥0.

逐列 Falcon-2A 步长为:

ηj,t=βj,tEt+λt+ε,βj,t∈(0,2),ε≥0.\eta_{j,t} = \frac{\beta_{j,t}}{E_t + \lambda_t + \varepsilon}, \quad \beta_{j,t} \in (0, 2), \varepsilon \geq 0.ηj,t​=Et​+λt​+εβj,t​​,βj,t​∈(0,2),ε≥0.

如式 (3.4) 中,当分母消失时设置 ηt:=0\eta_t := 0ηt​:=0(或对所有 jjj 设置 ηj,t:=0\eta_{j,t} := 0ηj,t​:=0),并且在边界哨兵 t=1t = 1t=1 处施加 x1=0\mathbf{x}_1 = \mathbf{0}x1​=0 时同样如此。当 λt>0\lambda_t > 0λt​>0 时,这些选择满足 ηt<2/λt\eta_t < 2/\lambda_tηt​<2/λt​ 和 ηj,t<2/λt\eta_{j,t} < 2/\lambda_tηj,t​<2/λt​,对于任何可接受的 βt,βj,t\beta_t, \beta_{j,t}βt​,βj,t​。由于 ℓtip\ell_t^{\mathrm{ip}}ℓtip​ 是 λt\lambda_tλt​-光滑的(其 Hessian 为 λtI\lambda_t \mathbf{I}λt​I),引理 3.1 对未钳制的标量更新给出每步下降,同一论证逐列适用于式 (4.7)。如果后续正衰减钳制为对数空间展开而激活,则实现的收缩应解释为在标量情况下使用有效岭系数 λt:=αt/ηt\lambda_t := \alpha_t / \eta_tλt​:=αt​/ηt​,或在逐列情况下使用 λˉj,t:=αj,t/ηj,t\bar{\lambda}_{j,t} := \alpha_{j,t} / \eta_{j,t}λˉj,t​:=αj,t​/ηj,t​,只要对应的步长为正。EtE_tEt​ 项不是曲率所要求的,但稳定了写入幅度并产生了合理的 λt→0\lambda_t \to 0λt​→0 极限。

衰减正性。 某些并行/展开形式(第 4.6 节)在对数空间中使用 γt:=1−ηtλt\gamma_t := 1 - \eta_t \lambda_tγt​:=1−ηt​λt​,因此要求 γt>0\gamma_t > 0γt​>0。在实现中,计算 αt:=ηtλt\alpha_t := \eta_t \lambda_tαt​:=ηt​λt​,如有必要,在计算 log⁡γt=log⁡1p(−αt)\log \gamma_t = \log 1\mathrm{p}(-\alpha_t)logγt​=log1p(−αt​)(fp32)之前钳制 αt←min⁡(αt,1−εγ)\alpha_t \leftarrow \min(\alpha_t, 1 - \varepsilon_\gamma)αt​←min(αt​,1−εγ​)。当 ηtλt<1−εγ\eta_t \lambda_t < 1 - \varepsilon_\gammaηt​λt​<1−εγ​ 时钳制不激活;在该区间内,动态精确匹配 γt=1−ηtλt\gamma_t = 1 - \eta_t \lambda_tγt​=1−ηt​λt​。如上所述,下降陈述适用于未钳制的循环。当钳制激活时,实现的循环应视为数值安全的替代,其收缩路径使用有效岭系数:

λ~t:=αt/ηt\widetilde{\lambda}_t := \alpha_t / \eta_tλt​:=αt​/ηt​

只要 ηt>0\eta_t > 0ηt​>0(当 ηt=0\eta_t = 0ηt​=0 时 λ~t:=0\widetilde{\lambda}_t := 0λt​:=0),而加性写入增益保持为 ηt\eta_tηt​。

4.4 回归的小批量更新规则(Falcon-3)

为更好地捕获局部依赖并减少噪声累积,作者引入了滑动状态机制:不是仅从瞬时残差更新状态,而是在名义大小为 BBB 的有限历史窗口上执行单次小批量梯度步。

Falcon-3 可以视为 ATLAS 所体现的内部目标视角的滑动窗口特化,但此处以线性矩阵内存、平方误差目标和严格的下一潜在变量对齐实例化。跨段边界的精确延续还需要最后 B−1B-1B−1 个因果对的固定宽度尾部;附录 C.7 记录了细节。

序列并行训练。 在将每个活动窗口零填充到宽度 BBB 后,Falcon-3 变为固定秩 BBB 的低秩循环。算法 2 给出参考顺序更新,算法 3 给出基于式 (4.16) 中正衰减归约的分块并行 ParallelFlow 实现。附录 H 记录了驱动构造和掩码约定。内积对应版本(Falcon-3A)具有显式的掩码线性注意力形式(第 4.6 节),可在序列维度上实现完全向量化训练。

对于 t≥2t \geq 2t≥2,设活动窗口索引为 It={j∣max⁡(2,t−B+1)≤j≤t}\mathcal{I}_t = \{ j \mid \max(2, t - B + 1) \leq j \leq t \}It​={j∣max(2,t−B+1)≤j≤t},实际窗口大小为 Bt:=∣It∣≤BB_t := |\mathcal{I}_t| \leq BBt​:=∣It​∣≤B(因此 Bt≥1B_t \geq 1Bt​≥1)。定义写入特征 xj:=ϕ(kj−1)\mathbf{x}_j := \phi(\mathbf{k}_{j-1})xj​:=ϕ(kj−1​) 对于 j≥2j \geq 2j≥2(因此当 ϕ\phiϕ 为恒等映射时 xj=kj−1\mathbf{x}_j = \mathbf{k}_{j-1}xj​=kj−1​),并施加边界约定 x1:=0\mathbf{x}_1 := \mathbf{0}x1​:=0。作者设置 η1:=0\eta_1 := 0η1​:=0,因此 t=1t = 1t=1 的写入是无操作;下面的所有窗口化目标/更新均针对 t≥2t \geq 2t≥2 定义。为使更新幅度(从而有效衰减)不依赖于名义窗口大小 BBB,优化窗口平均平方损失:

ℓtreg,(B)(S):=12Bt∑j∈It∥S⊤xj−vj∥22+λt2∥S∥F2,(t≥2).\ell_t^{\mathrm{reg},(B)}(\mathbf{S}) := \frac{1}{2 B_t} \sum_{j \in \mathcal{I}_t} \| \mathbf{S}^\top \mathbf{x}_j - \mathbf{v}_j \|_2^2 + \frac{\lambda_t}{2} \|\mathbf{S}\|_F^2, \qquad (t \geq 2).ℓtreg,(B)​(S):=2Bt​1​j∈It​∑​∥S⊤xj​−vj​∥22​+2λt​​∥S∥F2​,(t≥2).

充分统计量。 作者定义滑动协方差 Ct(B)\mathbf{C}_t^{(B)}Ct(B)​ 和互协方差 Nt(B)\mathbf{N}_t^{(B)}Nt(B)​ 矩阵:

Ct(B)≜∑j∈Itxjxj⊤,Nt(B)≜∑j∈Itxjvj⊤.\mathbf{C}_t^{(B)} \triangleq \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \mathbf{x}_j^\top, \quad \mathbf{N}_t^{(B)} \triangleq \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \mathbf{v}_j^\top.Ct(B)​≜j∈It​∑​xj​xj⊤​,Nt(B)​≜j∈It​∑​xj​vj⊤​.

定义窗口平均统计量:

Cˉt(B):=1BtCt(B),Nˉt(B):=1BtNt(B).\bar{\mathbf{C}}_t^{(B)} := \frac{1}{B_t} \mathbf{C}_t^{(B)}, \quad \bar{\mathbf{N}}_t^{(B)} := \frac{1}{B_t} \mathbf{N}_t^{(B)}.Cˉt(B)​:=Bt​1​Ct(B)​,Nˉt(B)​:=Bt​1​Nt(B)​.

则在更新前状态处评估的梯度为:

∇Sℓtreg,(B)(St−1)=Cˉt(B)St−1−Nˉt(B)+λtSt−1.\nabla_{\mathbf{S}} \ell_t^{\mathrm{reg},(B)}(\mathbf{S}_{t-1}) = \bar{\mathbf{C}}_t^{(B)} \mathbf{S}_{t-1} - \bar{\mathbf{N}}_t^{(B)} + \lambda_t \mathbf{S}_{t-1}.∇S​ℓtreg,(B)​(St−1​)=Cˉt(B)​St−1​−Nˉt(B)​+λt​St−1​.

更新规则。 应用块归一化梯度步:

St=St−1−ηt∇Sℓtreg,(B)(St−1).\mathbf{S}_t = \mathbf{S}_{t-1} - \eta_t \nabla_{\mathbf{S}} \ell_t^{\mathrm{reg},(B)}(\mathbf{S}_{t-1}).St​=St−1​−ηt​∇S​ℓtreg,(B)​(St−1​).

代入梯度得到仿射更新:

St=(Idx−ηt(Cˉt(B)+λtIdx))St−1+ηtNˉt(B).\mathbf{S}_t = \left( \mathbf{I}_{d_x} - \eta_t (\bar{\mathbf{C}}_t^{(B)} + \lambda_t \mathbf{I}_{d_x}) \right) \mathbf{S}_{t-1} + \eta_t \bar{\mathbf{N}}_t^{(B)}.St​=(Idx​​−ηt​(Cˉt(B)​+λt​Idx​​))St−1​+ηt​Nˉt(B)​.

等价地,在更新前状态处收集残差得到:

St=(1−ηtλt)St−1+ηtBt∑j∈Itxj(vj−St−1⊤xj)⊤.\mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \frac{\eta_t}{B_t} \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \left( \mathbf{v}_j - \mathbf{S}_{t-1}^\top \mathbf{x}_j \right)^\top.St​=(1−ηt​λt​)St−1​+Bt​ηt​​j∈It​∑​xj​(vj​−St−1⊤​xj​)⊤.

这是式 (3.3) 的直接小批量类似物:所有窗口残差在更新前状态 St−1\mathbf{S}_{t-1}St−1​ 处评估,更新平均它们的秩一梯度。

对于 t≥2t \geq 2t≥2,设 Xt∈Rdx×Bt\mathbf{X}_t \in \mathbb{R}^{d_x \times B_t}Xt​∈Rdx​×Bt​ 堆叠活动窗口写入特征,使得 Cˉt(B)=XtXt⊤/Bt\bar{\mathbf{C}}_t^{(B)} = \mathbf{X}_t \mathbf{X}_t^\top / B_tCˉt(B)​=Xt​Xt⊤​/Bt​。作者使用窗口化岭目标的精确局部平滑度尺度而非其迹上界进行归一化:

μt(B):=λmax⁡(Cˉt(B))=∥Xt∥22Bt=λmax⁡(Xt⊤Xt)Bt,ηt=βtμt(B)+λt+ε,βt∈(0,2),ε>0.\mu_t^{(B)} := \lambda_{\max}(\bar{\mathbf{C}}_t^{(B)}) = \frac{\|\mathbf{X}_t\|_2^2}{B_t} = \frac{\lambda_{\max}(\mathbf{X}_t^\top \mathbf{X}_t)}{B_t}, \quad \eta_t = \frac{\beta_t}{\mu_t^{(B)} + \lambda_t + \varepsilon}, \quad \beta_t \in (0, 2), \varepsilon > 0.μt(B)​:=λmax​(Cˉt(B)​)=Bt​∥Xt​∥22​​=Bt​λmax​(Xt⊤​Xt​)​,ηt​=μt(B)​+λt​+εβt​​,βt​∈(0,2),ε>0.

则 Lt(B)=μt(B)+λtL_t^{(B)} = \mu_t^{(B)} + \lambda_tLt(B)​=μt(B)​+λt​,因此只要 Lt(B)>0L_t^{(B)} > 0Lt(B)​>0,该归一化确保对于任何 βt∈(0,2)\beta_t \in (0, 2)βt​∈(0,2) 有 ηt∈(0,2/Lt(B))\eta_t \in (0, 2/L_t^{(B)})ηt​∈(0,2/Lt(B)​),引理 3.1 在任何正衰减钳制之前对式 (4.14) 给出每步下降。如果 Lt(B)=0L_t^{(B)} = 0Lt(B)​=0(等价地,Cˉt(B)=0\bar{\mathbf{C}}_t^{(B)} = \mathbf{0}Cˉt(B)​=0 且 λt=0\lambda_t = 0λt​=0),则 Nˉt(B)=0\bar{\mathbf{N}}_t^{(B)} = \mathbf{0}Nˉt(B)​=0 且更新为无操作。关键在于,由于优化的是窗口平均,Nˉt(B)\bar{\mathbf{N}}_t^{(B)}Nˉt(B)​ 是平均值,μt(B)\mu_t^{(B)}μt(B)​ 是平均协方差的谱范数,因此两者都不会随名义窗口大小 BBB 线性增长。如果写入特征本身经过 RMS 归一化,则:

μt(B)≤Eˉt(B):=tr(Cˉt(B))≈dx,\mu_t^{(B)} \leq \bar{E}_t^{(B)} := \mathrm{tr}(\bar{\mathbf{C}}_t^{(B)}) \approx d_x,μt(B)​≤Eˉt(B)​:=tr(Cˉt(B)​)≈dx​,

因此分母保持 O(dx)O(d_x)O(dx​) 而非 O(Bdx)O(B d_x)O(Bdx​);对于通用核映射 ϕ\phiϕ,正确的陈述是 μt(B)\mu_t^{(B)}μt(B)​ 跟踪实际窗口化平滑度尺度。因此,注入项 ηtNˉt(B)\eta_t \bar{\mathbf{N}}_t^{(B)}ηt​Nˉt(B)​ 和衰减分数 αt:=ηtλt\alpha_t := \eta_t \lambda_tαt​:=ηt​λt​ 都不会因增加 BBB 而被系统性放大。如果启用第 4.1 节的尺度耦合岭参数化,则将本节中的 λt\lambda_tλt​ 替换为 λteff:=λˉtμt(B)\lambda_t^{\mathrm{eff}} := \bar{\lambda}_t \mu_t^{(B)}λteff​:=λˉt​μt(B)​。在当前实现中,该平滑度统计量在构造 λteff\lambda_t^{\mathrm{eff}}λteff​ 时可视为仅统计量乘数(通过乘数分离/停止梯度),而步长分母仍使用实时的 μt(B)\mu_t^{(B)}μt(B)​。重要的是,无需物化 dx×dxd_x \times d_xdx​×dx​ 矩阵 Ct(B)\mathbf{C}_t^{(B)}Ct(B)​ 即可评估梯度或步长:如果窗口写入特征堆叠为 Xt∈Rdx×Bt\mathbf{X}_t \in \mathbb{R}^{d_x \times B_t}Xt​∈Rdx​×Bt​,则:

Cˉt(B)St−1=1BtXt(Xt⊤St−1),μt(B)=λmax⁡(Xt⊤Xt)Bt.\bar{\mathbf{C}}_t^{(B)} \mathbf{S}_{t-1} = \frac{1}{B_t} \mathbf{X}_t \left( \mathbf{X}_t^\top \mathbf{S}_{t-1} \right), \quad \mu_t^{(B)} = \frac{\lambda_{\max}(\mathbf{X}_t^\top \mathbf{X}_t)}{B_t}.Cˉt(B)​St−1​=Bt​1​Xt​(Xt⊤​St−1​),μt(B)​=Bt​λmax​(Xt⊤​Xt​)​.

由于 Bt≤BB_t \leq BBt​≤B 较小,μt(B)\mu_t^{(B)}μt(B)​ 可以从 Bt×BtB_t \times B_tBt​×Bt​ Gram 矩阵精确计算,或通过几次幂迭代近似。对于实现的正常衰减循环,定义:

αtraw:=ηtλt,αt:=min⁡(αtraw,1−εγ),γt:=1−αt,\alpha_t^{\mathrm{raw}} := \eta_t \lambda_t, \quad \alpha_t := \min(\alpha_t^{\mathrm{raw}}, 1 - \varepsilon_\gamma), \quad \gamma_t := 1 - \alpha_t,αtraw​:=ηt​λt​,αt​:=min(αtraw​,1−εγ​),γt​:=1−αt​, c0:=1,ct:=∏r=1tγr,S~t:=St/ct.c_0 := 1, \qquad c_t := \prod_{r=1}^t \gamma_r, \quad \widetilde{\mathbf{S}}_t := \mathbf{S}_t / c_t.c0​:=1,ct​:=r=1∏t​γr​,St​:=St​/ct​.

当 αt=αtraw\alpha_t = \alpha_t^{\mathrm{raw}}αt​=αtraw​ 时,这正是式 (4.14) 中的岭梯度循环。如果钳制激活,则实现的收缩路径应解释为使用有效系数:

λ~t:={αt/ηt,ηt>0,0,ηt=0,\widetilde{\lambda}_t := \begin{cases} \alpha_t / \eta_t, & \eta_t > 0, \\ 0, & \eta_t = 0, \end{cases}λt​:={αt​/ηt​,0,​ηt​>0,ηt​=0,​

同时保持相同的残差注入增益 ηt\eta_tηt​。因此上述下降陈述适用于未钳制更新;钳制更新是正衰减替代。在此约定下,实现的循环等价于:

S~t=S~t−1+η^tBt∑j∈Itxj(vjct−1−S~t−1⊤xj)⊤,η^t:=ηt/γt.\widetilde{\mathbf{S}}_t = \widetilde{\mathbf{S}}_{t-1} + \frac{\widehat{\eta}_t}{B_t} \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \left( \frac{\mathbf{v}_j}{c_{t-1}} - \widetilde{\mathbf{S}}_{t-1}^\top \mathbf{x}_j \right)^\top, \quad \widehat{\eta}_t := \eta_t / \gamma_t.St​=St−1​+Bt​η​t​​j∈It​∑​xj​(ct−1​vj​​−St−1⊤​xj​)⊤,η​t​:=ηt​/γt​.

算法 3 通过对数前缀衰减在块局部实现式 (4.16);附录 C.7 记录了对应的延续和块边界细节。

边界/扫描细节。 离线重叠解释、精确延续要求和显式关联块映射见附录 C.7 和附录 H.1。

4.5 内积损失的小批量更新规则(Falcon-3A)

作者将相同的滑动窗口原则应用于内积目标,同时保持与家族其余部分相同的参数语义:βt\beta_tβt​ 是无量纲增益,λt\lambda_tλt​ 是循环使用的实际收缩系数(在任何可选尺度耦合之后),ηt\eta_tηt​ 是由此产生的归一化步长。

对于 t≥2t \geq 2t≥2,设 Bt:=∣It∣≤BB_t := |\mathcal{I}_t| \leq BBt​:=∣It​∣≤B(并跳过 t=1t = 1t=1 处的边界更新)。窗口化损失为:

ℓtip,(B)(S):=−1Bt∑j∈It⟨S⊤xj,vj⟩+λt2∥S∥F2.\ell_t^{\mathrm{ip},(B)}(\mathbf{S}) := -\frac{1}{B_t} \sum_{j \in \mathcal{I}_t} \left\langle \mathbf{S}^\top \mathbf{x}_j, \mathbf{v}_j \right\rangle + \frac{\lambda_t}{2} \|\mathbf{S}\|_F^2.ℓtip,(B)​(S):=−Bt​1​j∈It​∑​⟨S⊤xj​,vj​⟩+2λt​​∥S∥F2​.

定义窗口平均互协方差和写入能量:

Nˉt(B):=1Bt∑j∈Itxjvj⊤,Eˉt(B):=1Bt∑j∈It∥xj∥22.\bar{\mathbf{N}}_t^{(B)} := \frac{1}{B_t} \sum_{j \in \mathcal{I}_t} \mathbf{x}_j \mathbf{v}_j^\top, \quad \bar{E}_t^{(B)} := \frac{1}{B_t} \sum_{j \in \mathcal{I}_t} \|\mathbf{x}_j\|_2^2.Nˉt(B)​:=Bt​1​j∈It​∑​xj​vj⊤​,Eˉt(B)​:=Bt​1​j∈It​∑​∥xj​∥22​.

则在更新前状态处评估的梯度为:

∇Sℓtip,(B)(St−1)=−Nˉt(B)+λtSt−1.\nabla_{\mathbf{S}} \ell_t^{\mathrm{ip},(B)}(\mathbf{S}_{t-1}) = -\bar{\mathbf{N}}_t^{(B)} + \lambda_t \mathbf{S}_{t-1}.∇S​ℓtip,(B)​(St−1​)=−Nˉt(B)​+λt​St−1​.

与 Falcon-3 使用局部平滑度 μt(B)\mu_t^{(B)}μt(B)​ 作为回归步长不同,内积窗口化规则使用窗口能量统计量作为实际写入增益归一化器。设 Et(B):=Eˉt(B)E_t^{(B)} := \bar{E}_t^{(B)}Et(B)​:=Eˉt(B)​,如果尺度耦合参数化激活,则在计算步长之前设置 λt:=λˉtEt(B)\lambda_t := \bar{\lambda}_t E_t^{(B)}λt​:=λˉt​Et(B)​:

ηt=βtEt(B)+λt+ε,βt∈(0,2),ε>0,\eta_t = \frac{\beta_t}{E_t^{(B)} + \lambda_t + \varepsilon}, \qquad \beta_t \in (0, 2), \varepsilon > 0,ηt​=Et(B)​+λt​+εβt​​,βt​∈(0,2),ε>0,

边界约定为 η1:=0\eta_1 := 0η1​:=0。应用单步梯度给出:

St=(1−ηtλt)St−1+ηtNˉt(B).\mathbf{S}_t = (1 - \eta_t \lambda_t) \mathbf{S}_{t-1} + \eta_t \bar{\mathbf{N}}_t^{(B)}.St​=(1−ηt​λt​)St−1​+ηt​Nˉt(B)​.

当 λt>0\lambda_t > 0λt​>0 时,目标是 λt\lambda_tλt​-光滑的,因此式 (4.18) 暗示对于任何 βt∈(0,2)\beta_t \in (0, 2)βt​∈(0,2) 有 ηt<2/λt\eta_t < 2/\lambda_tηt​<2/λt​,引理 3.1 对未钳制更新在 ℓtip,(B)\ell_t^{\mathrm{ip},(B)}ℓtip,(B)​ 上给出每步下降。如果下面的正衰减钳制激活,则实现的收缩应再次解释为在 ηt>0\eta_t > 0ηt​>0 时使用有效岭系数 λ~t:=αt/ηt\widetilde{\lambda}_t := \alpha_t / \eta_tλt​:=αt​/ηt​(当 ηt=0\eta_t = 0ηt​=0 时为 0),而非原始 λt\lambda_tλt​ 的精确梯度步。当 λt=0\lambda_t = 0λt​=0 时,目标是线性的且无下界,因此相同的归一化应解释为加性写入的幅度稳定器,而非有界目标的保证。

对于对数空间展开,作者仅引入推导量:

αtraw:=ηtλt,αt:=min⁡(αtraw,1−εγ),γt:=1−αt∈[εγ,1],\alpha_t^{\mathrm{raw}} := \eta_t \lambda_t, \quad \alpha_t := \min(\alpha_t^{\mathrm{raw}}, 1 - \varepsilon_\gamma), \quad \gamma_t := 1 - \alpha_t \in [\varepsilon_\gamma, 1],αtraw​:=ηt​λt​,αt​:=min(αtraw​,1−εγ​),γt​:=1−αt​∈[εγ​,1],

其中 α1:=0\alpha_1 := 0α1​:=0 和 γ1:=1\gamma_1 := 1γ1​:=1。因此,αt\alpha_tαt​ 和 γt\gamma_tγt​ 是从其他地方使用的相同 (βt,λt,ηt)(\beta_t, \lambda_t, \eta_t)(βt​,λt​,ηt​) 参数化推导出的实现变量;它们不是单独学习的控制量。

由于优化的是窗口平均,Nˉt(B)\bar{\mathbf{N}}_t^{(B)}Nˉt(B)​ 的典型尺度或衰减分数 αt=ηtλt\alpha_t = \eta_t \lambda_tαt​=ηt​λt​ 都不会随名义窗口大小 BBB 系统性增长。作者再次在式 (4.18) 中的分母消失时设置 ηt:=0\eta_t := 0ηt​:=0(实践中取 ε>0\varepsilon > 0ε>0)。附录 C.7 记录了平稳计算和精确边界状态要求。对于 B=1B = 1B=1 和 t≥2t \geq 2t≥2,式 (4.19) 退化为标量非滑动内积更新,即 Falcon-1A;在加性消融 λt≡0\lambda_t \equiv 0λt​≡0 中,写入是纯加性的。逐列非滑动类似物是式 (4.7) 中的 Falcon-2A。

4.6 小批量内积更新的并行(注意力)形式

作者证明了第 4.5 节中的循环滑动窗口更新可以写为 (i) 来自入站边界状态的衰减历史项与 (ii) 具有结构化因果掩码的(非归一化)点积注意力矩阵之和。这一视角实现了 GPU 并行训练,并匹配了门控线性循环展开为掩码注意力的通常方式。

对于未钳制的阐述,设 λs\lambda_sλs​ 为任何可选尺度耦合后的实际收缩系数,并定义:

ηs:=βsEˉs(B)+λs+ε,γs:=1−ηsλs,δt:=∏r=1tγr.\eta_s := \frac{\beta_s}{\bar{E}_s^{(B)} + \lambda_s + \varepsilon}, \quad \gamma_s := 1 - \eta_s \lambda_s, \quad \delta_t := \prod_{r=1}^t \gamma_r.ηs​:=Eˉs(B)​+λs​+εβs​​,γs​:=1−ηs​λs​,δt​:=r=1∏t​γr​.

则循环 Ss=γsSs−1+ηsNˉs(B)\mathbf{S}_s = \gamma_s \mathbf{S}_{s-1} + \eta_s \bar{\mathbf{N}}_s^{(B)}Ss​=γs​Ss−1​+ηs​Nˉs(B)​ 展开为:

St=δtS0+∑j=2tMt,jxjvj⊤,\mathbf{S}_t = \delta_t \mathbf{S}_0 + \sum_{j=2}^t M_{t,j} \mathbf{x}_j \mathbf{v}_j^\top,St​=δt​S0​+j=2∑t​Mt,j​xj​vj⊤​,

其中,在边界约定 x1:=0\mathbf{x}_1 := \mathbf{0}x1​:=0 和 η1=0\eta_1 = 0η1​=0 下:

Mt,j:=∑s=jmin⁡(t,j+B−1)ηsBs∏r=s+1tγr,2≤j≤t,M_{t,j} := \sum_{s=j}^{\min(t, j+B-1)} \frac{\eta_s}{B_s} \prod_{r=s+1}^t \gamma_r, \qquad 2 \leq j \leq t,Mt,j​:=s=j∑min(t,j+B−1)​Bs​ηs​​r=s+1∏t​γr​,2≤j≤t,

否则 Mt,j:=0M_{t,j} := 0Mt,j​:=0。因此,读写后置输出为:

ot=δtS0⊤ϕ(qt)+∑j=2tMt,j⟨ϕ(qt),xj⟩vj.\mathbf{o}_t = \delta_t \mathbf{S}_0^\top \phi(\mathbf{q}_t) + \sum_{j=2}^t M_{t,j} \langle \phi(\mathbf{q}_t), \mathbf{x}_j \rangle \mathbf{v}_j.ot​=δt​S0⊤​ϕ(qt​)+j=2∑t​Mt,j​⟨ϕ(qt​),xj​⟩vj​.

等价地,堆叠查询特征 Q∈RL×dx\mathbf{Q} \in \mathbb{R}^{L \times d_x}Q∈RL×dx​、写入特征 X∈RL×dx\mathbf{X} \in \mathbb{R}^{L \times d_x}X∈RL×dx​、值 V∈RL×dv\mathbf{V} \in \mathbb{R}^{L \times d_v}V∈RL×dv​ 和掩码 M∈RL×L\mathbf{M} \in \mathbb{R}^{L \times L}M∈RL×L(条目为 Mt,j=Mt,j\mathbf{M}_{t,j} = M_{t,j}Mt,j​=Mt,j​),得到:

O=Diag(δ)QS0+(QX⊤⊙M)V,δ:=(δ1,…,δL)⊤.\mathbf{O} = \mathrm{Diag}(\boldsymbol{\delta}) \mathbf{Q} \mathbf{S}_0 + (\mathbf{Q} \mathbf{X}^\top \odot \mathbf{M}) \mathbf{V}, \quad \boldsymbol{\delta} := (\delta_1, \dots, \delta_L)^\top.O=Diag(δ)QS0​+(QX⊤⊙M)V,δ:=(δ1​,…,δL​)⊤.

对于新序列默认 S0=0\mathbf{S}_0 = \mathbf{0}S0​=0,仅保留掩码注意力项。附录 D.1 给出了完整推导、平稳特例和算法 4 使用的块局部对数空间评估。

反向传播。 数值稳定的反向传播见附录 D.2;它通过结构化掩码、块局部对数衰减重归一化和归一化步长计算进行微分。

与先前内部目标视角的关系。 与测试时训练以及 Titans 和 ATLAS 风格内部内存目标的简要比较移至附录 C.4。

实验

评估在 50B token 预算下训练 124M-130M 参数语言模型,通过困惑度、下游准确率和变长加法诊断比较 Falcon 变体与 Transformer 和循环基线。Falcon-1.3 在困惑度和单样本准确率上领先,而 Falcon-1A.2 在零样本平均上最佳,归一化更新和上下文条件参数产生针对性提升。在加法任务上,Falcon-3A.3 和 Falcon-1A.3 实现了最佳外推,优于基线,支持了偏移、归一化快权重更新改善因果存储和长度外推而不牺牲语言模型质量的论点。

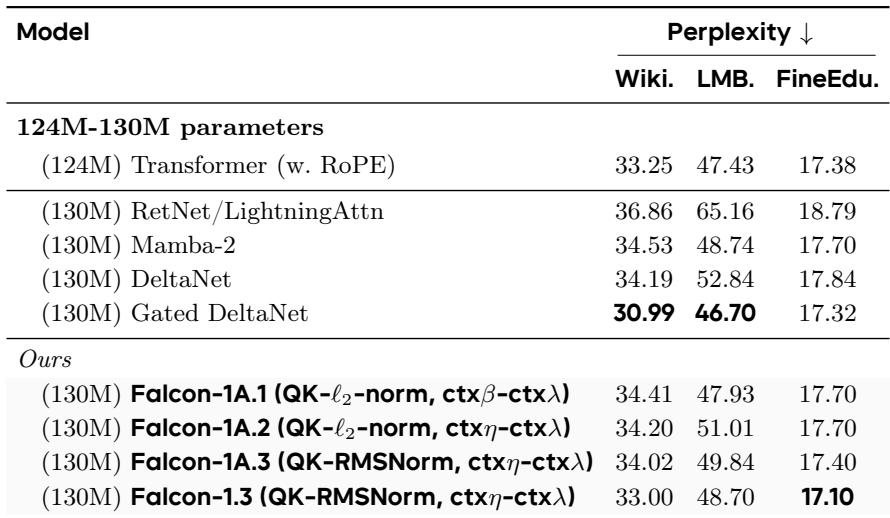
在 124M-130M 参数和 50B token 预算下,所提出的 Falcon-1.3 模型在所有列出的模型中实现了最佳的 FineWeb-Edu 困惑度,优于 Transformer 和循环基线。在循环基线中,Gated DeltaNet 最强,而 Falcon-1A.3 在内积变体中领先。结果表明,所提出的对齐、归一化更新保持了有竞争力的语言建模质量。Falcon-1.3 实现了最低的 FineWeb-Edu 困惑度,超越了包括 Transformer 和 Gated DeltaNet 在内的所有基线。Gated DeltaNet 是 FineWeb-Edu 上最佳的循环基线,但仍落后于 Falcon-1.3。Falcon-1A.3 是最佳内积变体,困惑度接近最佳循环基线。QK-RMSNorm 在小标量消融中相比 QK-l2 归一化改善了 FineWeb-Edu 困惑度。
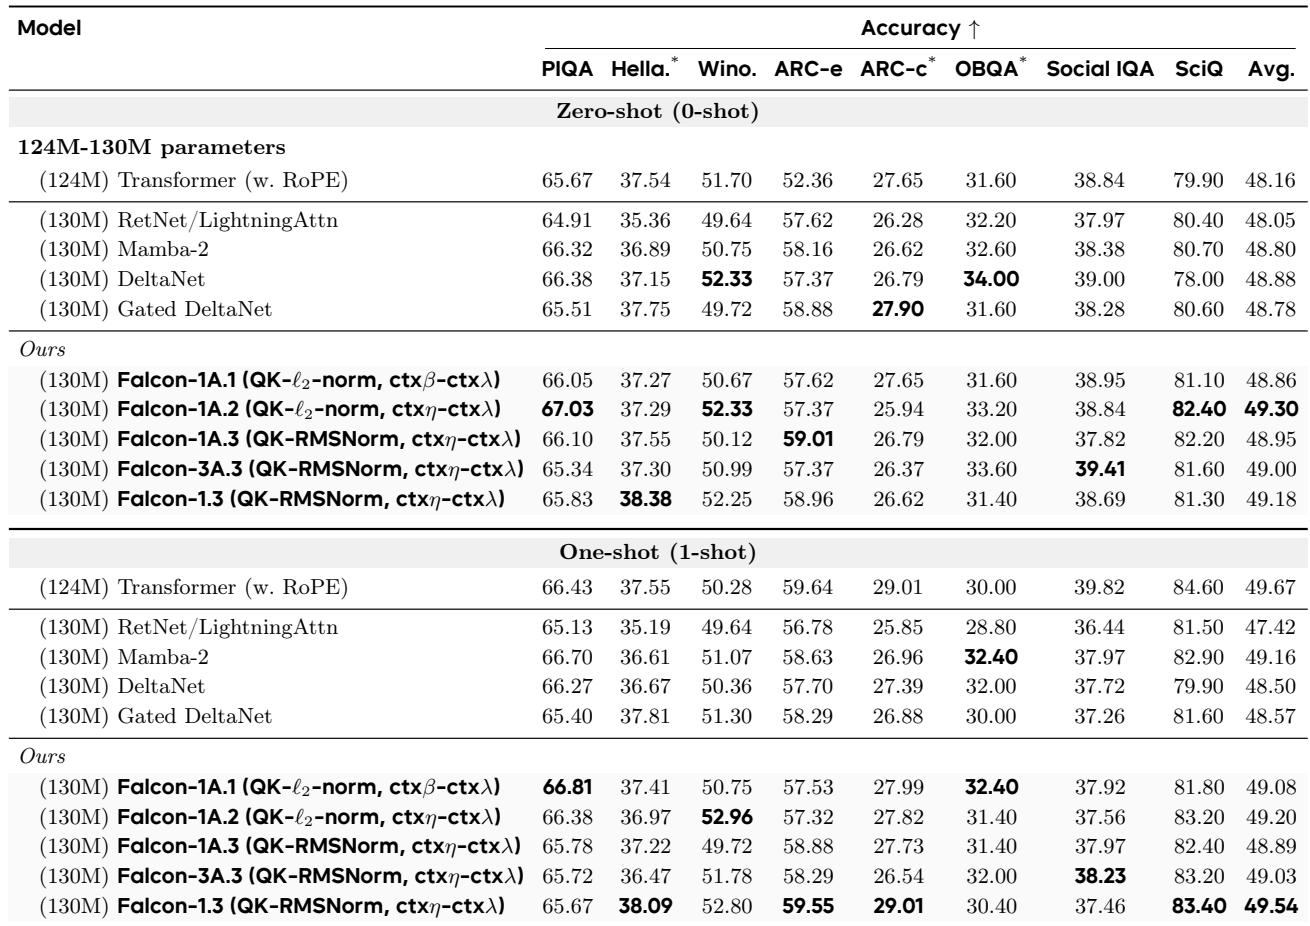
在 124M-130M 下游评估中,所提出的 Falcon 变体实现了有竞争力的零样本和单样本平均值,其中 Falcon-1A.2 在循环模型中零样本领先,Falcon-1.3 单样本领先。结果显示没有对基线的统一优势,但对齐、归一化更新保持了语言模型质量,同时实现了受控的算术增益。Falcon-1A.2 在列出的模型中实现了最佳零样本平均,而 Falcon-1.3 具有最佳的循环单样本平均。在循环基线中,DeltaNet 和 Mamba-2 在零样本平均上优于 RetNet/LightningAttn。所提出的变体并未统一超越基线,但在各任务上保持有竞争力的下游准确率。
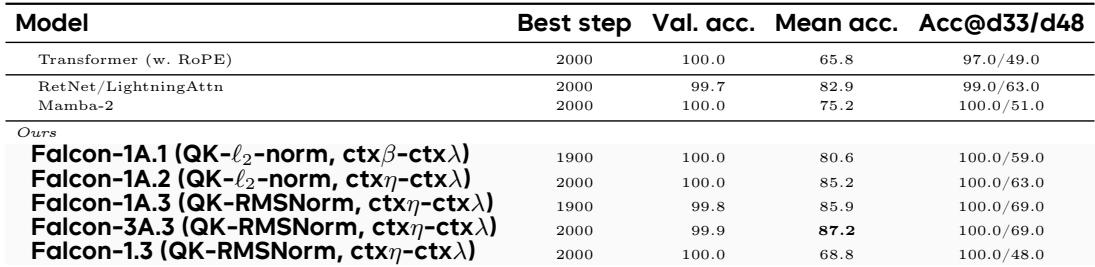
在变长多位数字加法上,所提出的 Falcon 变体在验证准确率上普遍匹配或超过基线模型,同时在更长数字长度上表现出更强的外推能力。在列出的模型中,Falcon-1A.3 实现了最高的平均准确率和最长测试长度上的最佳准确率,超越了 Transformer 和循环基线。Falcon-1A.3 在所有列出的模型中达到最高平均准确率,优于 Transformer 和 RetNet/LightningAttn。所有 Falcon 变体都达到接近完美的验证准确率,Falcon-1A.3 略低为 99.8%。在最长数字长度上,Falcon-1A.3 实现了最佳准确率,而 Transformer 和 Mamba-2 明显落后。
评估涵盖语言建模、下游任务和算术推理。在 124M-130M 参数下,Falcon-1.3 在所有基线中实现了最佳的 FineWeb-Edu 困惑度,Gated DeltaNet 是最强循环竞争者,Falcon-1A.3 在内积变体中领先。在下游零样本和单样本平均值上,Falcon 变体保持竞争力但未统一超越基线,其中 Falcon-1A.2 在循环模型中零样本领先,Falcon-1.3 单样本领先。在变长多位数字加法中,Falcon 变体在验证准确率上匹配或超过基线,并在更长数字长度上表现出更强的外推能力,Falcon-1A.3 实现了最高平均准确率和最长测试长度上的最佳性能。总体而言,对齐、归一化更新保持了语言模型质量,同时实现了受控的算术增益。


用 AI 构建 AI

从创意到上线——通过免费 AI 协同编码、开箱即用的环境和最优惠的 GPU 价格,加速您的 AI 开发。

AI 协同编码
开箱即用的 GPU
最优定价

HyperAI Newsletters

订阅我们的最新资讯
我们会在北京时间 每周一的上午九点 向您的邮箱投递本周内的最新更新
邮件发送服务由 MailChimp 提供