Command Palette
Search for a command to run...
Dr. Claw:面向氛围研究的人工智能科学家工作空间
Dr. Claw:面向氛围研究的人工智能科学家工作空间
摘要
命令行编码代理(例如 Claude Code、Gemini CLI)已经能够读写文件并维持长时间会话,然而端到端研究仍然分散在聊天工具、IDE、终端和写作环境中,而且使研究可审计的决策很少被保留。我们提出了 Dr. Claw,一个开源工作空间,它包装现有的编码代理执行器,在可控且可审计的人机协同工作流程中运行,而不是引入另一个自主代理。持久化状态对象、可复用的技能库以及多执行器协调将人类决策与人工智能执行联系起来,将规划、执行和写作转化为一个可追踪、可恢复的循环。我们通过一个交互式三视图场景和一个故障恢复演练来演示 Dr. Claw,并将其与共享相同后端执行器的裸命令行代理进行评估,从而对比整个编排层(任务图、状态对象和技能库)与其所包装的代理。在保持执行器固定的情况下,Dr. Claw 在研究完整性方面得分更高,同时持久化了可审计、可恢复的过程轨迹。演示访问:仓库 https://github.com/OpenLAIR/dr-claw,以 AGPL-3.0 许可证发布,包含 GPL-3.0 上游组件。
一句话总结
来自理海大学、伊利诺伊大学芝加哥分校、宾夕法尼亚大学、马里兰大学、圣母大学和不列颠哥伦比亚大学的研究人员提出了 Dr. Claw,一个开源工作区,将现有的编码 agent 执行器封装在可控、可审计的人机协同工作流中,利用持久化状态对象、可复用的技能库和多执行器协调,将人类决策与 AI 执行相连接,与使用相同后端的裸命令行 agent 相比,实现了更高的研究完整性和可追踪、可恢复的过程记录。
核心贡献
- 正式定义了 Vibe Research,一种可控的、人机协同的研究编排范式,将 AI 执行与人类决策责任分离,与端到端自主方法形成对比。
- 在 Dr. Claw 中实现了该范式,这是一个开源工作区,通过以任务图为中心的编排、聊天驱动的规划器、模块化技能库(五个阶段映射 58 项技能,部署目录中包含 171 项)以及兼容主流编码 agent 的多 agent 执行层,封装现有的命令行编码 agent。
- 一项控制试点评估在固定后端执行器的情况下显示,Dr. Claw 通过弥补研究卫生缺口,在研究完整性上得分高于裸 agent,同时持久化可审计、可恢复的过程记录;一项回顾性研究进一步将集成工作流与非集成工作流相比,关联到效率、质量和可用性的提升。
引言
大型基础模型和 agent 工具改善了文献综述、想法生成和代码实现等核心研究操作,但命令行编码 agent 优化的是执行而非控制。计划、中间决策和产物往往分散或丢失,留给人类的显式接管点很少。瓶颈在于全流程编排:研究人员仍需在不同工具之间切换以进行分解、调度、跟踪和验证,这削弱了可复现性和交付可靠性。人机交互证据表明,协作成本主要由验证和上下文维护主导,过程可见性和可中断控制至关重要。先前的端到端自动化或通用多 agent 框架研究很少优先考虑长时程工作流中的可控性或持续的人类接管。
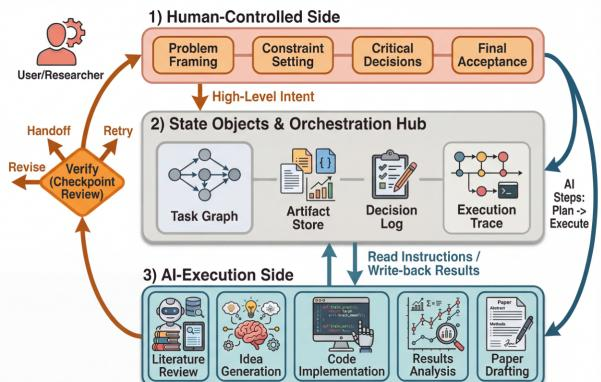
作者提出了 Dr. Claw,一个一站式工作区,将规划、执行和写作统一为可控、可追踪、可恢复且可审计的研究循环。他们正式定义了一种名为 Vibe Research 的范式,其中 AI 负责高吞吐量的执行任务,而人类拥有研究方向、评估标准和最终验收权。Dr. Claw 封装现有的命令行编码 agent,而非引入新的执行器,并增加了此类 agent 所缺乏的状态、控制和审计层。它采用以任务图为中心的编排、聊天驱动的规划器,以及包含五个研究阶段中 58 项阶段映射技能的模块化技能库。系统持久化四个状态对象:任务图、产物存储、决策日志和执行轨迹。一项控制试点评估在固定后端执行器的情况下显示,Dr. Claw 在完整性上得分高于裸 agent,同时独特地持久化可审计、可恢复的过程记录。一项回顾性人类研究提供了关于效率、质量和可用性提升的补充证据,相对于非集成工作流。
方法
3 系统概述
Dr. Claw 围绕一个核心问题设计:如何让研究人员在连续工作流中完成问题定义、实验推进和论文产出,而非在孤立工具之间切换。它将研究建模为显式可追踪的工作流,将人类决策与 AI 执行组织为稳定的协作结构。
3.1 设计目标与系统抽象
Dr. Claw 编排四个状态对象:任务图、产物存储、决策日志和执行轨迹。它们共同将交互历史转换为可审查的过程,支持迭代编排而非一次性生成:用户提供高层目标和约束,系统将其映射为可执行任务,并支持持续检查和接管。一次任务交互是一次状态转换:
Statet+1=f(Statet,Actiont,Obst),其中 State 表示时间 t 时的工作流状态(由任务图、产物存储、决策日志和执行轨迹共同构成),Actiont 是系统或用户触发的动作,Obst 是观察到的反馈。该公式强调 Dr. Claw 优化的是迭代状态更新而非单次响应。
3.2 三层系统架构
Dr. Claw 使用三个协作层:
- 交互:统一的聊天、任务视图、文件和版本操作工作区。
- 编排:从高层意图到阶段任务的状态和生命周期管理。
- 执行:跨异构执行器的后端调用、结果返回和异常处理。
该设计支持在不改变工作流语义的情况下切换后端,同时保持统一的状态和审计视图。
3.3 以工作流为中心的交互循环
给定一个研究想法,系统生成结构化简报和依赖感知的任务计划,然后运行“规划–执行–验证–回写”的工作流步骤。执行输出写入产物存储,任务状态在任务图中更新,所有干预保留在决策日志和执行轨迹中。该工作流支持带显式人类检查点的长时程迭代。
3.4 基于技能的能力与多执行器协调
Dr. Claw 提供可复用的技能库,涵盖构思、文献处理、实验、分析和写作。每项技能是一个包含 SKILL.md 清单的目录,其 YAML frontmatter 声明名称和描述,通常还包含版本、许可证、允许的工具以及阶段或领域标签。技能在激活前经过版本化和模式检查,并通过三条路径到达任务:阶段–技能映射将任务的阶段和类型解析为一组建议技能,附加到任务节点并注入其下一步操作提示;对用户指令和任务文本的关键词检测可自动加载技能;用户也可以从技能仪表板手动调用目录中的任何技能。Dr. Claw 还在一个项目上下文中协调多个执行器,使用户可以根据任务类型切换执行策略,并在失败或违反约束时重试、修改或接管,而不会破坏全局状态。
3.5 安全与可控性机制
鉴于外部调用和代码执行的风险,Dr. Claw 将权限管理视为一等机制,支持细粒度的工具和命令策略,区分安全默认设置与受信任的扩展设置。动作仅在属于当前策略定义的动作集时才被允许:
Actiont∈A(Policyt),其中 Policy 是时间 t 时的权限配置,A(Policyt) 是可执行动作空间,保证了执行能力与安全边界之间的一致性。
实验
评估使用一个演示场景和三项研究来验证 Dr. Claw,即命令行编码 agent 之上的编排层。在与裸 agent 的开放式研究任务对比中,Dr. Claw 在三个任务中的两个上实现了更高的完整性(合并 0.952 对比 0.873),增益完全来自研究卫生元素,如局限性章节、亚组分析和真实引用,而两种条件在建模严谨性上匹配;然而,试点结果在统计上不显著,且 Dr. Claw 带来有限的额外开销。一项单独的单条件演示展示了非破坏性故障恢复,其中诱导的错误被就地修正,同时保留先前的产物。一项涉及七名研究人员跨三个阶段的回顾性人类研究将 Dr. Claw 与更短的完成时间、更高的输出质量、更少的工具切换以及自我报告体验中最显著的改善相关联。
该表格在执行、编排、交互和自主性维度上比较了 Dr. Claw 与先前系统,显示 Dr. Claw 独特地结合了封装 CLI agent、内置研究状态对象和运行中接管。大多数先前系统仅支持其中部分功能,而 Dr. Claw 是唯一集成所有功能的系统。Dr. Claw 是唯一同时完全支持内置研究状态、就地恢复和运行中接管的系统。像 AI Scientist 和 Agent Laboratory 这样的端到端自主系统优先考虑无人值守操作,但缺乏内置研究状态和运行中接管。像 AutoGen Studio 这样的 agent 创作工具支持编排,但不封装 CLI agent 或提供内置研究状态。Dr. Claw 的设计通过持久化状态对象强调人类监督,与不持久化此类状态的裸 agent 形成对比。
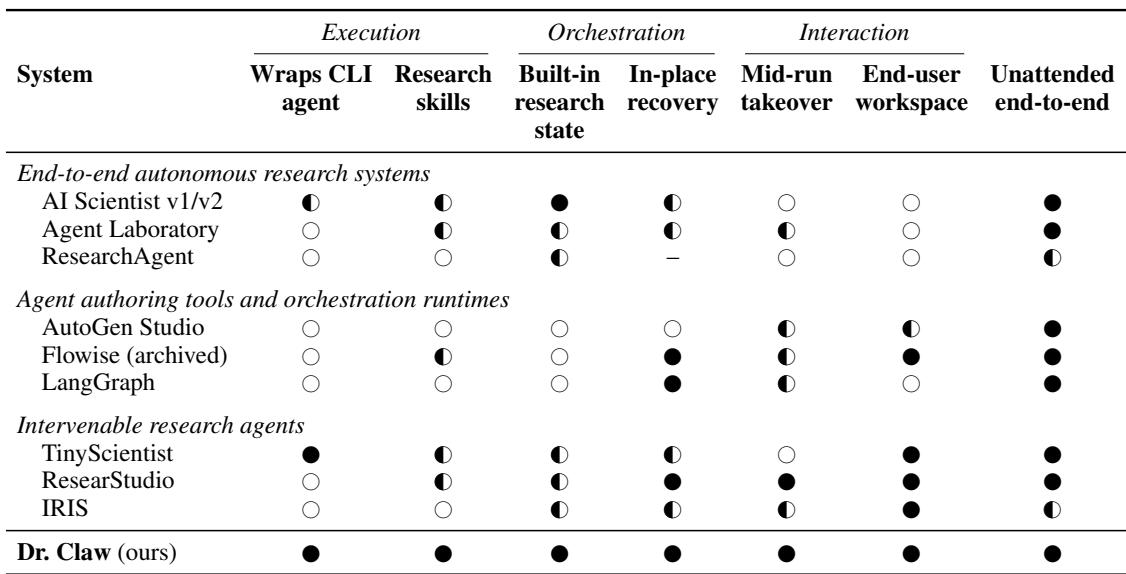
一项跨执行、编排、交互和自主性的比较评估显示,Dr. Claw 独特地集成了封装的 CLI agent、内置研究状态对象和运行中接管,而先前系统仅支持这些能力的子集。与优先考虑无人值守操作的端到端自主系统和专注于编排的 agent 创作工具不同,Dr. Claw 是唯一结合所有三项功能的系统,通过持久化状态对象而非无状态操作来强调人类监督。