Command Palette
Search for a command to run...
双层协调反思:多智能体 LLM 系统的博弈论方法
双层协调反思:多智能体 LLM 系统的博弈论方法
Yihang Chen Yuxiang Chen Yuxuan Huang Meng Fang Weilin Luo Jun Wang
摘要
多智能体 LLM 系统通常使用一个编排器将任务分解给一组工作智能体,然后通过文本反思进行改进。尽管取得了强大的实证结果,这些系统缺乏对协调、记忆改进和外部验证作用的统一解释。我们将编排器与工作智能体之间的交互建模为双层协调博弈:在有界耦合下,工作智能体的局部更新博弈是一个近似势博弈,其均衡松弛由分解质量控制。然后,我们将反思分析为语义记忆状态上的随机运动。对于自由形式的反思,我们推导了一个有限时间上界,证明了最坏情况下的紧致性,并在可证伪的持续危害条件下给出了一个正下界。我们进一步证明了一个信息论不可能性结果:任何仅观察生成文本的门控都无法在文本不可区分环境中统一改进,而环境接地门控可以。受这一分离的启发,我们引入了随机反思记忆上升(SRMA),它仅在接地评估风险严格降低后才接受候选记忆。在校准和非退化纠正质量下,SRMA 精确收敛,几何或多项式速率;匹配构造表明两种速率机制都是阶紧的。我们还为随机评估提供了置信门控,并为分段平稳环境提供了重新锚定保证。实验用环境接地指标实例化了这些对象,并测试了预测的协调和漂移规律。在 500 个 SWE-bench 实例上,完整的基于 Kimi 的系统解决了 72.2%,而公开的 mini-SWE-agent 参考为 70.8%。代码可在 https://github.com/YihangChen9/ Bilevel-Coordinated-Reflection 获取。
一句话总结
来自UCL人工智能中心、利物浦大学和华为的研究者提出了一个博弈论框架,将编排者与执行者之间的交互建模为双层协调博弈,证明了反思的收敛界,并引入了随机反思记忆上升(SRMA)算法,该算法仅在基于接地评估风险下降时接受候选记忆,在500个SWE-bench实例上达到72.2%,而参考基线为70.8%。
核心贡献
- 引入随机反思记忆上升(SRMA),仅在固定接地评估协议验证验证器风险严格下降时才提交候选记忆,并在校准和非退化修正质量条件下证明精确的几何或多项式收敛,同时提供置信门控和重新锚定扩展。
- 将编排者与执行者之间的交互建模为双层协调博弈,表明跟随者均衡松弛度受分解耦合控制,并推导出自由形式反思的双侧漂移分析,具有最坏情况紧上界和在持续危害条件下的正下界。
- 在受控环境(隐藏上限资源竞赛和具有精确BFS值表的Overcooked)以及SWE-bench上验证理论,完整Kimi系统解决361/500个实例(72.2%),而公开mini-SWE-agent v2参考为70.8%。
引言
多Agent LLM系统现已成为处理单模型难以胜任的大规模或结构化任务的标准方法:编排者分解问题,执行者解决各子任务,团队通过共享文本记忆反思自身输出来改进。由于模型权重在测试时冻结,编辑该记忆是主要的适应方式,而此类循环在测试框架、模拟器或形式化检查器的接地下通常效果更好。然而,现有框架以过程化方式描述这些系统,指定谁与谁通信以及哪些缓冲区被更新,但未能捕捉Agent稳定到的战略目标或反思实际改进的内容。这留下了三个关键问题:编排者的分解质量如何控制执行者协调,无条件反思何时停滞而非收敛,以及为什么外部验证器能在更强的纯文本评判者仍然失败时成功。
作者用一个统一框架解决这些问题。他们将编排者-执行者流水线建模为双层协调博弈,其中跟随者子博弈是近似势博弈,文本记忆编辑则是在离散语义状态空间上的随机过程。对于自由形式反思,他们推导出单侧漂移条件,产生有限时间上界,在最坏情况下是紧的,但表明通用正下限需要额外的、可显式测试的持续危害条件;仅靠无条件提交是不够的。随后,他们通过构造两个具有相同文本生成规律但相同反思含义相反的环境,隔离了验证的信息作用。任何仅观察转录的门控,即使是理想的纯文本评判者,在这两个环境中行为相同且无法同时改进两者,而接地验证器能够区分这对环境并恢复几何收敛。
受此分离的启发,作者引入随机反思记忆上升(SRMA),仅在固定接地评估协议验证验证器风险严格下降时才提交候选记忆。在校准和非退化修正质量条件下,SRMA以阶紧的几何或多项式速率精确收敛,并具有用于随机探测的置信门控和用于分段平稳性的重新锚定。他们在隐藏上限资源竞赛、具有精确BFS值表的Overcooked以及SWE-bench上验证了理论,完整Kimi系统解决361/500个实例(72.2%),而公开mini-SWE-agent v2参考为70.8%。关键贡献包括:将分解耦合与跟随者均衡松弛度联系起来的双层协调博弈、自由形式反思的双侧漂移分析、自包含纯文本门控的不可能性定理、具有精确收敛保证的SRMA算法,以及跨受控和端到端基准的机制级验证。
方法
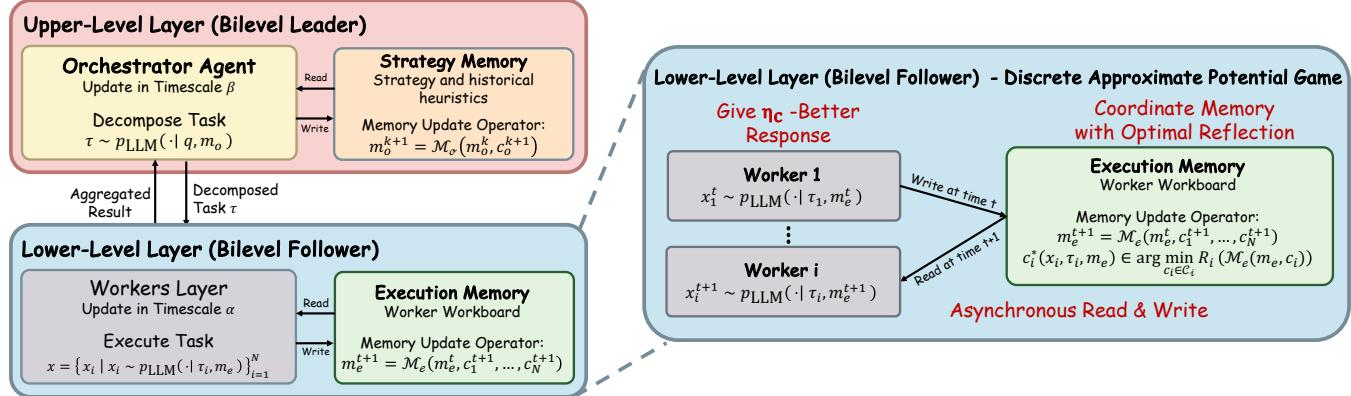
作者将多Agent LLM协调形式化为双层博弈。编排者作为领导者,从查询q生成策略配置τ=(τ1,…,τN),为每个执行者分配子任务。每个执行者随后产生局部子解xi,全局输出为这些局部输出的拼接。与理想化的独立分解不同,真实系统通过共享变量、接口和联合约束表现出跨执行者交互。为捕捉这一点,作者采用弱耦合分解,其中全局效用表示为局部执行者目标之和加上交互图E上的成对耦合项ψij(xi,xj):
U(x)=i=1∑Nui(xi∣τi)+(i,j)∈E∑ψij(xi,xj∣τi,τj).耦合项的幅度(以κ为界)和交互图的最大度dmax共同量化分解质量。当κ=0时,系统退化为独立情形。作者证明,在此弱耦合结构下,执行者的子博弈是ηc-近似势博弈,松弛度ηc≤2dmaxκ。该结果确保执行者的迭代更优响应更新在有限步内收敛到ηc-近似纯策略纳什均衡。领导者的目标是预测该均衡并选择最大化期望全局效用下界的分解,在可实现的局部效用与耦合成本之间进行权衡。
由于LLM权重冻结,适应通过编辑外部非参数记忆实现:执行者共享的执行记忆和编排者使用的策略记忆。作者在两种机制下分析这些记忆的动态。在自由形式反思机制中,每个生成的反思被无条件追加,混合修正信息和幻觉信息。在单侧漂移条件下,期望次优性以因子γt下降但产生残余误差负载νt,作者推导出期望次优性的有限时间上界:
eT≤(1−γ)Te0+γν(1−(1−γ)T).该界收敛到ν/γ,并证明在最坏情况下是紧的。然而,这仅是上界保证。在持续危害提交假设下,其中下侧漂移条件成立,作者建立通用下界:
T→∞liminfeT≥γν>0.这表明在没有筛选的情况下,平均误差无法消失,从而建立了幻觉下限。由上界和下界形成的双侧误差管刻画了记忆动态的渐近行为。领导者的外层循环在较慢的时间尺度上运行,具有类似的仿射递归产生有限回合界,但不作渐近遗憾声明。
作者随后建立了自包含门控的基本不可能性结果。自包含门控是任何仅关于生成文本过程及其内部随机性的可测接受规则,包括纯文本LLM即评判者系统。作者构造了两个在文本层面不可区分的环境,其中相同反思在一个环境中是修正性的,在另一个环境中是有害的。在此构造下,对于任何自包含门控和任何时间范围,两个环境上的最大期望次优性至少为初始误差:
max{eTε+,eTε−}≥e0.如果模糊提案以正概率被接受,则该结果是严格的。相比之下,观察环境相关信号的接地门控实现误差的指数收敛到零。该定理表明,当真相取决于外部状态(如隐藏上限、API响应、模拟器状态或演进的代码库)时,文本自评估不能替代接地。
基于这一不可能性结果,作者提出SRMA,一种验证器门控反思机制。关键设计原则是将随机提案机制与接地评估协议分离。验证器是从输出和任务到诊断分数的确定性映射,记忆的验证器风险是在固定确定性协议下评估输出的分数。SRMA更新以当前输出、诊断、任务和记忆为条件采样反思,形成候选记忆,且仅在验证器风险严格下降时接受:
Ri(met+1)<Ri(met).这种对确定性风险而非两个不受控的一次性样本的门控对于精确保证至关重要。在验证器校准假设(零验证器风险保证零任务次优性)、非退化修正质量和成比例接受递减假设下,作者证明验证器风险几乎必然收敛到零。当接受概率与风险成正比(β=0)时收敛速率为几何速率,当接受概率随风险的幂次缩放(β∈(0,1])时为多项式速率:
β=0:rT≤(1−c)Tr0,(geometric), β∈(0,1]:rT≤(r0−β+cβT)−1/β,(polynomial).这些速率被证明在常数因子内是紧的。对于确定性风险评估不可用的实际场景,作者提供置信门控随机评估程序。通过使用独立探测估计当前和候选风险,并仅在置信区间不重叠时接受,该方法以高概率保证每次接受的更新严格降低真实期望风险。最后,作者通过将分析在最终变化点处重新锚定来处理分段平稳环境,使收敛保证适用于最终平稳段。
实验
评估涵盖Resource Contest、Overcooked和SWE-bench,使用接地环境信号或代码库测试框架作为验证器。在这些设置中,接地SRMA持续优于纯文本或无门控基线,提高oracle奖励达成率、协调分数和下游任务解决率,同时降低遗憾和有害提案接受率。自适应门控在较低成本下提供与固定验证相当的统计效率,重新锚定能够快速检测分布偏移。端到端软件修复结果表明,接地、门控的多Agent协调相比无门控反思带来显著提升,且收益归因于接地机制而非模型选择。
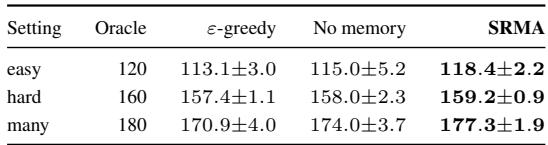
在匹配的交互和模型调用预算下,接地自门控记忆方法(Grounded SRMA)在Overcooked所有布局中持续优于所有基线,在协调需求最高的布局中增益最大。结果表明,将协调信号接地于环境反馈而非依赖自由形式或无门控记忆,可产生更高的交付分数。Grounded SRMA在所有三个Overcooked布局中取得最高分数,在centre_pots布局中与无记忆基线的差距最大。无接地的自门控记忆优于自由形式记忆,表明选择性记忆使用本身即可改善协调。接地与自由形式方法之间的差距随布局协调需求增加而扩大,从cramped_room到centre_pots。
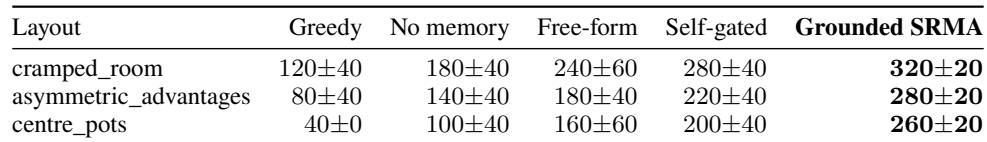
在所有RC设置中,SRMA持续实现最高累积奖励,达到oracle奖励的98.5%至99.5%。执行记忆消融表明,添加记忆使平均奖励提高2.6分,平均遗憾降低60.8%,证明接地上限证据在存在记忆时成为功能性协调通道。SRMA在每种设置中均优于epsilon-greedy和无记忆基线,在多执行者场景中增益最大。执行记忆将平均遗憾从4.33降至1.70,提升60.8%,同时平均增加2.6奖励分。hard设置与oracle差距最小,SRMA达到160中的159.2,表明在紧密排列的上限下实现精确分配。
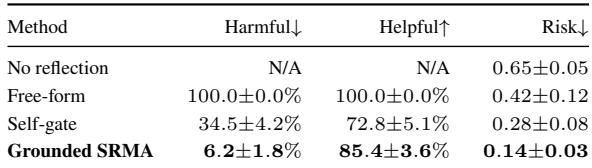
具有自门控的Grounded SRMA相比自由形式或无反思基线大幅降低有害提案接受率和总体风险,同时保持高有益接受率。该方法还提高了协调效率,例如更快地重新锚定到变化的最优点并降低遗憾,适用于不同环境。Grounded SRMA将有害接受率降至6.2%,风险降至0.14,而自由形式反思为100%有害和0.42风险。仅自门控将有害接受率降至34.5%,但也将有益接受率降至72.8%,而Grounded SRMA保持有益接受率为85.4%。重新锚定的接地门控在1.2轮内检测到最优上限的变化并在2.5轮内切换,相比陈旧锚定变体将切换后遗憾降低67%。在SWE-bench中,双层SRMA在Kimi K2.5骨干上解决72.2%的实例,而自由形式多Agent反思为58.4%,DeepSeek上也有类似提升。
在SWE-bench上,具有接地门控的双层SRMA系统在两个骨干上均优于自由形式多Agent基线和单Agent参考,在Kimi K2.5上增益最大。受控DeepSeek运行确认相同趋势,表明改进源于接地、门控协调而非模型选择或计算量。具有接地门控的双层SRMA在Kimi K2.5上解决72.2%的实例,而匹配预算下自由形式多Agent反思为58.4%。接地门控在同一骨干上也超过外部公开mini-SWE-agent v2参考(70.8%)。受控DeepSeek运行显示相同模式:双层SRMA达到71.4%,而单Agent基线为68.2%。
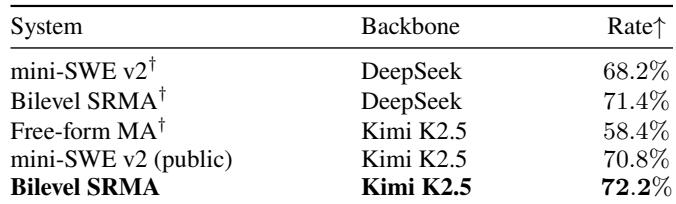
在Overcooked、资源收集和SWE-bench评估中,接地、自门控记忆方法在匹配预算下持续优于自由形式或无门控基线,且增益随任务协调需求增加而扩大。将协调信号接地于环境反馈并使用选择性记忆均改善结果,在协调密集型布局和多执行者场景中边际最大。该方法还降低有害提案接受率和风险,同时保持高有益接受率,并实现更快地重新锚定到变化的最优点且遗憾更低。在SWE-bench上,双层接地门控在两个骨干上解决比自由形式多Agent反思更多的实例,受控运行确认改进源于协调机制而非模型选择。