Command Palette
Search for a command to run...
GroundingPI:基于视觉原语面向物理智能的定位基础模型
GroundingPI:基于视觉原语面向物理智能的定位基础模型
摘要
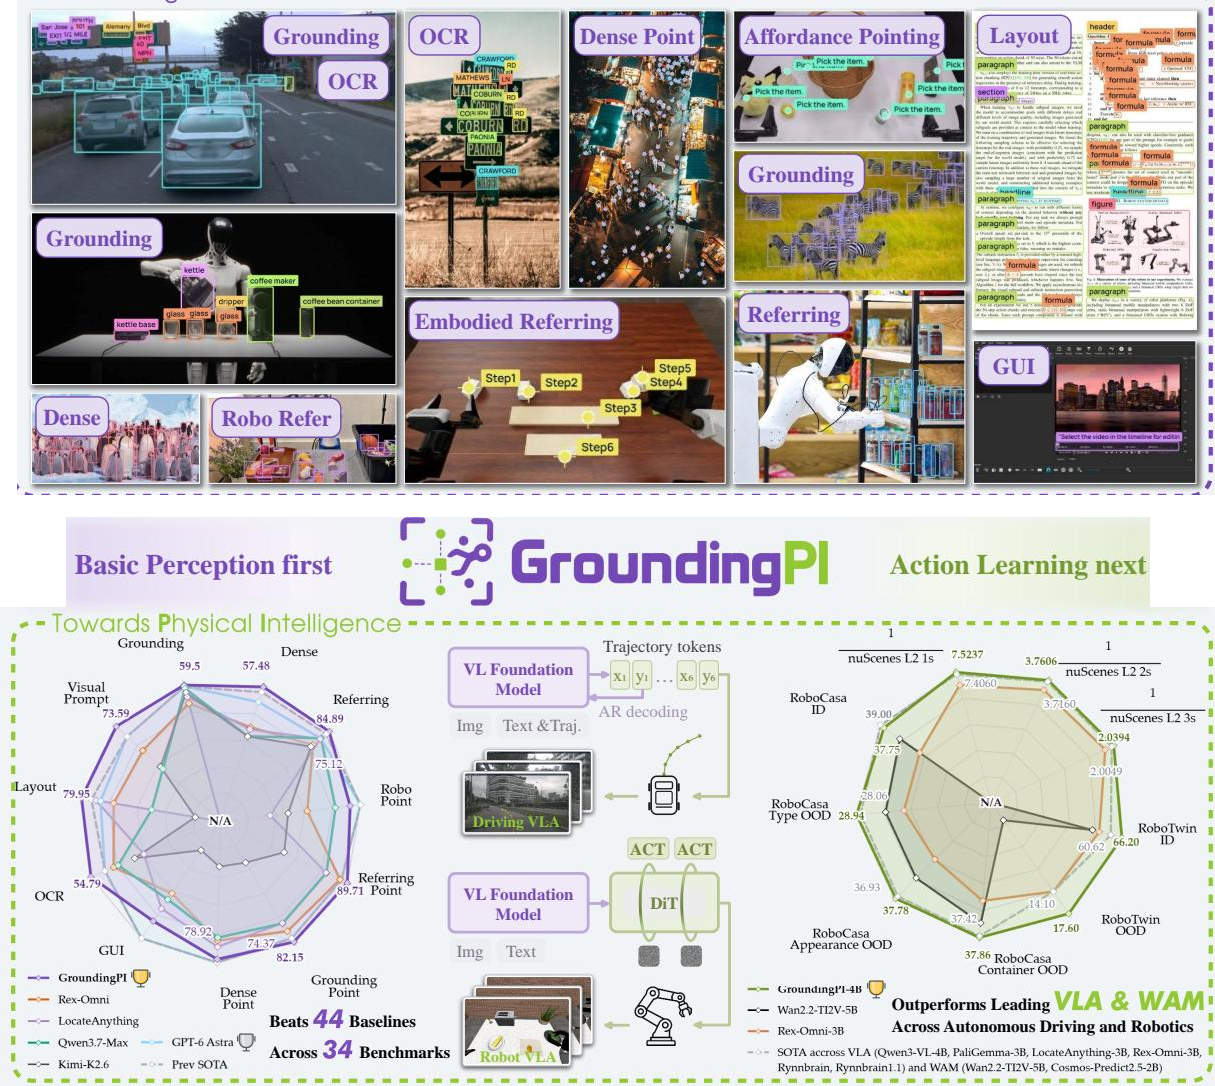
精确的定位至关重要。它指明哪个物体是目标以及该物体在哪里,即便在杂乱场景中、对于微小物体也是如此,并且必须足够快以用于闭环控制。然而,视觉-语言-动作(VLA)和世界-动作模型(WAM)从通用视觉-语言和视频生成骨干中获取感知能力,在这些场景下仍然失效。我们提出 GroundingPI,一个 4B 参数的基础定位模型,它在共享词汇表中以量化坐标生成点和框。训练结合了多模态与空间预训练、监督微调以及使用 GRPO 的强化学习,并利用来自公开数据集和专用数据引擎的监督信号。在涵盖 11 种感知能力的 34 个定位基准上,与 44 个基线相比,GroundingPI 取得了新的最优性能,平均达到 73.68%,超过更大的 GPT-6 Astra(71.54%)。作为下游视觉骨干,GroundingPI 在机器人操作和自动驾驶上提升了性能。在 RoboTwin 2.0 上,它在全部四种分布外设置中均优于我们评估的所有主流骨干,相对最强骨干最高提升 24.8%。在 RoboCasa-GR1 上,仅用 50% 演示训练的 GroundingPI 优于用 75% 演示训练的那些基线。在 nuScenes 上,作为视觉骨干使用时,GroundingPI 取得 0.296 m 的平均开环 L2 误差。我们系统分析了 GroundingPI 预训练在规模和数据构成方面的影响。随着预训练规模扩大,下游自动驾驶和机器人操作性能提升。对这 11 种感知能力的数据配方分析表明,稠密定位对两者均有显著益处,而 OCR 具有作为感知学习催化剂的潜力。这些结果支持将定位作为一种感知基础,并将专门的感知预训练作为物理智能基础模型的一个有前景的方向。
一句话总结
小鹏公司、北京大学等机构的研究人员提出了 GroundingPI,这是一个 4B 参数定位基础模型,它将点和框表示为共享词表中的量化坐标,并通过多模态与空间预训练、监督微调和 GRPO 强化学习进行训练,从而在实现当前最优定位性能的同时改善下游机器人操作与自动驾驶。
核心贡献
- 本文提出 GroundingPI,这是一个 4B 参数定位基础模型,它生成点和框作为共享词表中的量化坐标,并通过多模态与空间预训练、监督微调和 GRPO 强化学习进行训练。GroundingPI 在 34 个定位基准上建立了新的最优水平,平均得分为 73.68%,超过了更大模型 GPT-6 Astra 的 71.54%。
- 本文展示了作为下游视觉骨干向物理智能的迁移。在 RoboTwin 2.0 上,GroundingPI 在所有四个分布外设置中均优于主流骨干,相对最强骨干最多提升 24.8%;在 RoboCasa-GR1 上,使用 50% 演示数据训练的模型优于使用 75% 演示数据训练的基线;在 nuScenes 上,其平均开环 L2 误差为 0.296 m。
- 本文系统分析了预训练规模与数据构成。扩大预训练规模可以改善下游自动驾驶和机器人操作,密集定位对两个领域都有显著益处,OCR 可能作为感知学习的催化剂,支持定位作为感知基础,并支持面向 System 1 物理智能的专用感知预训练。
引言
视觉定位对物理智能至关重要,因为模型必须先定位物体、把手和与任务相关的结构,然后才能规划如何行动。现有视觉-语言-动作和世界-动作模型通常继承通用视觉-语言或视频生成骨干,这些骨干并未针对精确定位进行优化,评估结果也暴露了在密集场景和微小物体上的弱点;近期策略级感知目标往往面向特定任务且难以扩展。为了弥补这一感知差距,作者提出 GroundingPI,这是一个 4B 参数定位基础模型,建立在点和边界框等视觉原语之上,使用共享量化坐标词表统一定位、指称、指向、OCR、GUI 与布局定位以及视觉提示。GroundingPI 通过多模态与空间预训练、监督微调和强化学习进行训练,在 34 个基准上取得了当前最优定位性能,同时有效迁移到自动驾驶和机器人操作。
数据集
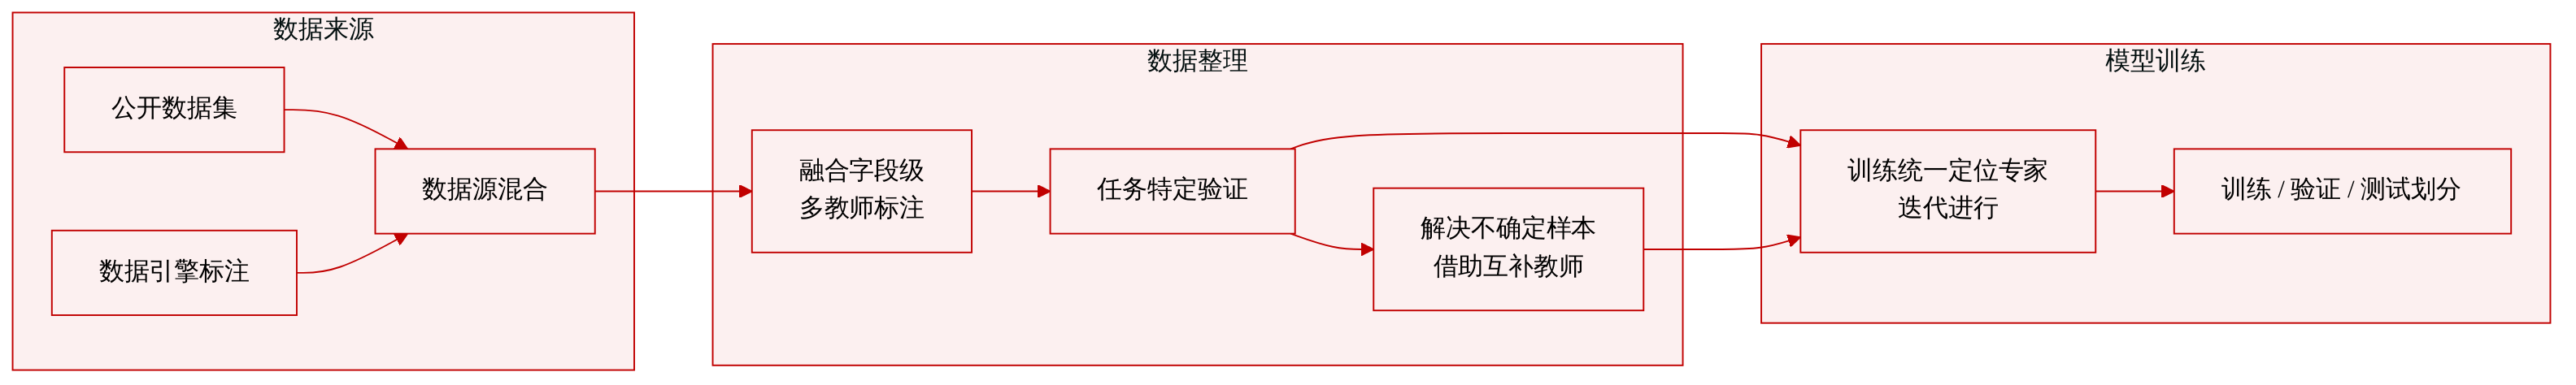
作者将 GroundingPI 数据描述为由公开数据集和模型生成标注构建的混合训练集。
- 来源: 公开数据集与作者数据引擎生成的标注相结合。
- 构成: 摘录未列出具体公开数据集、数据集规模或混合比例。
- 标注处理: 数据引擎在字段级融合多教师标注,并应用任务特定验证。
- 标签精化: 被接受的标签用于训练统一定位专家进行迭代标注。互补教师和局部观察解决不确定情况,以扩展监督并精化已有标签。
- 模型使用: 生成的标签用于迭代训练定位专家,从而改善监督和标签质量。
- 其他处理细节: 字段验证、任务依赖和标签修订记录在第 A.3 节。摘录未具体说明裁剪策略或元数据模式。
方法
GroundingPI 被设计为一个用于语言条件感知的自回归定位基础模型,并作为下游物理智能任务的共享感知骨干。
其核心是将 MoonViT-V2 视觉编码器与 Qwen3-4B 语言解码器耦合。可学习投影器聚合相邻的 2×2 视觉特征,并通过带有 GELU 和输出归一化的两层 MLP 将其映射到语言嵌入空间。
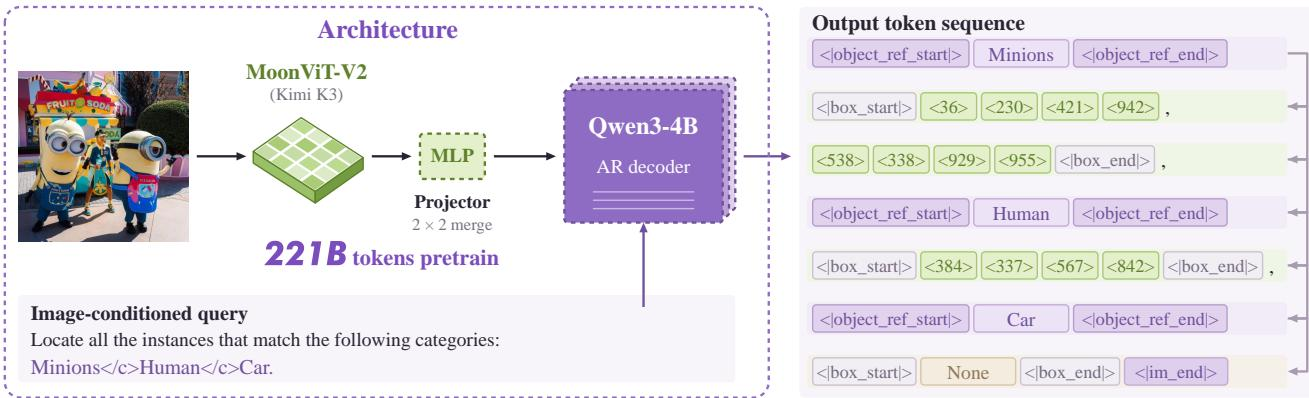
给定图像 I 和查询 P,编码器 Eψ 和投影器 Cϕ 生成视觉嵌入
V=Cϕ(Eψ(I)).随后解码器自回归地生成变长响应 Y:
pθ(Y∣I,P)=i=1∏∣Y∣pθ(yi∣V,P,y<i).语义标签、协议标记和 1,000 个量化坐标 tokens(写作 <0> 到 <999>)共享输出词表。响应长度可变,缺失的查询类别输出为 None。
训练数据将公开数据集与专用数据引擎生成的标注相结合。该引擎在字段级融合多教师标注,并应用任务特定验证。
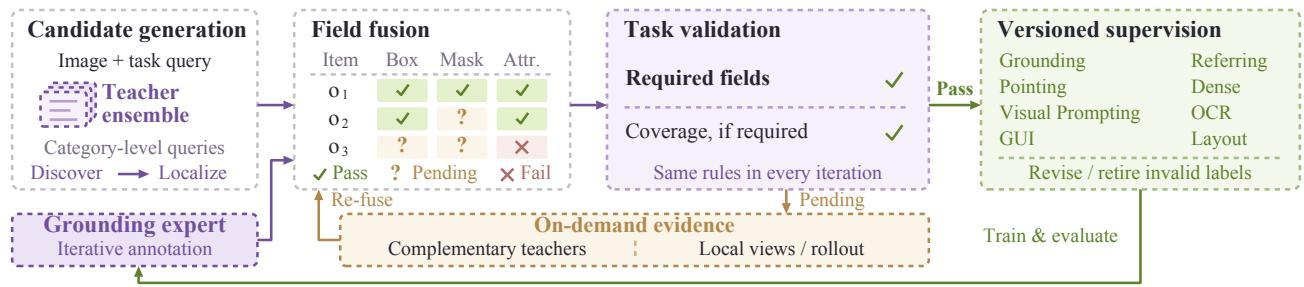
被接受的标签训练统一定位专家进行迭代标注。互补教师和局部观察解决不确定情况,在多轮迭代中扩展监督并精化已有标签。
训练过程包括基础 VLM 训练、监督微调和强化后训练。基础训练首先使用图像-标题监督对齐投影器,同时冻结两个骨干。随后分两个阶段更新所有模块:先在文本和图像-文本监督上进行联合多模态预训练,再通过问答和标题生成进行通用视觉与视频理解。所有阶段都使用因果 next-token 预测。
监督微调将坐标与视觉位置对齐,并学习共享输出协议。在 teacher forcing 下,作者最小化
LSFT=−∣S∣−1t∈S∑logpθ(yt∣I,P,y<t),其中 S 包含助手响应标签、协议标记和坐标,同时排除提示和视觉位置。监督自适应先更新所有模块,然后冻结视觉编码器和投影器,进行语言端的精化。
最后阶段采用 group relative policy optimization。
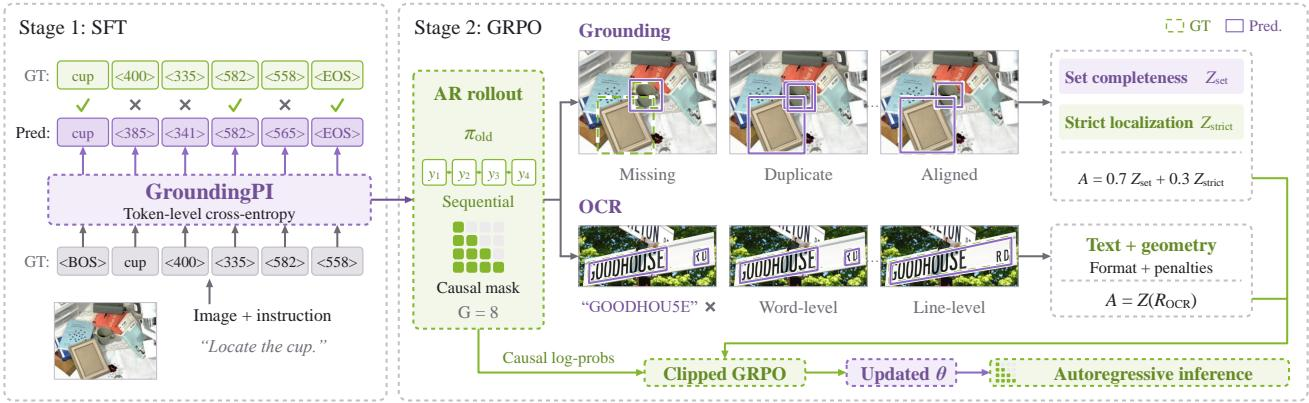
GRPO 对每个图像-查询对采样 G=8 个自回归响应。对于定位,Rset 通过参照级最大 IoU 匹配和类别验证来衡量覆盖率。互补的 Rstrict 结合多阈值 F1、定位、格式、数量和排序得分,并惩罚重复框和过大框。独立标准化后的奖励按如下方式组合:
Ai=0.7Z(Rset,i)+0.3Z(Rstrict,i).对于 OCR,匈牙利一对一匹配在完整词或行视图与互补参照上评估文本和几何。格式门控和输出惩罚产生复合奖励:
Ai=Z(ROCR,i).这里 Z 在提示内标准化每个活跃奖励,组合优势随后在响应批次上标准化。作者优化带冻结 SFT 参考的裁剪 GRPO 目标,并且只更新语言参数。
对于物理智能,GroundingPI 提供用于动作学习的感知接口。在自动驾驶中,任务被形式化为语言条件轨迹预测。给定当前前视图像和历史自车状态,模型将未来轨迹表示为六个有序路径点,时间间隔为 0.5 秒,覆盖三秒时域。每个路径点指定当前自车坐标系中的累积位置,前向和左向轴以米为单位。固定度量范围将这些坐标映射到现有的 <0> 到 <999> 词表。语言头自回归生成轨迹,仅响应的交叉熵提供自适应目标。解码恢复度量路径点,同时保持时序顺序。
对于机器人操作,作者采用带逐层连接的 π 风格流匹配策略。预训练基础模型对视觉观察和语言指令进行一次编码。其中间特征经过投影和重采样,然后注入到 Action DiT 的对应交叉注意力层中。以这些特征和机器人状态为条件,动作专家将含噪动作块去噪为连续控制量。在受控比较中,Action DiT、机器人数据、动作表示、优化预算和推理过程保持不变,仅改变预训练基础模型。
实验
实验在广泛的感知基准以及包括自动驾驶和机器人操作在内的下游物理智能任务上评估紧凑定位基础模型 GroundingPI。基准结果表明,相对于同类模型,其在密集检测、空间与 GUI 定位、OCR、布局和目标指向上表现较强,但某些困难设置仍然有限。使用固定动作学习器的迁移测试表明,更强的定位感知有助于降低驾驶误差、提高操作成功率、改善分布外泛化,并实现更数据高效的动作学习。消融进一步表明,扩大定位预训练可以同时改善感知和操作,密集定位提供核心空间信号,辅助 OCR、布局和 GUI 监督与完整混合数据结合时会放大迁移效果,感知原生基础模型可能更适合快速执行,而更广泛的推理模型更适合规划。
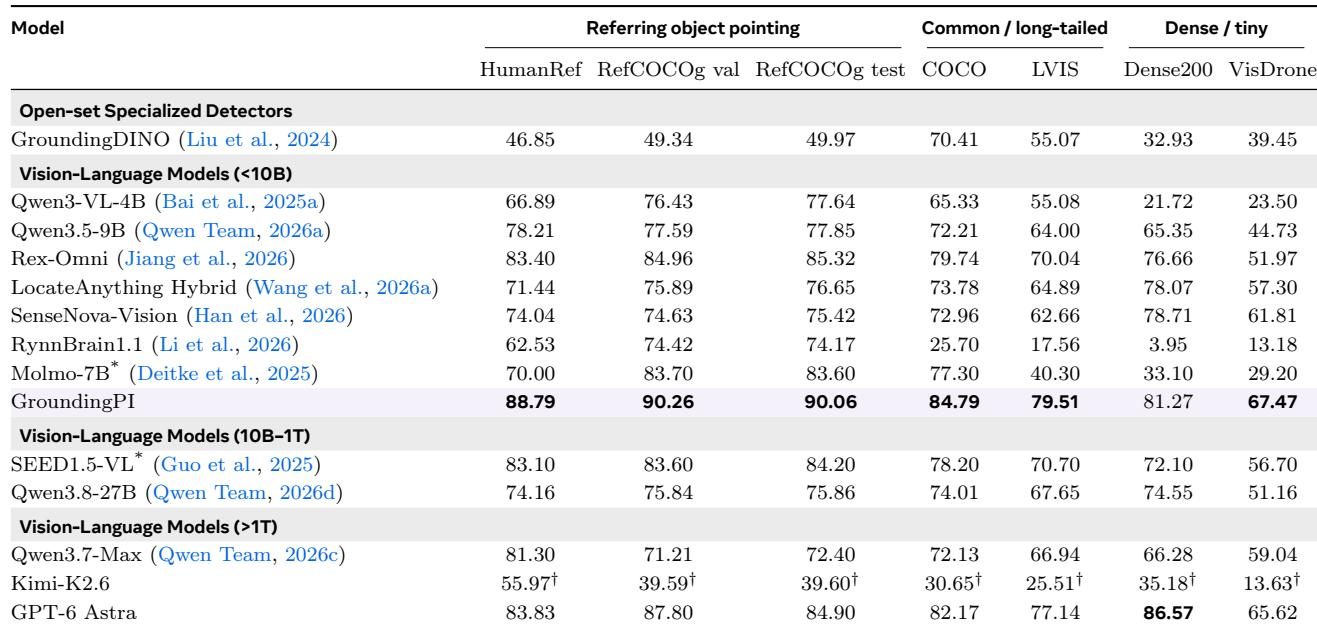
GroundingPI 在检测和指称定位套件上达到 73.68% 的平均分,领先于同规模模型,并与前沿参照模型的 71.54% 具有竞争力。所示开放集检测器在常见物体和长尾检测上强于密集和微小物体检测,后者的得分明显更低。指称定位结果介于常见检测和密集检测之间,表明覆盖范围较广,但定位挑战仍然存在。GroundingPI 的整体定位平均分超过同规模模型,并与前沿参照模型具有竞争力。开放集专用检测在 COCO 上相比封闭集检测器有所改善,但在密集和微小物体基准上仍然弱得多。该开放集检测器在 RefCOCOg 上的得分高于 HumanRef,表明指称定位随基准难度而变化。量化坐标和 MoonViT-V2 编码器有助于提升模型相对其他设计选择的平均性能。
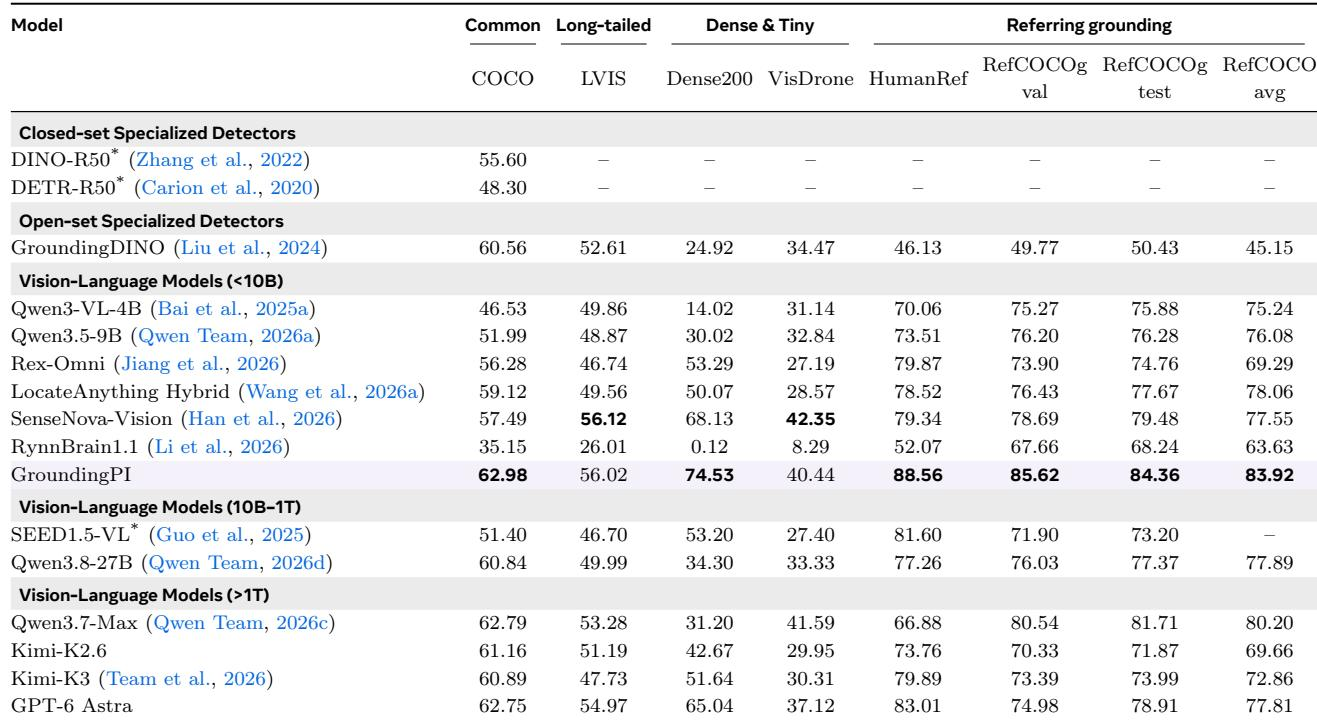
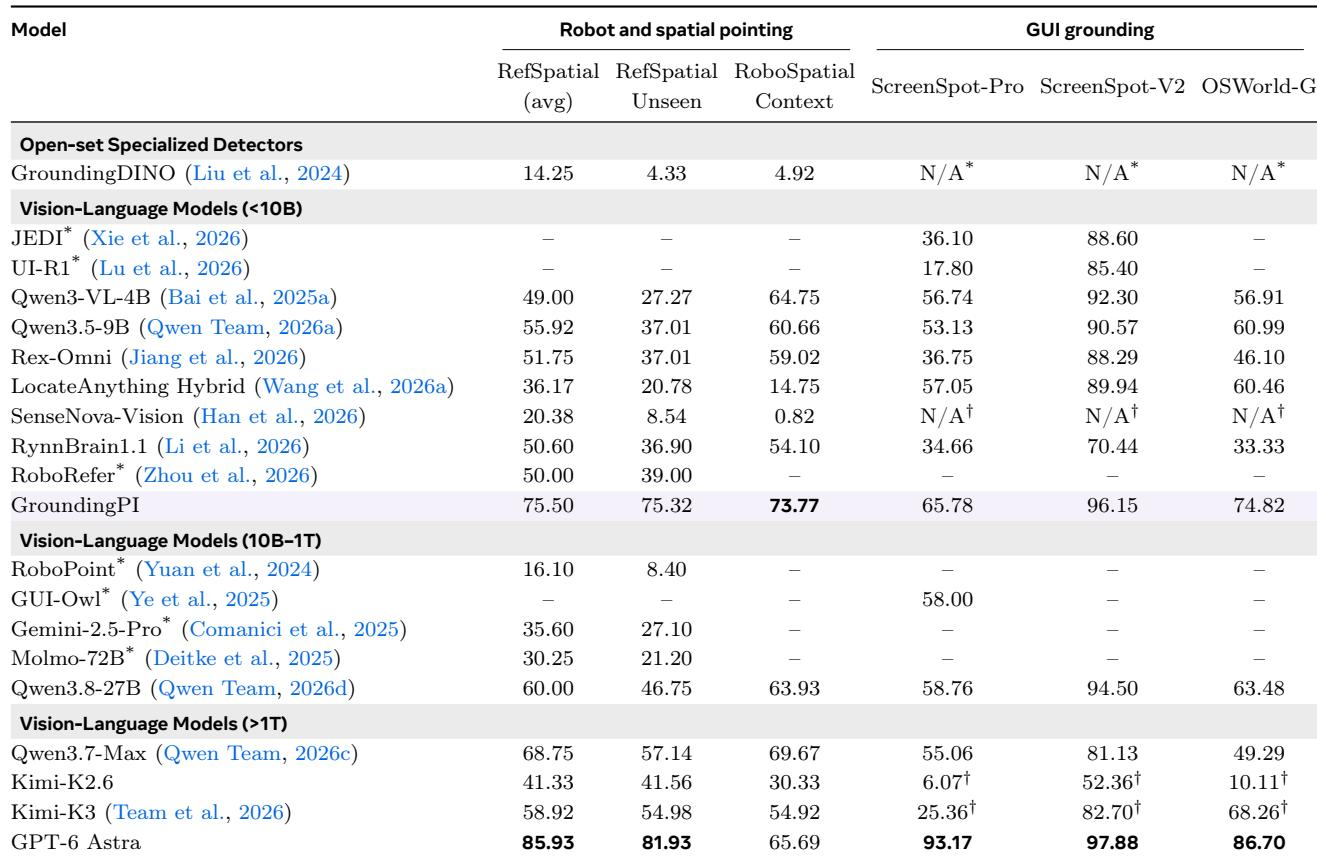
不同模型类型和基准难度下,定位性能差异显著。专用检测器在空间指向上受限,并且缺少 GUI 定位覆盖;通用小型视觉-语言模型提供最广覆盖并在所列子集上领先。GroundingPI 相比同规模基线有所提升,并与前沿参照模型保持竞争力。专用检测器在空间指向上落后于通用视觉-语言模型,并且无法在所列 GUI 定位基准上评估。在低于 10B 的视觉-语言模型中,Qwen3-VL-4B 是唯一同时覆盖机器人/空间和 GUI 定位的所列模型,并在所列子集上领先。GUI 导向模型在 ScreenSpot-V2 上表现相对良好,但 ScreenSpot-Pro 准确率明显更低,表明在更难的屏幕定位基准上存在困难。GroundingPI 取得最高的整体平均分,优于同规模模型,并与前沿参照模型保持竞争力。
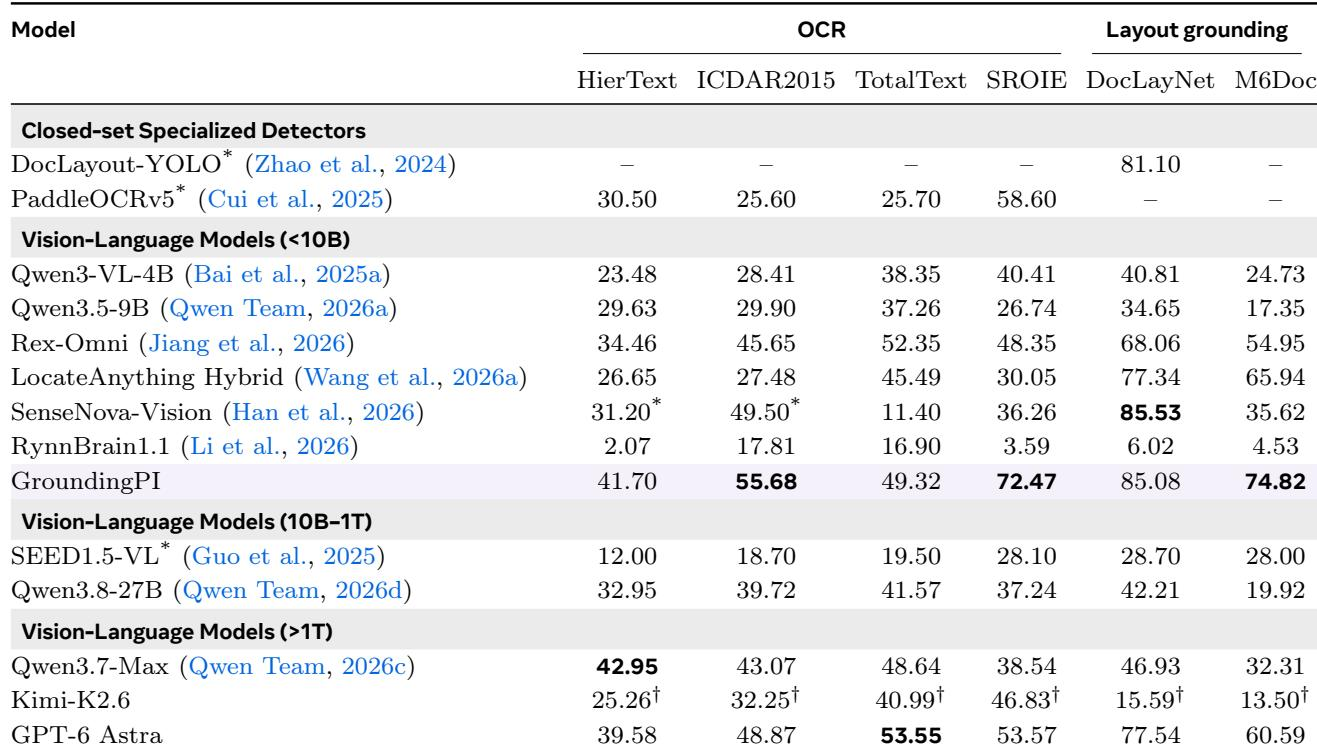
在所列 OCR 和文档布局结果中,DocLayout-YOLO 在文档布局上大幅领先,PaddleOCRv5 在 SROIE 上取得其最强 OCR 结果,但在其他测试中文本检测得分较低。低于 10B 的 Qwen VLM 在文档布局上落后,其中 Qwen3-VL-4B 在 SROIE、DocLayNet 和 M6Doc 上通常优于 Qwen3.5-9B,而 Qwen3.5-9B 在 HierText 和 ICDAR2015 上略强。更广泛的评估背景显示 GroundingPI 在平均定位性能上与 GPT-6 Astra 具有竞争力。DocLayout-YOLO 报告了所列最高的文档布局得分,并大幅超过 Qwen VLM 结果。PaddleOCRv5 在 SROIE 上显示出其最强的所列 OCR 结果,而在 HierText、ICDAR2015 和 TotalText 上文本检测得分相对较低。Qwen3-VL-4B 在 SROIE、DocLayNet 和 M6Doc 上优于 Qwen3.5-9B,而 Qwen3.5-9B 在 HierText 和 ICDAR2015 上表现略好。
所列目标指向结果显示,Rex-Omni 在每个报告的基准列上都领先其他基线,其在 Dense200 场景下相对 Qwen3.5-9B 的差距最大。Qwen3-VL-4B 在 HumanRef 和 RefCOCOg 上具有竞争力,但密集和微小物体得分低得多。在更广泛的评估中,GroundingPI 达到 73.68% 的平均分,优于同规模模型,并与 GPT-6 Astra 的 71.54% 保持竞争力。Rex-Omni 在所有所列基准列上领先,在报告类别中 Dense200 显示其相对 Qwen3.5-9B 的最大优势。Qwen3-VL-4B 在 HumanRef 和 RefCOCOg 上表现良好,但在 Dense200 和 VisDrone 上大幅落后于其他所列 VLM。
GroundingPI 的输出序列化比 SEED1.5-VL 紧凑得多,同时报告的每图像框数相当或更高。其在 COCO 和 Dense200 上的每框 token 成本低一个数量级以上,即使在更密集场景中,每图像总 tokens 数也仍然小得多。这一模式表明每框编码高效,输出开销分摊到许多框上。GroundingPI 在 COCO 和 Dense200 上每框使用的 tokens 比 SEED1.5-VL 少一个数量级以上。GroundingPI 预测的每图像框数相当或更多,同时保持每图像总 tokens 数大幅降低。密集输出放大了效率优势,相对于 SEED1.5-VL 每图像序列化 tokens 数大幅减少。
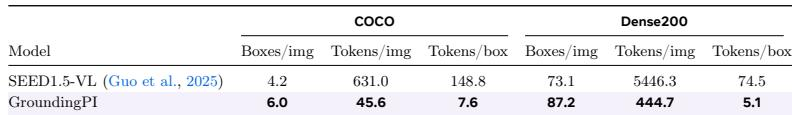
实验在检测与指称定位、空间与 GUI 定位、OCR 与文档布局、目标指向以及输出 token 效率等方面评估 GroundingPI。GroundingPI 达到 73.68% 的平均定位得分,优于同规模模型,并与前沿参照模型保持竞争力,量化坐标和 MoonViT-V2 编码器改善了性能。基线比较显示任务特定的优势,例如 Rex-Omni 在目标指向上领先,DocLayout-YOLO 在文档布局上领先,而专用检测器在密集、微小物体和 GUI 定位基准上表现挣扎。GroundingPI 还生成比 SEED1.5-VL 紧凑得多的序列化输出,每框使用的 tokens 少一个数量级以上,同时保持相当或更高的框预测数量。