Command Palette
Search for a command to run...
VIS-Ground:基于上下文锚定的视频交互式叙事
VIS-Ground:基于上下文锚定的视频交互式叙事
摘要
视频交互式叙事使观众能够主动引导视频的展开方式。然而,一旦允许观众在生成过程中进行干预,新的挑战便随之出现:观众的请求可能对锚定源和当前已渲染的视频状态同时具有潜在依赖。这些依赖关系未必在任何单一输入中被显式说明,而只有在联合考虑锚定源、渲染历史与新的观众意图时才会显现。现有的交互式视频生成系统主要强调遵循观众指令,而源锚定视频生成方法则侧重于将生成内容与外部叙事或知识源对齐。这留下了一个尚未被充分探索的根本性问题:在交互式续写过程中,生成模型应以何种上下文为锚定依据,以及如何将异构、非结构化的输入转化为此类锚定上下文?在本文中,我们将上下文锚定形式化为将异构输入上下文转换为可执行的视频生成约束模型的过程。为应对这一挑战,我们提出了 VIS-Ground,该方法执行结构化上下文抽象(Structured Context Abstraction)以恢复锚定状态和跨上下文依赖,执行生成约束归纳(Generation Constraints Induction)以将相关依赖投射为候选特定的约束,并执行受约束视频生成(Constrained Video Generation)以通过规划、验证、修订和渲染来施加这些约束。在三种视频生成骨干模型上,VIS-Ground 一致取得了最高的整体综合得分,相比各骨干上的最强基线平均绝对提升 10.3 分。详细分析进一步表明,该方法在叙事锚定和知识锚定方面均取得了提升,同时揭示了依赖关系提取以及视频渲染过程中忠实实现方面仍存在的挑战。
一句话总结
谷歌、伊利诺伊大学厄巴纳-香槟分校和加利福尼亚大学洛杉矶分校的研究者提出了 VIS-Ground,该方法执行结构化上下文抽象、生成约束归纳和约束视频生成,将异构上下文转换为可执行约束,联合处理来源、已渲染历史和观看者意图,在三个视频生成骨干上相比每个骨干最强的基线平均绝对提升 10.3 个百分点。
核心贡献
- 本文将上下文锚定形式化为把异构输入(如锚定源、视频前缀和观看者请求)转换为用于交互式视频续写的可执行约束模型。
- 本文提出了 VIS-Ground,该框架包括结构化上下文抽象,用于恢复锚定状态和跨上下文依赖;生成约束归纳,用于推导候选特定的约束;以及约束视频生成,通过规划、验证、修订和渲染来强制执行这些约束。
- 本文提出了 VIS-Bench,一个面向叙事锚定和知识锚定的交互式视频叙事基准;在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 上的实验表明,VIS-Ground 取得了最高的综合得分,相比每个骨干最强的基线平均绝对提升 10.3 个百分点。
引言
视频叙事有助于通过语言、图像、运动和声音解释复杂概念,但观看者通常在看到较早帧后想要重定向视频,例如要求展示后果或具体示例。先前系统要么根据固定故事或脚本生成长视频,要么支持提示驱动的交互式生成,但并未显式检查新的观看者请求是否仍与锚定源和已渲染视频兼容。作者将这一问题形式化为带上下文锚定的视频交互式叙事,并提出 VIS-Ground,该方法执行结构化上下文抽象、归纳生成约束,并使用迭代的“规划-验证-修订-渲染”过程,使续写保持来源忠实、故事一致和请求对齐。作者还提出了 VIS-Bench,用于在叙事锚定和知识锚定设置下评估这些性质。
数据集

-
数据集组成与来源 作者基于 CoQA 构建 VIS-Bench,从 MCTest、Gutenberg、RACE、CNN 和 Wikipedia 中采样 250 个来源段落。该基准覆盖两种锚定设置:叙事锚定,其中核心叙事(如故事大纲、剧本或情节描述)引导重要角色和事件;知识锚定,其中科学论文、Wikipedia 文章或文档等外部来源必须被忠实传达。在采样来源中,132 个为叙事锚定,118 个为知识锚定。
-
每个子集的关键细节 每个来源段落都被转换成带对齐来源事实的基于场景的故事。生成的故事以两种视觉风格渲染:电影写实风和剪纸动画风。作者在指定中断点生成 1,004 条交互指令,产生 2,008 个计划型指令式实例。所有实例都用于评估,因此不使用训练划分。
-
数据使用方式 VIS-Bench 仅用于评估。每个样本包括来源段落、视频前缀、观看者指令和相关参考素材。目标事实和续写要求保留用于评估,而不作为输入。
-
处理细节 生成的视频会经过质量检查和修复。在打包之前会审核指令对齐和信息泄漏。最终打包样本包括来源段落、视频前缀、观看者指令和相关参考素材。
方法
作者提出了 VIS-Ground,这是一个用于视频交互式叙事的框架,将上下文锚定视为上下文编译问题。其主要思想是把异构输入编译为锚定依赖模型,并用该模型控制后续的规划、生成和修复。
整体流程如下图所示:
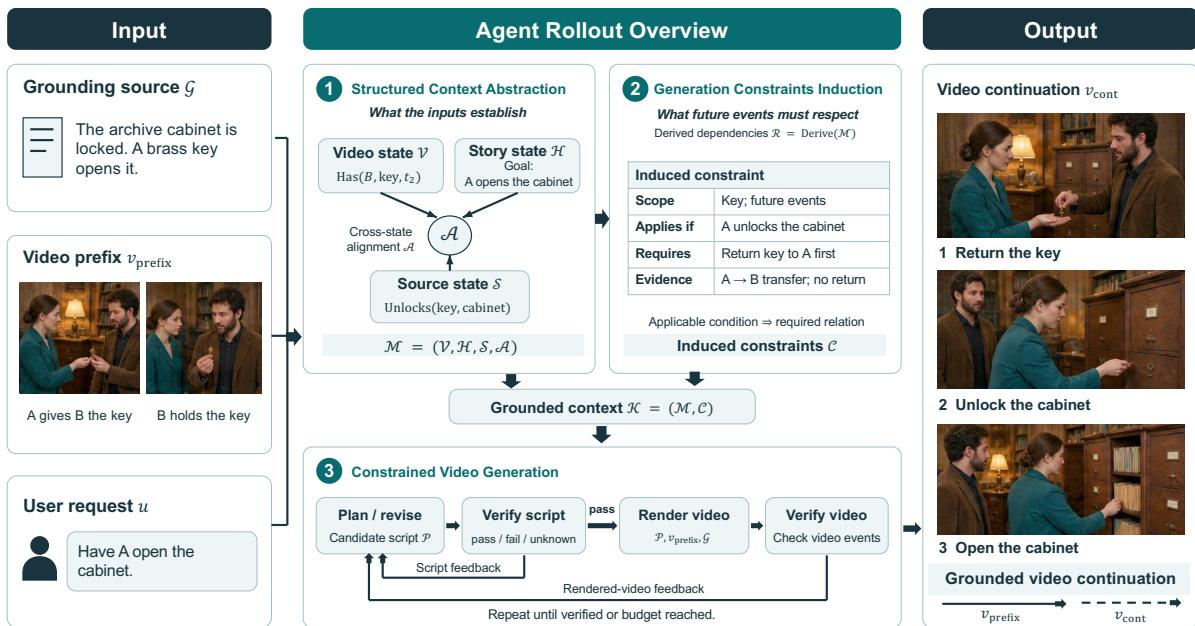
VIS-Ground 分三个阶段进行。第一,将锚定源、已渲染视频前缀和观看者请求转换为锚定事实和跨上下文依赖。第二,将这些依赖投影到候选续写上,其中只有被提出的未来所激活的关系成为生成约束。第三,被激活的约束指导规划、脚本修复、渲染和输出级修正。
将上下文编译为锚定依赖
锚定源、视频前缀和观看者请求提供了对演进情境的不同视角。来源可以建立事实或叙事关系,已渲染前缀决定当前可见状态,观看者请求指定故事应如何继续。VIS-Ground 不是独立总结每个输入,而是提取结构化锚定事实,并恢复由它们交互产生的依赖。
框架首先将每个输入转换为带参数、时间范围和证据链接的类型化谓词。这些谓词被组织为三种互补状态:
- 视频状态 V 表示已渲染前缀中已在视觉上确立的内容,包括实体、属性、位置、拥有关系、动作和状态转换。
- 故事状态 H 表示演进中的叙事状态,包括已完成事件、活跃目标、未解决关系、因果依赖和已传达的信息。
- 来源状态 S 表示由锚定源支持的原子声明、事件、定义和关系,同时保留限定条件、条件和支撑证据。
对齐后的状态被编译为锚定依赖模型
M=(V,H,S,A),其中 A 包含跨上下文对齐。从该对齐模型中,方法推导出依赖集
R=Derive(M).每个依赖表达一个已确立事实如何约束另一个事件或状态。这些依赖包括时间先后、因果前提、状态转换要求、持续关系、兼容条件和来源支持的依赖。其中许多关系在任何单个输入中都没有被显式陈述,只有在视频状态、故事状态和来源状态被联合锚定后才会出现。
将依赖投影为生成约束
VIS-Ground 从推导出的依赖集 R 中归纳约束。该方法并不直接优化最终视频评估指标,这些指标也不会被用作约束归纳的预定义类别。
令 P(k) 表示候选续写脚本。对于每个依赖,框架判断候选是否引入了使该依赖相关的事件、关系或状态转换。被激活的依赖表示为一个生成约束
cj=(sj,aj,bj,ej),其中 sj 指定实体和时间范围,aj 是适用条件,bj 是必须成立的关系,ej 包含支持该依赖的锚定证据。约束在以下条件成立时被激活
aj(P(k),M)=1,一旦被激活,它要求在范围 sj 内
bj(P(k),M)成立。
这种形式化使约束以候选为条件。例如,拥有关系依赖不一定约束续写,除非提议的脚本引入了需要特定角色拥有相应物体的动作。类似地,来源定义的前提只有在候选尝试其有效性依赖该前提的事件时才会被激活。
每个被激活的约束都会得到评估,并返回三种结果之一:通过、失败或未知。通过表示续写与依赖兼容。失败标识出冲突事件、状态转换或缺失前提。未知表示可用证据不足以判断兼容性。由于每个约束都保留对其支撑谓词和证据的链接,失败可以追溯到导致失败的上下文依赖,并用于生成有针对性的修订反馈。
约束视频生成
锚定依赖模型在整个生成过程中保持活跃。它不仅仅作为视频生成器的附加条件,而是为续写的提出、检查和修复提供共同基础。
规划器首先在锚定上下文的条件下提出候选脚本:
P(0)∼pθ(P∣M,u).由 P(0) 激活的依赖随后被实例化为约束并评估。当约束失败时,VIS-Ground 同时识别脚本中冲突的部分及其违反的锚定依赖。这会生成有针对性的修订反馈,而不是从头重新生成续写。
修订后的脚本生成为
P(k+1)=Reviseθ(P(k),M,F(k)),其中 F(k) 包含失败或未解决的依赖及其支撑证据。由于修订可能引入新事件或状态转换,每次更新后都会重新计算约束激活。因此,规划与验证形成了一个迭代的依赖引导修复过程,其中相关义务与候选续写共同演进。
一旦候选脚本 P∗ 满足被激活的脚本级约束,它就被传递给视频生成器:
νcont∼pψ(νcont∣P∗,νprefix,G).然而,脚本级有效性并不能保证渲染后的视频实现了预期事件或状态转换。因此,框架从 νcont 中提取已实现的关系,并将相同的锚定依赖投影到生成输出上。如果视频未能实现某个被激活的依赖,例如缺少物体转移、错误更改了持续属性,或前提事件在视觉上缺失,相应证据会被转换为输出级反馈。随后规划器修复脚本,或使缺失依赖在再次渲染前更明确。
通过这种方式,VIS-Ground 在推理和生成中使用同一个锚定依赖模型。上下文首先被编译为依赖,依赖只有在提出的未来使其相关时才被实例化为约束,违规被用于修复计划续写或其渲染实现。当生成续写满足适用的锚定依赖或计算预算耗尽时,过程终止。
实验
本文提出了 VIS-Bench,这是一个面向叙事锚定和知识锚定的视频交互式叙事基准,并使用自动化评判器在三个视频骨干上从语义和感知维度评估生成的续写。结果表明,所提出的 VIS-Ground 方法在两种锚定设置和不同骨干上,相比直接生成和基于 agent 的基线,改善了上下文锚定;而视觉质量在很大程度上仍受底层生成器限制。消融实验表明,结构化状态表示和实例特定规划发挥互补作用;失败分析显示,该方法有时会优先保持与先前上下文的一致性,而不是字面遵循指令。
VIS-Ground 在每一个测试的视频生成骨干上都取得了最高的综合得分,最明显的提升集中在与锚定相关的指标上,例如来源忠实性、故事连续性、交互满足度和联合约束满足。这些优势在叙事锚定和知识锚定设置中均出现,并且平均比最强竞争结果高出约十个百分点。该方法还表现出比 Direct Generation 低得多的跨骨干综合得分波动,但并非在每个单独的视觉或交互指标上都一致最优。在与锚定相关的指标上,VIS-Ground 在不同骨干和设置下平均比最强竞争结果提升约 10 个百分点。Direct Generation 的综合得分在三个骨干上跨度超过 30 分,而 VIS-Ground 的跨度低于 6 分,跨骨干波动约减少 82%。VIS-Ground 并非在每个单独指标上都最好;某些交互满足度、视觉一致性和视频质量比较中其他方法更优。消融实验表明,用自由形式摘要替代结构化上下文或使用一次性规划,会降低叙事来源忠实性、故事连续性和交互满足度的均值。
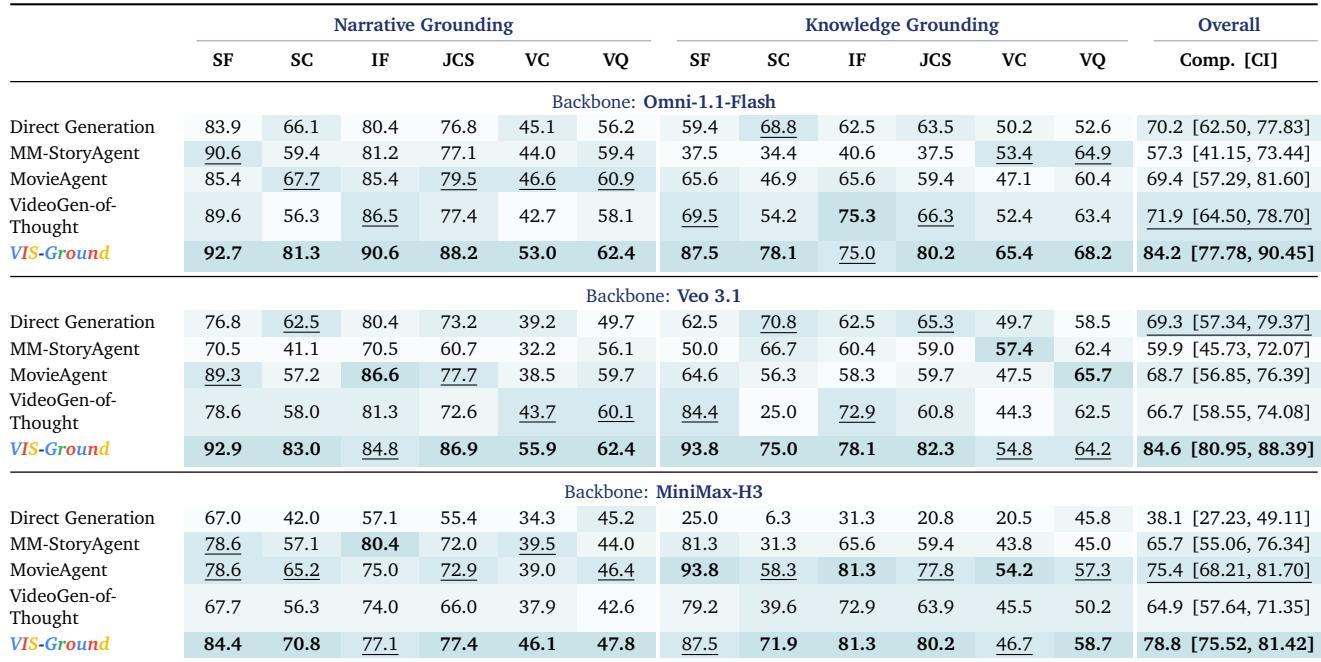
VIS-Ground 在多个视频生成骨干上、在叙事锚定和知识锚定设置中均接受了评估,并持续取得最高综合得分,在来源忠实性、故事连续性、交互满足度和联合约束满足等锚定相关指标上提升最大。与 Direct Generation 相比,其跨骨干综合得分波动还降低了约 82%,表明在不同骨干上的行为更稳定;不过它并非在每个单独的视觉或交互指标上都一致最优。消融实验进一步显示,用自由形式摘要替代结构化上下文或使用一次性规划会削弱叙事来源忠实性、故事连续性和交互满足度。