Command Palette
Search for a command to run...
思维惯性:LLMs 被要求不思考时仍在思考
思维惯性:LLMs 被要求不思考时仍在思考
Dianqiao Lei Kevin Qinghong Lin Pan Lu Philip Torr James Zou
摘要
大语言模型(LLMs)越来越多地提供明确的“思考模式”,但与之相对的“不思考”却远未受到同等关注。本文沿两个维度研究 LLM 的“不思考”行为。(a)如何测量“不思考”?以往工作通常通过禁用思考模式或缺乏长轨迹等代理指标来定义“不思考”。这些代理指标并不可靠:禁用思考模式后仍会产生冗长推理,或者长轨迹往往包含无信息量的填充内容,而非真正的推理。我们将任何 LLM 响应规范化为答案前轨迹和最终答案,并在三个层面上进行评估:(i)空思考率(Empty-Thinking Rate),用于衡量严格的仅输出答案合规性;(ii)指令感知的问题–答案前轨迹相关性(instruction-aware Question–Pre-answer Relevance),用于计算问题与答案前轨迹之间的相似度;(iii)额外的基于 LLM 评判的显式推理率(LLM-as-judge Explicit Inference Rate),用于检测可见的显式推理。综合这三个层面,可以区分仅答案输出、相关但非推理性文本和显式推理。人工评估研究表明这些指标有效。(b)“不思考”如何随任务和模型而变化?我们在六个广泛使用的 LLM(包括开源模型和商业模型)上,针对布尔型、选择题和开放式三种问题类型,评估了六种提示干预设置。我们发现,明确的禁止思考控制无法可靠消除可见的显式推理;模型反而表现出“思维惯性”:在严格的禁止思考控制下,可见的显式推理依然存在,并且随着答案空间扩大而愈发普遍。另一方面,在布尔型和选择题任务上准确率保持相对稳定,而开放式任务则暴露出仅输出答案合规性与任务准确率之间的权衡。最后,针对不同答案空间改写相同问题的结果表明,提供候选答案会使仅答案响应显著更容易生成。综上,这些发现确立“不思考”为 LLM 的一项非平凡能力:不能仅凭模型设置或指令就假定模型会停止显式推理,值得与推理能力本身一并系统评估。
一句话总结
来自清华大学、牛津大学和斯坦福大学的研究人员用三个指标替代不可靠的无思考代理指标,即空思考率(Empty-Thinking Rate)、问题-预答相关性(Question-Pre-answer Relevance)和 LLM-as-judge 显式推理率(Explicit Inference Rate),并在六个 LLM 上表明,在严格的无思考控制下,可见的“思维惯性”(Thinking Inertia)仍然存在,尤其在开放式任务中,仅答案合规性与准确率之间存在权衡。
核心贡献
- 一个响应级测量框架将每个模型输出规范化为预答轨迹和最终答案,然后用三个指标评分:用于严格仅答案合规性的空思考率、指令感知的问题-预答相关性,以及 LLM-as-judge 显式推理率;人工研究支持这些指标。
- 在六种提示干预设置、六个开源和商业 LLM,以及布尔、多选和开放式问题上进行的评估表明,显式的无思考控制无法可靠消除可见的显式推理。结果识别出“思维惯性”(Thinking Inertia):在严格控制下可见的显式推理仍然存在,并且随着答案空间开放而更普遍;同时,在布尔和多选任务上准确率保持相对稳定,但在开放式任务上与仅答案合规性存在权衡。
- 同一问题跨答案空间的重写表明,提供候选答案使仅输出答案的响应显著更容易,研究发现将无思考定义为一种可测量、非平凡的能力,应与推理分开评估,而不能从模型设置或指令中假设。
引言
LLM 通过扩展推理获得准确性,但这会带来延迟和 token 成本,而类人的自适应推理需要知道何时直接回答。先前工作通常从表面代理指标推断无思考,例如缺少推理轨迹、输出短或关闭思考模式,这把指令合规性与实际抑制任务相关的预答内容混为一谈。作者通过将无思考定义为可观察的响应行为,并引入三个指标来解决这一差距:空思考率、问题-预答相关性和显式推理率。其主要贡献是一个行为评估框架和一项多模型研究,表明显式的无思考控制并不可靠,模型表现出按答案空间组织的思维惯性,更严格的仅答案约束可能在合规性与任务准确率之间产生权衡。
方法
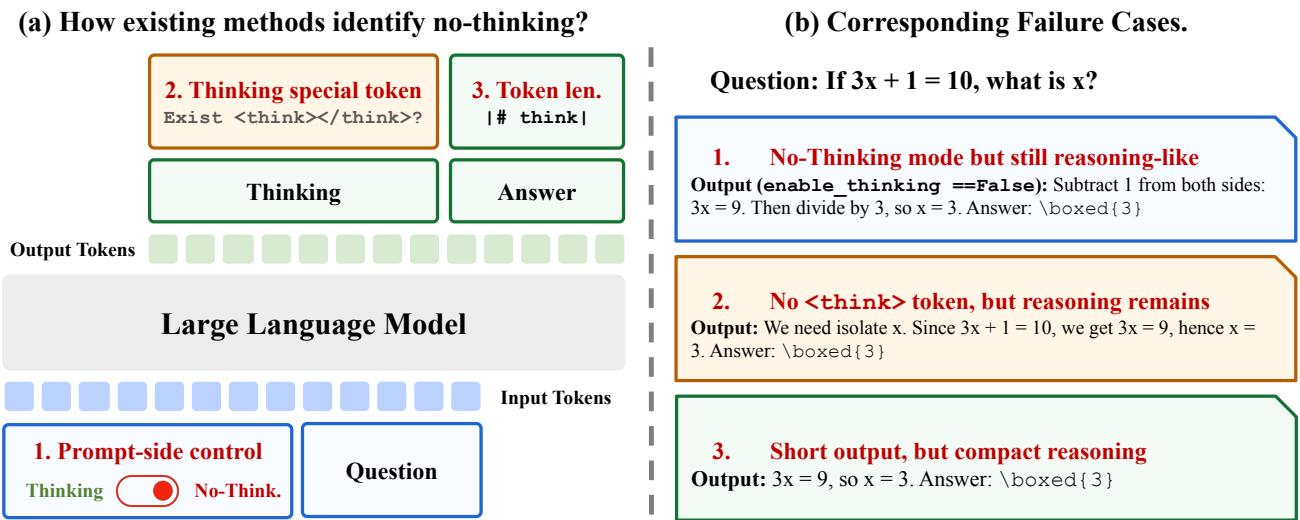
作者首先指出,现有的无思考定义通常依赖表面代理指标。这些包括提示侧控制,例如在没有逐步指令的情况下运行模型;可见格式控制,例如检查是否缺少特殊推理块;以及基于长度的控制,例如将短响应视为推理减少。作者指出,每种代理指标都可能失效。无思考指令仍可能在最终答案之前产生与问题相关的解释;删除特殊 token 只会移除一种格式,而推理仍可能保留在普通文本中;紧凑输出仍可能包含必要的推理步骤。
为避免这些混淆,作者在可观察响应层面而不是提示或格式层面建模无思考。形式上,设 π 表示语言模型,Q 表示任务样本。干预 S(⋅) 在生成前包装问题,模型产生可见响应
π(S(Q))=(T,A),其中 A 是最后一个可解析的最终答案,T 是其之前所有可读的可见文本。作者仅将 (T,A) 视为可观察输出的分解,不对模型内部潜在计算作断言。任务样本写为 Q=(q,c,A),其中 q 是问题,c 是可选上下文,A 是可接受的答案空间。这使得评估能够覆盖布尔、多选和开放式任务。干预分为问题无关干预和问题相关干预:前者修改指令或输出约束而保持任务内容不变,后者改变任务实例本身,例如其表面形式或答案空间。
整体测量框架如下图所示。
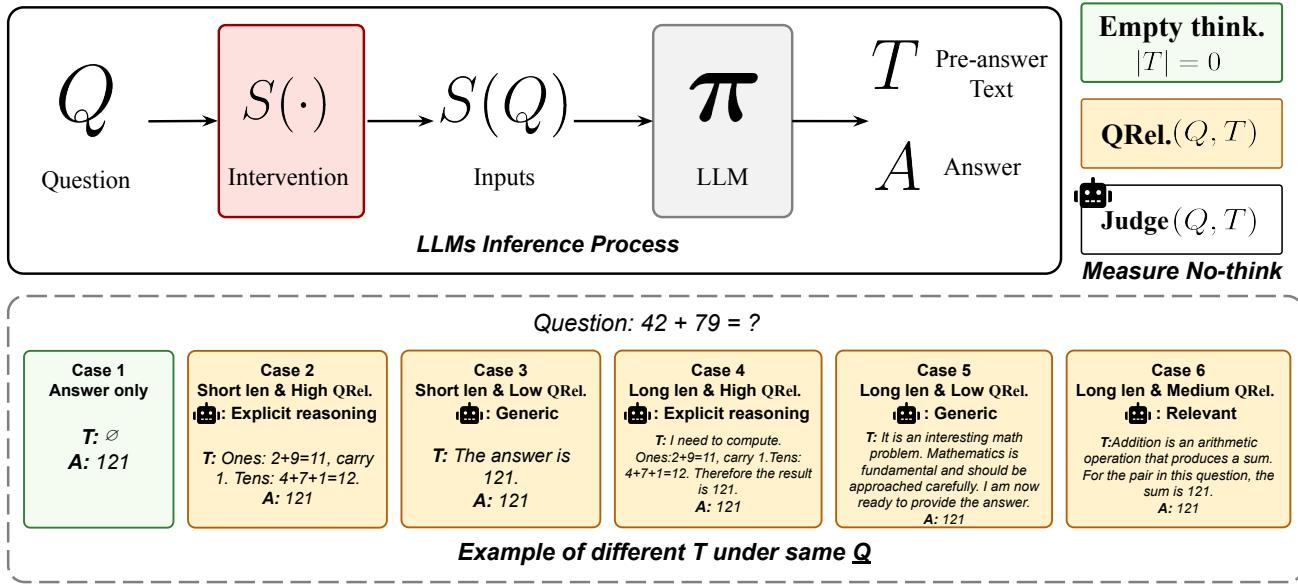
作者通过三个逐步更严格的响应级标准评估可见预答文本 T。最终答案 A 单独评估任务准确率。
第一级是严格的仅答案合规性。对于输出 i,响应级空思考指示变量定义为
ei=1{∣Ti∣=0},基准级空思考率为
ETR=100%×N1i=1∑Nei.该指示变量仅在最终答案可解析且完整可见输出在允许的答案包装之外不包含实质性文本时为 1。A 之后的实质性文本同样违反严格合规性。作者将 ETR 作为最清晰的操作边界,尽管一旦 Ti 非空,它无法区分通用模板、释义或显式推理。
第二级测量问题到预答文本的相关性。设 ϕ 为嵌入编码器,具体采用指令感知的 Qwen3-Embedding-4B 模型。问题 Qi 在一条要求提供与回答问题相关的预答文本的指令下编码,而 Ti 作为候选段落编码。经过 ℓ2 归一化后,响应级问题-预答相关性分数为
QRel.(Qi,Ti)={0,cos(ϕ(Qi),ϕ(Ti)),∣Ti∣=0,∣Ti∣>0.基准级 QRel. 是所有响应的算术平均值,包括空 Ti 记为零。该级别捕获相关性,但不能单独区分推理与相关重述或答案断言。
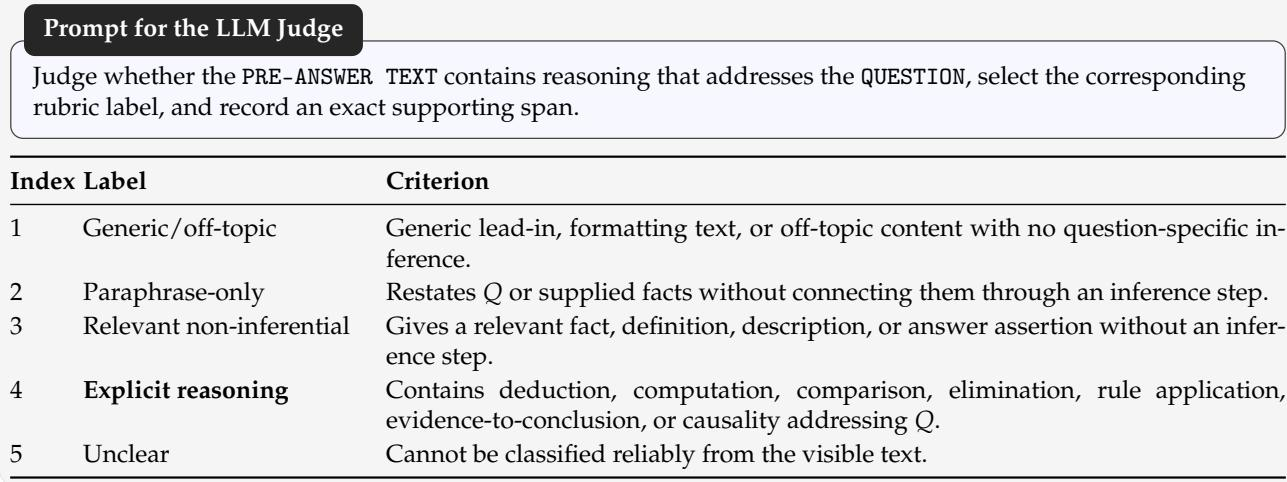
第三级针对可见的显式推理。一个盲评的 LLM 评判者只接收 (Qi,Ti),不包含模型身份、干预模式、最终答案、正确性或 QRel. 分数。对每个非空 Ti,评判者从五个互斥标签中选择一个,并返回一个精确的支持片段作为证据。仅相关重述或答案断言不被视为推理,而一个具体的推理步骤即使简短、肤浅或错误也可以符合条件。评判者分数仅在显式推理标签下为 1,否则为 0。空 Ti 被赋予 0 分。基准级显式推理率为
EIR=100%×N1i=1∑NJudge(Qi,Ti).作者进一步通过盲评人工研究验证自动指标。人工标注者审核 ETR 背后的严格可见边界,为 QRel. 提供分级相关性判断,并给出显式推理标签以与 LLM 评判者比较。还使用来自不同模型家族的第二评判者检查评判者特定效应。
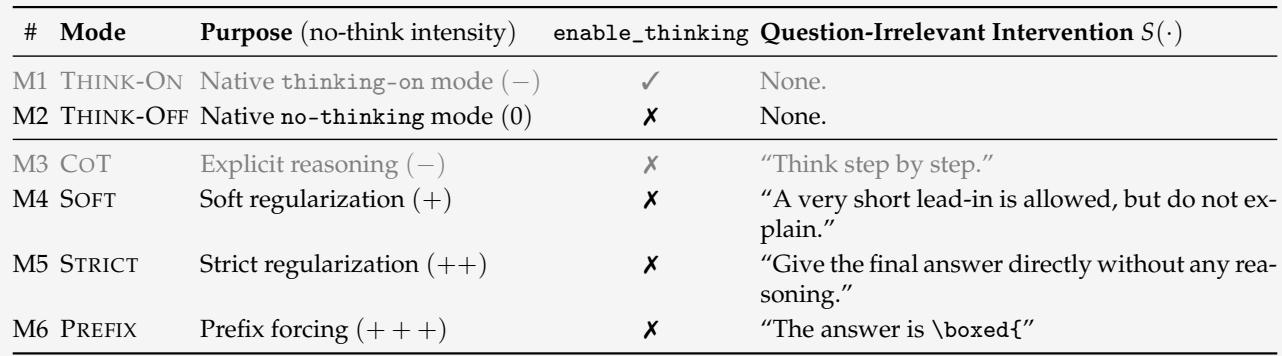
最后,作者设计了一个六模式控制谱系,研究可见思考行为在不同干预下如何变化。所有模式共享相同的任务主干和最终答案请求,只有思考开关或问题无关指令发生变化。THINK-ON 保持官方思考接口启用,而 COT 禁用该接口但添加指令“Think step by step”,以在普通答案通道中重新引发推理。它们作为鼓励思考的参考。THINK-OFF 禁用原生思考接口而不附加输出控制,作为基线无思考条件。SOFT 和 STRICT 保持原生接口禁用,并添加逐步增强的自然语言约束,而 PREFIX 通过在生成开始时预填答案模板来绕过指令遵循。该设计使作者能够在统一响应级评估框架下比较原生无思考行为、推理重新引发、语义抑制和结构化前缀强制。
实验
该研究在六个模型和六个基准上评估无思考行为,覆盖布尔、多选和开放式答案空间,并使用空思考率、问题-预答相关性、显式推理率和任务准确率。原生 think-off 控制通常仍留下可见的预答推理,这种思维惯性从布尔到多选再到开放式任务逐渐增加,而逐步提示可以恢复可见推理。更强的仅答案约束降低显式推理,但可能降低开放式任务的准确率;同一问题的答案空间重写证实,所要求的答案接口会影响直接回答。盲评人工标注在很大程度上与自动指标一致,并复现这些主要趋势。
该评分标准将非空预答文本分为五类:通用/离题、仅释义、相关但非推理、显式推理和不明确;空预答文本单独处理,并视为没有可见显式推理。这支持覆盖严格仅答案合规性、预答相关性和可见显式推理的三级响应评估。跨模型和任务,可见显式推理仍然难以抑制,并在开放式任务上即使有严格自然语言约束也持续存在。非空预答文本被分为通用/离题、仅释义、相关但非推理、显式推理和不明确类别,空文本计为没有可见显式推理。显式推理涵盖回答问题所需的演绎、计算、比较、排除、规则应用、证据到结论和因果推理。随着答案空间开放,可见显式推理更难抑制,并在严格无思考指令下的开放式任务上仍然常见。
六模式干预谱系将鼓励思考的模式与无思考空间区分开,后者从原生无思考基线到逐步增强的语义抑制。THINK-ON 和 CoT 通过启用或重新引发推理作为思考侧参考,而 THINK-OFF、SOFT、STRICT 和 PREFIX 以不同方式限制输出通道。PREFIX 是一个独立分支,预填答案模板,绕过指令遵循而不是增强自然语言约束。无思考空间从 THINK-OFF(原生无思考基线)经过 SOFT 和 STRICT 自然语言约束,到 PREFIX(强制答案模板)。THINK-ON 保持思考接口启用,而 CoT 禁用该接口但添加逐步指令以在普通答案通道中重新引发推理。SOFT 允许短引导语但禁止解释,而 STRICT 要求直接给出最终答案,不进行任何推理。PREFIX 与 STRICT 在性质上不同,因为它在生成开始时预填答案模板 The answer is \boxed{,完全绕过指令遵循。
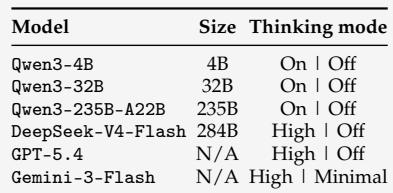
基线套件涵盖多个规模的开放 Qwen3 检查点、DeepSeek-V4-Flash,以及 OpenAI 和 Google 的专有模型,均根据显式思考模式控制进行选择。评估覆盖布尔验证、多选问答和开放式生成,每个系列下包含一个较易和一个较难基准。报告的指标将任务准确率与在整个输出集上计算的三个响应级无思考度量结合在一起。所选模型提供配对的本地控制或可比的显式思考模式设置,允许直接干预,而不是从输出长度或格式推断。基准从二元判断到固定选项选择再到开放式生成逐步推进,支持在相同评估指标下进行答案空间比较。
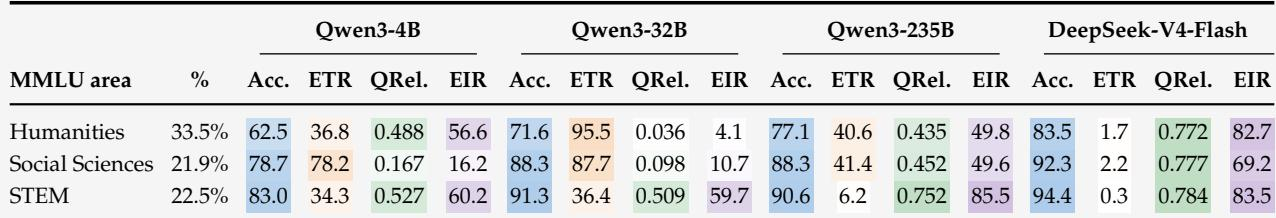
在固定的四选一多选接口下,无思考行为在不同 MMLU 学科领域之间仍然存在差异。在所有模型规模下,STEM 任务始终将最高准确率与最低 ETR 以及最高 QRel 和 EIR 结合在一起。这表明仅答案合规性并不简单地与任务成功相关,领域仍然是变异来源。STEM 在每个模型块中均显示最高准确率但最低 ETR,同时显示最高 QRel 和 EIR。人文学科和社会科学在比较模型中的 ETR 高于 STEM 或更不稳定,尽管准确率通常较高。领域模式不限于 ETR,STEM 在预答相关性和显式推理度量上也领先。
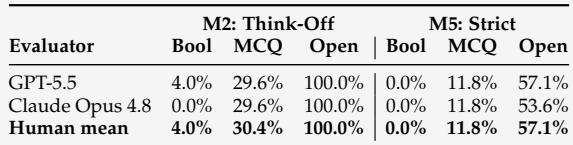
显式推理率强烈受答案空间组织:布尔提示几乎没有可见推理,多选提示显示中等比率,开放式提示显示最高比率,在一个条件下甚至达到普遍的可见推理。更严格的指令降低了多选和开放式设置中的显式推理,但大多数开放式响应仍包含显式推理。人工平均判断在所有条件下与 LLM 评判者估计高度一致。显式推理随答案空间开放而增加,从布尔提示中的接近零,到多选中的中等,再到开放式提示中的最高。更严格的约束在多选和开放式设置中显著降低显式推理,但开放式响应仍有一半以上时间显示显式推理。人工标注者平均值在所有采样的答案空间条件下与 LLM 评判者比率高度匹配。
实验通过在开放 Qwen3、DeepSeek、OpenAI 和 Google 模型上使用预答文本评分标准和六模式干预谱系,在布尔、多选和开放式基准上评估模型在无思考指令下抑制可见显式推理的能力。研究验证了无思考行为随指令强度、领域和答案空间而变化,更严格的约束减少但不能消除显式推理,而 STEM 任务显示出相对较高的仅答案合规性和相关性。显式推理随答案空间开放而增加,人工判断在各条件下与 LLM 评判者估计高度匹配。