Command Palette
Search for a command to run...
面向长程终端智能的智能体数据规模化
面向长程终端智能的智能体数据规模化
Shun Zou Ziyu Ma Yi Zou Yong Wang Lin Chen Zehui Chen Guanhua Chen Xiangxiang Chu Feng Zhao
摘要
终端智能体正超越本地操作,转向完成现实世界中的专业任务。短轨迹能够展示命令和工具调用,但无法充分体现智能体如何通过探索积累证据、利用证据形成判断、根据反馈不断调整策略,并将中间结果转化为最终交付成果。高质量的长程轨迹能够捕捉这些智能体行为模式及其在单一问题求解过程中的联系,为持续自主工作提供更丰富的经验。然而,环境合成可能提前完成或简化这些模式所依赖的关键工作,从而使智能体不再需要执行其本应进行的探索、实现与验证。为解决这一问题,我们提出 TerminalHorizon,一个面向长程终端智能体的全自动数据合成引擎。它从现实世界专业工作出发,通过独立执行识别环境构建过程中被省略的关键工作,并利用由此产生的证据指导环境重建。为了将这些模式扩展到不同阶段,它在同一目标下逐步扩展任务,引入建立在先前结果之上、并需要进一步探索与改进的新需求。利用该引擎,我们构建了 1.5K 个任务环境,并在所得数据集上对 Qwen3.5-27B 进行监督微调,得到 TerminalHorizon-27B。我们在全部 12 个基准上取得了显著性能提升,这些基准涵盖编码智能体任务、真实生产环境中的智能体任务和通用推理。多项 RSI 案例研究(每项配备 12 小时研究预算)进一步证明,该模型能够在初始解决方案之后继续实验、基于反馈改进方法,并在最终交付成果中保留有效改进。
一句话总结
来自中国科学技术大学、AMAP、阿里巴巴集团和南方科技大学的研究者提出了 TerminalHorizon,一个面向 long-horizon terminal agents 的全自动数据合成引擎。该引擎通过独立执行识别被省略的关键工作,利用由此产生的证据指导环境重建,并在同一目标下逐步扩展任务;在得到的 1.5K 个任务环境上对 Qwen3.5-27B 进行微调后得到 TerminalHorizon-27B。该模型在全部 12 个基准上取得显著性能提升,覆盖 coding-agent 任务、真实生产环境 agentic 任务和通用推理,并在多个 12 小时 RSI 案例研究中展现出迭代改进。
核心贡献
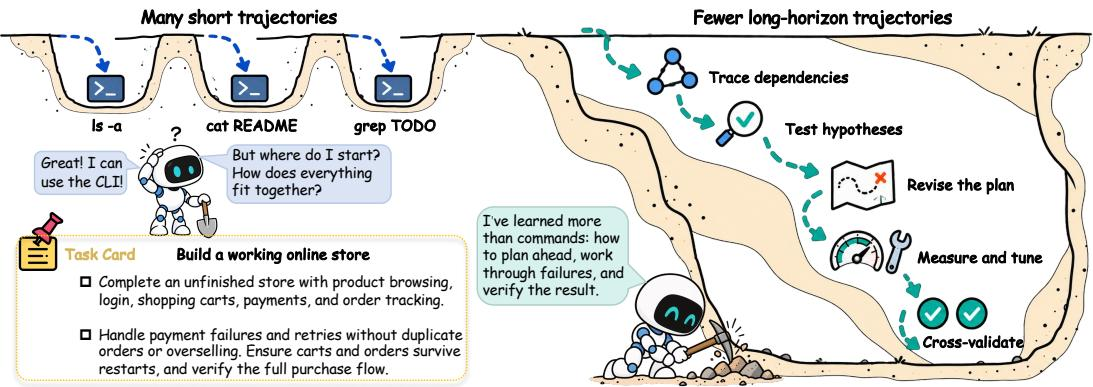
- 本文提出一种关于高质量 long-horizon terminal-agent 数据的视角,该视角以 agentic 行为模式及其跨阶段关联为中心,强调环境必须保留实质性探索、实现和验证工作。
- 全自动数据合成引擎 TerminalHorizon 将挑战引导的环境重建与渐进式任务扩展相结合,构建出 TerminalHorizon-3K。该数据集包含 1,535 个任务环境和 2,852 条训练轨迹。
- 在这些轨迹上对 Qwen3.5-27B 进行监督微调后得到 TerminalHorizon-27B。该模型在覆盖编码、真实生产力任务和通用推理的全部 12 个基准上均取得提升;多个 12 小时 RSI 案例研究显示,其能够持续实验、根据反馈改进方法,并在最终交付物中保留改进。
引言
LLM agents 正在从短对话交互走向 terminal 环境中的自主 long-horizon 工作,这些环境结合了代码、数据、工具和执行反馈。高质量 terminal 训练数据仍然稀缺,现有环境合成方法往往产生相对较短的轨迹,限制了对持续问题解决行为的覆盖,例如迭代规划、依赖执行和验证失败后的修正。作者进一步识别出两个挑战:复杂任务可能意外简化或跳过 agent 本应执行的工作;增加难度并不一定能在不同阶段之间可靠地扩展有用的 agentic 行为模式。为解决这一问题,作者提出了 TerminalHorizon,这是一个全自动合成引擎,具有挑战引导的 long-horizon 构建和渐进式 horizon 扩展。该引擎创建的任务环境中,探索、实现和验证在长轨迹中保持关联。作者构建了 TerminalHorizon-3K,其中包含 1,535 个任务环境和 2,852 条训练轨迹,平均交互轮数为 52.8 轮。研究表明,基于这些数据进行监督微调可以提升编码、真实生产力和通用推理基准上的性能。
数据集
数据集组成与来源
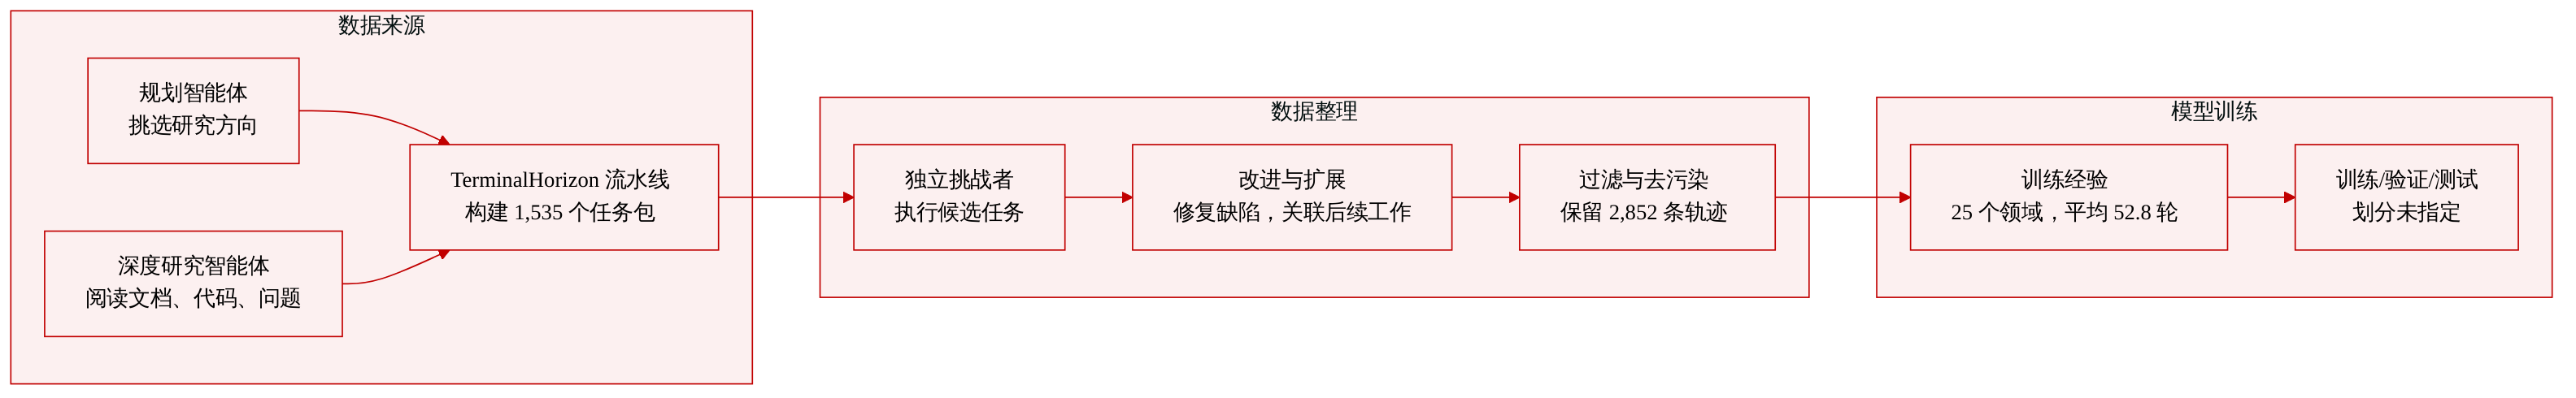
- 作者通过 TerminalHorizon 自动流水线构建 TerminalHorizon-3K。该流水线从研究简报中合成 terminal 任务包。
- Planner Agent 选择研究方向,Deep Research Agent 调查文档、代码仓库、issue 报告和专业材料,以创建任务种子。
- 每个任务包包含公开指令、环境、受控初始状态、参考解、验证器和执行配置。即使使用私有测试,评分要求也必须由公开或可发现的证据支持。
- 数据覆盖 25 个专业领域,包括芯片、物理学和天文学,并统一为 terminal 交互格式。
生成、扩展与过滤
- 作者生成 1,535 个任务环境包,并使用 DeepSeek-V4-Pro-0813 作为教师模型、Terminus2 作为执行框架,为每个任务收集两条轨迹。
- Independent Challenger 执行候选任务。随后根据运行时缺陷、信息泄漏、评分不一致以及预期工作是否得到保留对任务进行细化。
- 已接受任务可以通过渐进式 horizon 扩展进行扩展,包括更广泛的角色、更深的机制、更丰富的证据和方法升级。交互依赖将后续工作与此前证据、产物、状态或实例特定变化联系起来。
- 收集完成后,作者应用附录 F 中的三个过滤标准,保留 2,852 条轨迹以构成 TerminalHorizon-3K。训练前进行了基准去污染。
规模与统计
- 最终数据集覆盖 25 个专业领域。
- 轨迹的平均交互长度为 52.8 轮,90 分位数为 98 轮,连续动作链中位数为 25 轮。
- 作者识别出 27 种行为模式,分为五类:信息探索与判断、诊断与纠错、构建与工作推进、验证与保障,以及策略与执行协调。轨迹平均包含 8.6 种核心模式。
本文对数据的使用方式
- 作者将 TerminalHorizon-3K 用作模型的训练经验。
- 该数据不仅用于教授 terminal 命令执行,还用于教授如何组织持续的目标导向工作、观察反馈、修正策略并交付最终结果。
- 所选文本未指定 TerminalHorizon-3K 的训练/验证划分或混合比例。
方法
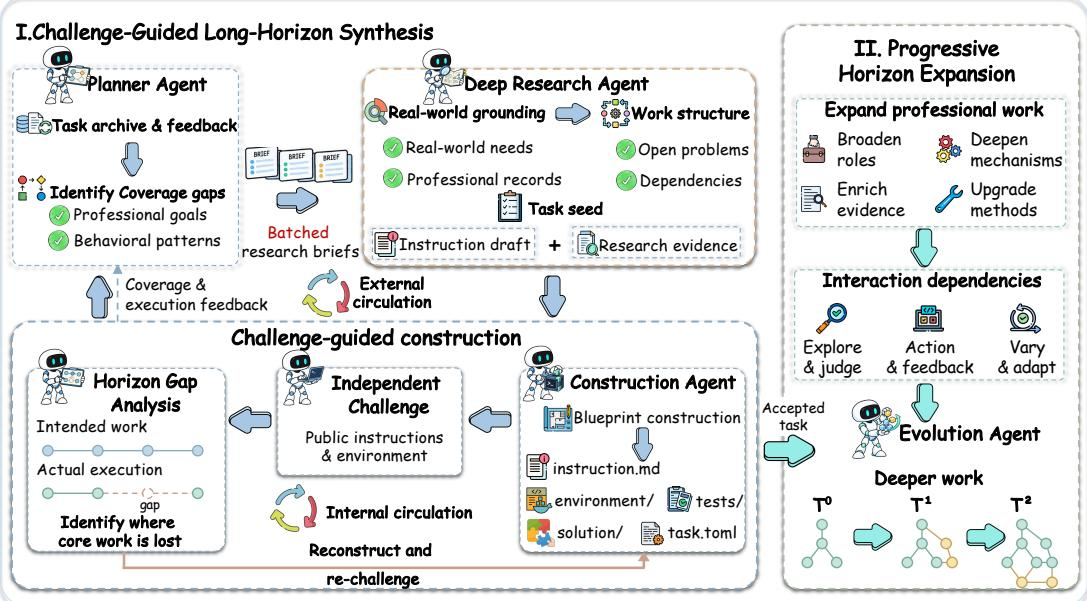
TerminalHorizon 从真实世界专业问题构建可执行环境,以激发 agentic 行为模式。该方法包含两个耦合阶段。第一阶段执行挑战引导的 long-horizon 合成,其中独立执行揭示构建过程已经简化、删除或已完成的工作,相关证据随后指导重建。第二阶段执行渐进式 horizon 扩展,在同一目标下扩展已接受任务,使新增工作依赖于先前结果和反馈。
如下方框架图所示:
任务形式化与设计目标
每个可执行 terminal 任务包定义为
T=(I,E,S,V,M),P(T)=(I,E).公开指令 I 指定目标和约束,可执行环境 E 提供初始状态、工具和执行机制。参考解 S、私有验证器 V 和执行配置 M 支持任务构建和评估。在执行过程中,agent 仅接收公开任务包 P(T),并通过与环境交互收集信息。
作者旨在保留连接探索、诊断、构建、验证和策略协调的工作。这些过程通过五类共 27 种 agentic 行为模式描述。因此,环境设计应保留可探索的证据,将分析和实现工作留给 agent 完成,并提供有助于 agent 修正先前判断的反馈。
挑战引导的 Long-Horizon 合成
合成阶段使用内循环和外循环。内循环通过独立执行指导任务重建。外循环利用已接受任务和评审证据规划后续研究批次。
自主批次规划
每个批次首先识别能够扩大 agentic 行为模式覆盖范围的专业工作。对于批次 b,令 Db 为已接受任务集,Fb 为累积记录,nb 为可用研究槽数量。Planner Agent 生成研究简报:
Qb=Plan(Db,Fb;nb),Qb={qb,i}i=1nb.每个简报 qb,i 指定工作范围、现有任务尚未覆盖的需求,以及需要研究的真实世界来源。
基于证据的深度研究
根据研究简报,Deep Research Agent 调查文档、代码仓库、issue 报告和专业材料,目标是确立真实世界需求、技术约束和评估完成情况所需的证据。研究确定了 agent 必须发现什么、哪些问题需要进一步分析或实现,以及一个结果如何支持后续工作。研究发现形成任务种子 zb,i,其中包含公开指令草稿和支持证据。
联合环境构建
Construction Agent 从任务种子合成具体实例,其具有受控初始状态和验证条件。该 Agent 指定可用材料和工具、留给 agent 的工作以及完成标准。随后 Construction Agent 联合构建指令、环境、参考解、验证器和执行配置,生成候选任务包 T。
评估必须遵循公开任务要求:
Csem(V)⊆Sem(I,Opub(E)).此处左侧表示验证器检查的完成要求,右侧表示公开指令和环境可发现证据支持的要求。测试数据可以保持私有,但评分不能引入 agent 无法发现的要求。参考解提供一种可行方法,验证器接受满足公开要求的其他实现。
独立挑战
可执行任务包本身并不能证明预期工作在任务求解过程中仍然必要。因此,Independent Challenger 在未参与构建的情况下尝试候选任务 Tr。其策略 πB 仅访问公开任务包 P(Tr),没有研究记录、参考解或私有测试。
在每一步,策略根据公开指令和历史 ht=(o0,a0,…,ot) 选择动作:
at∼πB(⋅∣I,ht),(st+1,ot+1)∼PE(⋅∣st,at).生成的轨迹
τr∼Rollout(πB;P(Tr))记录完整交互历史。验证器评估最终状态和产物,以计算 ρr=Vr(sHr)。随后进行综合评审并给出诊断:
dr=Asyn(Tr,τr,ρr).诊断记录运行时缺陷、信息泄漏、评分不一致以及预期工作是否实际得到保留。
Horizon Gap 分析与重建
Horizon Gap Analysis 将任务种子中指定的工作与 challenger 轨迹进行比较。它追溯被省略的工作到初始材料、对象关系或工具行为。例如,如果环境已经提供了任务要求 agent 实现的核心函数,剩余工作可能退化为修改一个常量。重建恢复了实现和调试该函数的必要性,同时保留完成工作所需的公开规范。
Construction Agent 使用种子 z=zb,i、轨迹和诊断修订任务:
Tr+1=Refine(Tr;z,τr,dr).这一细化在保留目标的同时修订初始状态、对象关系、实现要求或工具反馈。指令、参考解和验证器随之更新。修订后的任务返回独立执行,以检查恢复的要求是否进入实际求解过程。
通过评审和运行时检查的任务构成已接受集 Ab。研究、执行、评审和重建记录提供新反馈 ΔFb:
Db+1=Db∪Ab,Fb+1=Fb∪ΔFb.Planner 在下一批次中使用更新后的集合和记录,以识别重复工作并决定下一步针对哪些行为模式。
渐进式 Horizon 扩展
可求解任务并不是环境构建的终点。作者在同一目标下为已接受任务增加新要求,将新增工作与此前判断、动作和结果联系起来。
渐进式内容扩展
Evolution Agent 检查已接受的父任务 T(g) 并形成扩展提案 δ(g)。它检查父解是否可以直接满足新要求,从而识别需要进一步分析、实现或验证的内容。内容扩展沿四个方向进行:更广泛的角色、更深的机制、更丰富的证据和方法升级。更广泛的角色利用现有产物或状态支持相关职责。更深的机制将先前被简化的关系、依赖或不确定性纳入工作。更丰富的证据增加记录、观察和专业材料。方法升级要求对原始方法进行大幅扩展或重新设计。
实现交互依赖
Evolution Agent 从三种交互设计中选择,以将新增要求与此前证据、产物和状态连接起来。为支持探索和判断,后续决策依赖于通过公开查询、探测和观察收集的证据。在动作和反馈方面,可观察的工具或系统效果将先前操作与后续诊断、纠正和验证联系起来。在实例变化和适应方面,对象或状态在固定公开规范下跨运行发生变化,要求 agent 检查当前实例、调整动作并验证结果。
这些设计旨在服务扩展,而不是强加固定序列。扩展产生新候选:
T(g+1)=Expand(T(g);δ(g)).候选公开规范结合原始要求和新增要求。环境、参考解和验证器随之更新,新增评分条件继续遵循公开完成契约。被接受的候选将成为下一次扩展的父任务。
实验
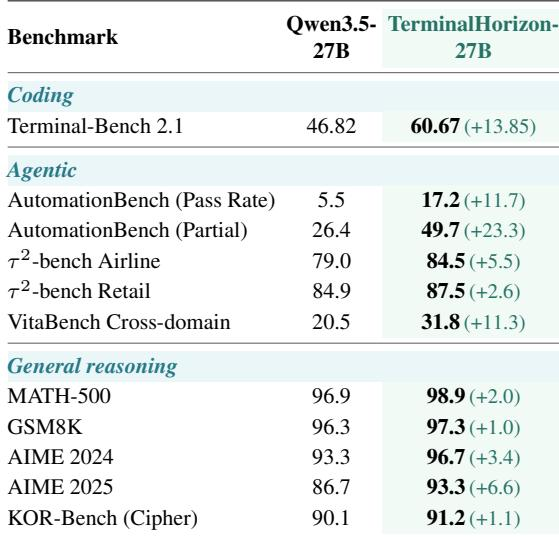
该研究在 12 个基准上评估 TerminalHorizon-27B。该模型是在 long-horizon terminal 轨迹上训练的 SFT 模型。评估覆盖 terminal 任务求解、真实生产力任务和通用推理,并对教师行为、模型规模、数据扩展和一个 long-horizon 自主研究案例进行额外分析。该模型在所有基准上均优于其基础模型,将收益迁移到 agentic 生产力任务,并在使用远少于先前轨迹训练模型的轨迹的同时保持通用推理能力。消融实验表明,更长的教师反馈链可提升任务完成率,收益在不同模型规模上具有泛化性,数据扩展尚未进入平台期。在 12 小时自主研究任务中,模型继续诊断和修正方法而不是提前停止,从而获得显著更高的最终评估分数。
TerminalHorizon-27B 在全部 12 个基准上优于其 Qwen3.5-27B 基础模型,这些基准涵盖 terminal 任务、真实世界 agentic 任务和通用推理。在 Terminal-Bench 各版本上收益尤其明显,两个版本有两位数的百分点提升;该模型还在训练轨迹数量远少于可比模型的情况下超越了后者。收益迁移到真实生产力任务,通用推理保持稳定。TerminalHorizon-27B 在 Terminal-Bench 1.0、2.0 和 2.1 上均优于其基础模型,在后续基准上提升更大。它比可比的 Terminal-Universe 模型高出 3.0 个百分点,而使用的训练轨迹不到其十分之一。真实世界 agentic 基准也有所提升,包括 AutomationBench 通过分数和部分分数、VitaBench,以及 tau2-bench 航空和零售任务。通用推理保持或提升,MATH-500 和 AIME 结果达到较高分数。
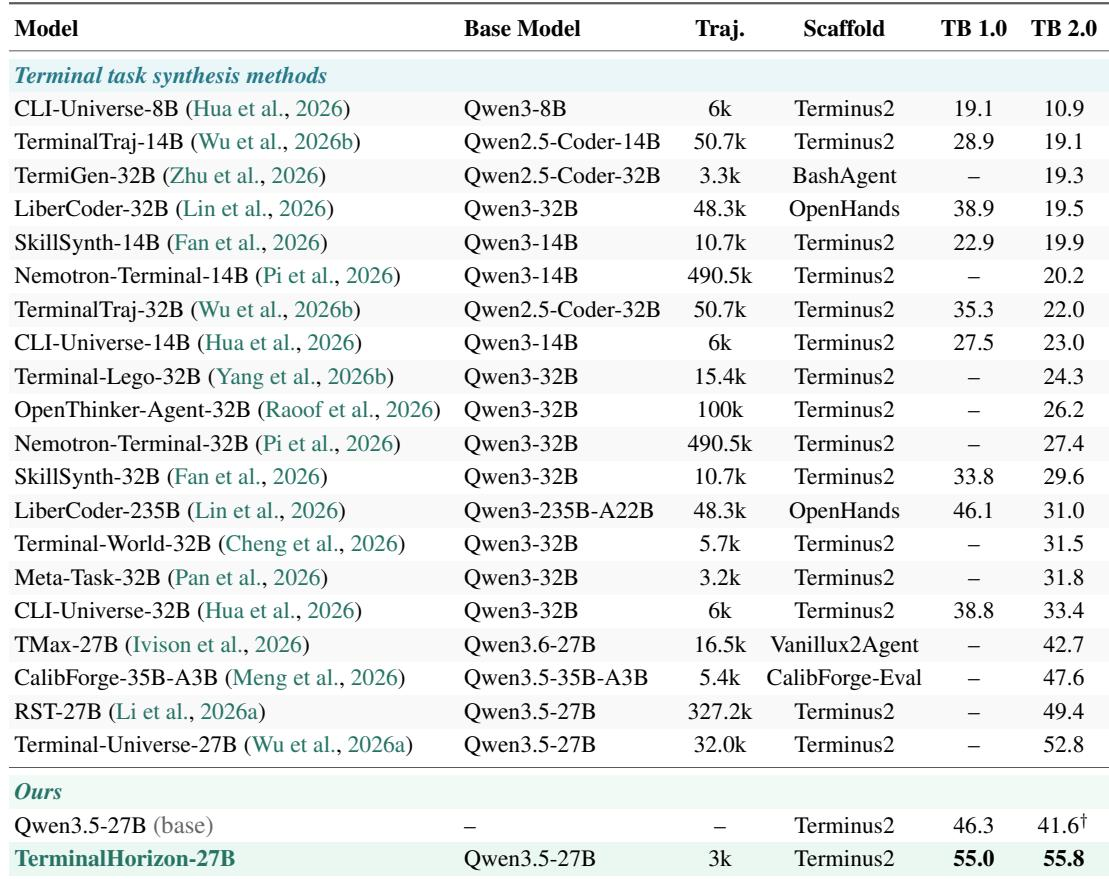
TerminalHorizon-27B 在编码、agentic 和通用推理基准上始终优于其 Qwen3.5-27B 基础模型。其收益在编码和真实世界自动化任务中尤其明显,同时通用推理得到保持并进一步提升。该模型还表现出数据效率,超过了以远多轨迹训练的先前模型。TerminalHorizon-27B 在所有评估基准上均优于基础模型,在 Terminal-Bench 2.1 上获得两位数的编码收益。Agentic 迁移广泛:AutomationBench 通过率和部分分数显著提高,航空和零售任务分数也有所提高。通用推理保持强劲,MATH-500 以及 AIME 2024 和 2025 的分数接近饱和。
在采样任务集上,两个教师模型都生成长轨迹,表明其具有 long-horizon 问题求解经验。DeepSeek-V4-Pro 比 GLM-5.2 维持更长的交互,并且精确动作重复率更低;其更持久的交互与更高的任务完成率相关。DeepSeek-V4-Pro 产生更长的反馈链,并且比 GLM-5.2 更少重复精确动作。更持久的交互模式与更高的任务完成率相关,这支持选择 DeepSeek-V4-Pro 作为 long-horizon 轨迹收集的教师模型。
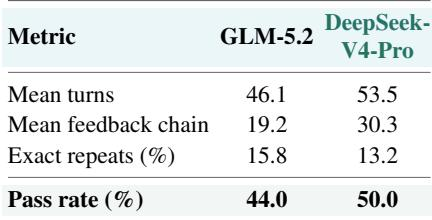
评估将 TerminalHorizon-27B 与其 Qwen3.5-27B 基础模型以及先前的 terminal 中心模型在 Terminal-Bench 各版本、AutomationBench、VitaBench、tau2-bench 等真实世界 agentic 基准和通用推理任务上进行了比较。结果表明,在所有基准上均有一致收益,其中 long-horizon terminal 和自动化任务提升最大,同时推理能力保持强劲。该模型还在训练轨迹数量远少于可比模型的情况下超越后者,从而证明了数据效率。单独的轨迹分析验证了选择 DeepSeek-V4-Pro 作为教师模型的合理性,因为它比 GLM-5.2 维持更长的交互、更少重复精确动作,并获得更高任务完成率。