Command Palette
Search for a command to run...
AgentSWE:编码智能体能否构建你真正想要的智能体?
AgentSWE:编码智能体能否构建你真正想要的智能体?
Jiahao Wang Hongjin Qian Yuyang Hu Jiajun Zhang Zheng Liu
摘要
随着软件生产逐渐交由软件自身完成,编码智能体越来越多地被委托构建适配用户自身工作流的智能体。这种委托隐含着一个未言明的假设:交付的智能体将忠实服务于其构建目标所对应的需求,而不仅仅是表面上看起来如此。现有基准均未检验这一假设。我们提出了 AgentSWE,一个面向智能体软件工程的基准,覆盖智能体开发生命周期的三个阶段:根据自然语言需求创建完整智能体、编辑生产级智能体代码库,以及面向可量化目标的优化。其 25 个任务中的每一个都被设定为一项“委托”而非一场“考试”:构建者仅围绕少量说明性样例进行迭代,而验收则在为覆盖完整需求而设计的留出用例上,对冻结的提交进行测试,并依据由需求推导出的评分标准,在硬性通过/不通过门槛下评估行为;对于优化阶段,则依据源基准自身的目标进行评估。通过跨多个模型和评测框架评估一系列编码智能体,我们发现没有一个能够接近交付需求所要求的内容:构建者所展示的效果与其实际交付之间的差距是常态,而非特例。随附的失败轨迹实证分析识别出反复出现的失败模式,其中包括对可见样例的过拟合、看似完整代码背后的空壳运行时,以及缺乏依据的完成声明;每一种模式都是一个信号,编码智能体可据此学习构建它们被要求构建的智能体。
一句话总结
北京人工智能研究院、中国科学院自动化研究所以及中国人民大学的研究人员提出了 AgentSWE,这是一个包含 25 个任务的基准,覆盖 agent 创建、编辑和优化,在留出的委托式需求上评估编程 Agent,发现没有一个能忠实交付,并识别出对可见用例过拟合、空洞运行时以及无依据的完成声明等反复出现的失败模式。
核心贡献
- AgentSWE 被提出作为面向 agent 软件工程的基准,覆盖三个生命周期阶段:创建、编辑和优化;其中 25 个任务以委托方式设计,并在留出用例上通过由需求派生的评分标准进行评估,创建和编辑采用硬性通过/失败门槛,优化任务采用源基准目标。
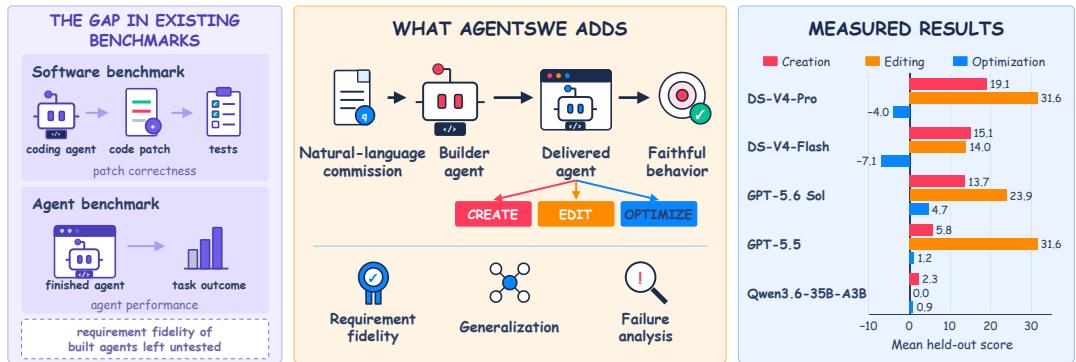
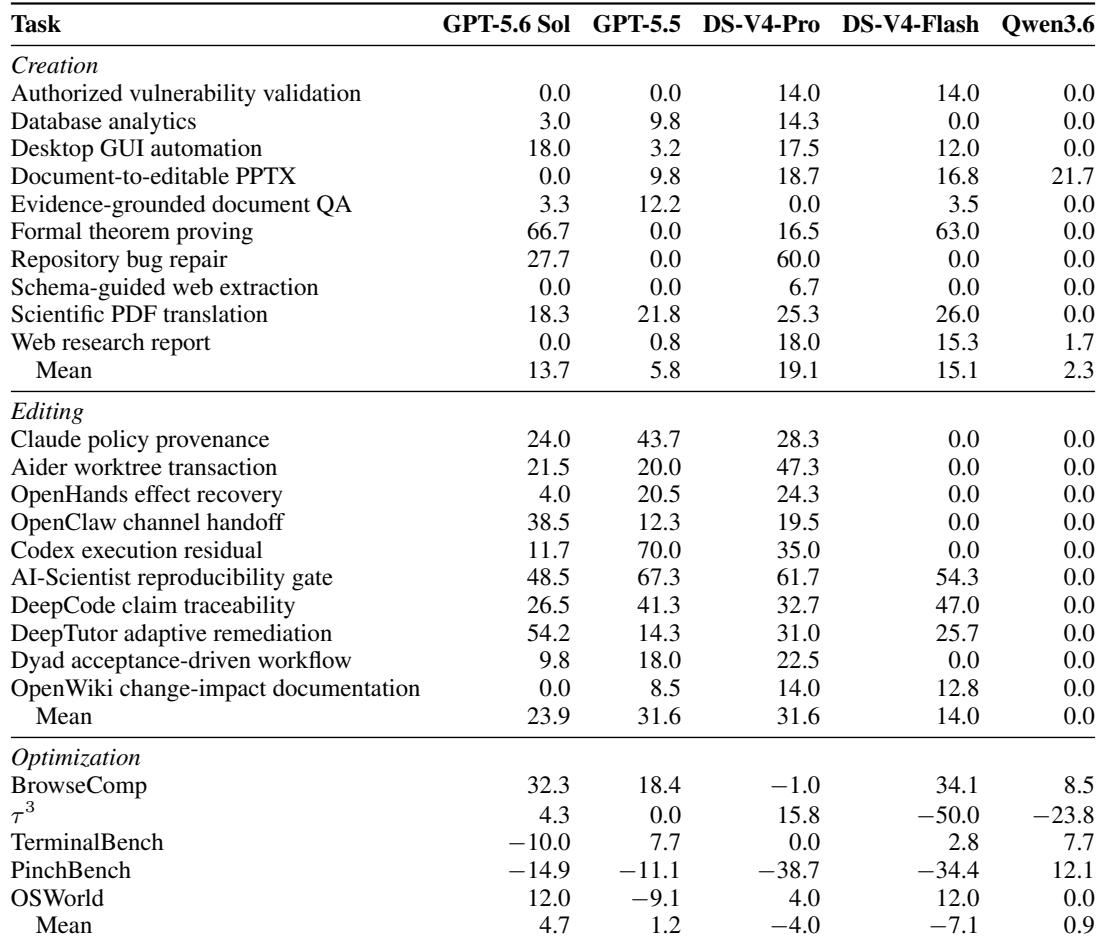
- 跨模型和 harness 的评估发现,没有任何编程 Agent 能忠实满足需求:创建任务上最强平均忠实度为 19.1,编辑任务上为 31.6;优化任务构建者平均只将与目标之间剩余差距缩小至多 5%。
- 随附的实证失败分析识别出反复出现的失败模式,例如对可见用例过拟合、表面代码完整但实际空洞的运行时,以及无依据的完成声明,指出了编程 Agent 需要改进的方向。
引言
Claude Code 和 Codex 等编程 Agent 已经承担了大量工程工作,非工程师用户也越来越多地把构建 Agent 的工作委托出去,这些 Agent 围绕重复性任务将模型、工具和状态组合在一起。这种委托之所以重要,是因为它依赖于对编程 Agent 能够交付用户所期望的 Agent 的信任;但创建、编辑和优化生命周期可能以细微方式失败:只拟合可见用例、交付不进行实际工作的运行时,以及声称完成但记录并不支持。现有基准无法捕捉这一差距。SWE-bench 风格套件将传统代码与已知参考进行对比,Agent 基准评估的是成品 Agent,而不是编程 Agent 是否能够构建它们,元 Agent 工作衡量的是基准分数的提升,而不是忠实交付。作者提出了 AgentSWE,这是一个包含二十五个委托式任务的基准,覆盖全部三个生命周期阶段。它只向构建者提供公开的开发用例,冻结交付的 Agent,并使用由需求派生的评分标准和有效性门槛在留出用例上评分,从而直接衡量编程 Agent 能否忠实地创建、修改和优化 Agent。
数据集
数据集构成与来源
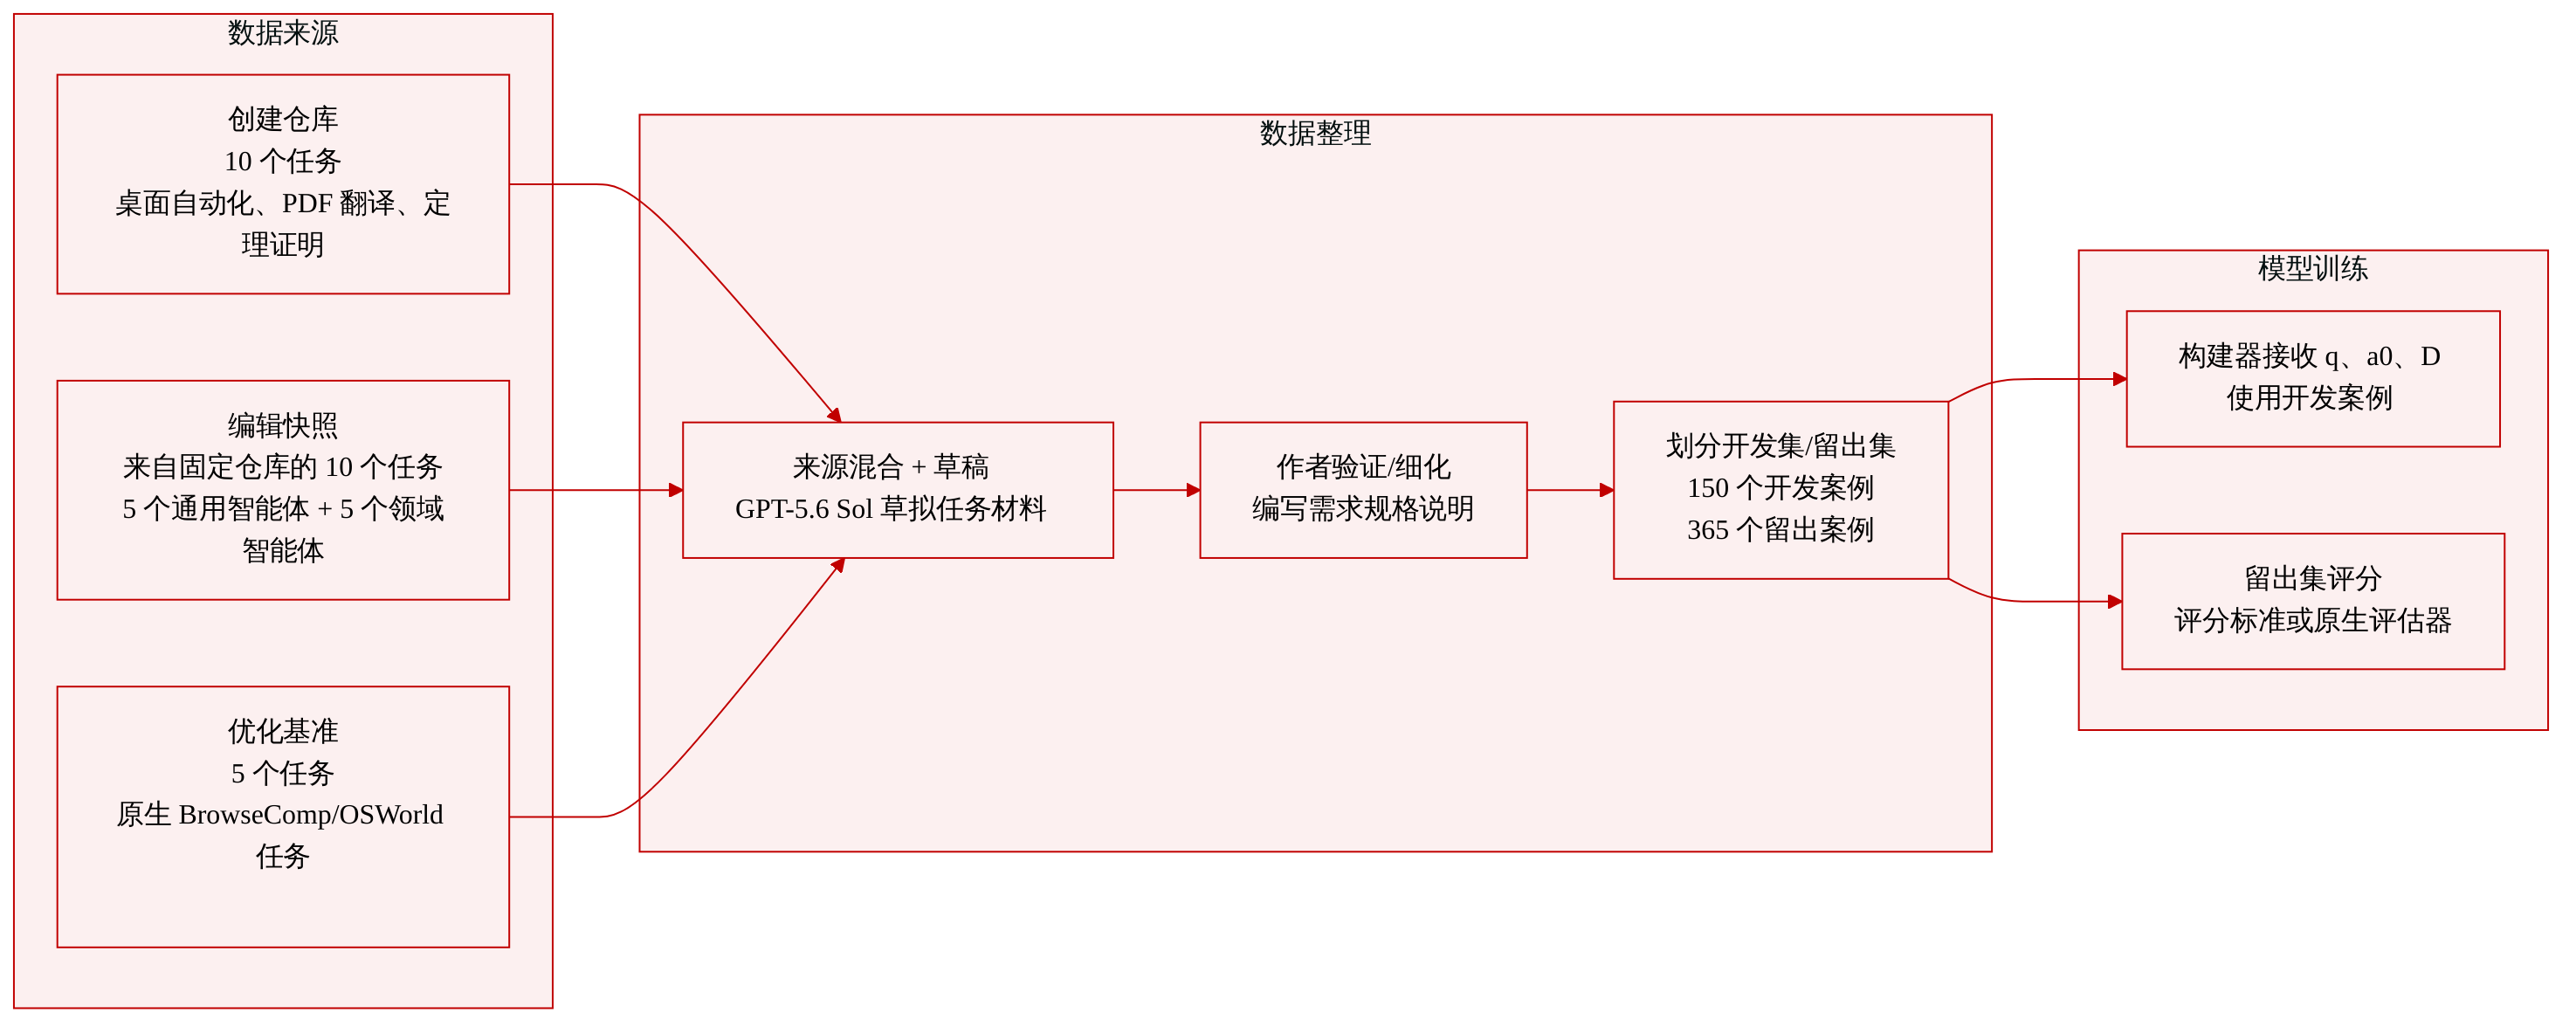
- AgentSWE 是一个包含 25 个任务的基准:10 个创建任务、10 个编辑任务和 5 个优化任务。
- 创建任务来自 GitHub 上的开源领域 Agent,覆盖桌面自动化、科学 PDF 翻译和形式化定理证明等领域。
- 编辑任务从五个通用编程 Agent 和五个领域 Agent 的固定仓库快照出发,其中包括 Claude Code、Aider、Open-Hands 和 OpenClaw。
- 优化任务构建在 BrowseComp、τ³、TerminalBench、PinchBench 和 OSWorld 之上,并保留其原生任务定义。
关键子集细节
- 创建任务:每个源仓库被逆向工程为一个自包含目标和一组功能需求,然后扩展能力请求,以拓宽其用途并提高组合难度。输入由 Markdown 文件组成,说明目标、接口契约、约束和资源。初始工件为空。
- 编辑任务:委托的能力来自设计头脑风暴或仓库中未解决的问题。作者保留具有重要用户需求、实现边界有限且行为可以通过执行验证的提案。每项提案被撰写为功能规格,包含验收边界以及固定快照已承担的回归义务。
- 优化任务:每个任务提供一个起始 Agent 作为初始工件。需求指明目标、构建者可编辑的文件以及不可更改的运行时资源。
评估包与统计
- 每个任务将构建者可见材料,即需求 q、初始工件 a0 和开发用例 D,与保留的评估材料分开。
- 创建和编辑任务各发布两个开发用例,并各留出六个评估用例。
- 优化任务从源基准的实例池中划分一个开发划分,并留出一个不相交的划分。
- 整个套件包含 150 个开发用例和 365 个留出用例。
- 留出的创建和编辑用例考察开发用例中省略的需求条款和能力交互。保留的留出输入、评估器状态、评分契约、凭据以及模型路由不会暴露给构建者。
处理与使用
- 任务材料由 GPT-5.6 Sol 根据所分析的源系统起草,然后由作者验证和完善。
- 该基准不描述常规的训练划分或混合比例。构建者 Agent 接收 q、初始工件和开发用例,交付的 Agent 在留出用例上评分。
- 创建和编辑任务使用从功能需求加权得出的任务特定 Result 评分标准,并对接口契约和约束违规设置门槛和上限。优化任务保留其源基准的原生评估器。未描述图像裁剪策略。
方法
作者通过统一的起草和验证工作流构建基准任务。每个任务族以各自方式确定需求 q 和初始工件 a0。在每一个任务族中,GPT-5.6 Sol 根据所分析的源系统起草任务材料,作者在最终确定前对每份草稿进行验证和完善。
对于创建任务,源系统是 GitHub 上的开源领域 Agent,覆盖桌面自动化、科学 PDF 翻译和形式化定理证明等领域。每个仓库被逆向工程为一个自包含目标和一组功能需求。然后这些需求被扩展出额外能力,以拓宽原始用途并提高组合难度。所得到的任务以输入 Markdown 文件发布,其中说明 q 的目标、接口契约、约束和资源。创建任务的初始工件为空。
对于编辑任务,基准从五个通用编程 Agent 和五个领域 Agent 的固定仓库快照 a0 出发进行扩展,其中包括 Claude Code、Aider、Open-Hands 和 OpenClaw。委托能力来自设计头脑风暴或仓库中未解决的问题。作者保留具有重要用户需求、实现范围有限且行为可以通过执行验证的提案。每项被接受的提案被撰写为功能规格,包含验收边界以及 a0 已承担的回归义务。
对于优化任务,基准构建在 BrowseComp、τ3、TerminalBench、PinchBench 和 OSWorld 之上,同时保留其原生任务定义。每个任务提供一个起始 Agent 作为 a0。需求指明目标、构建者可编辑的文件以及构建者不可更改的运行时资源。
实验
AgentSWE 基准在创建、编辑和优化任务上评估构建其他 Agent 的编程 Agent,使用留出用例和冻结交付协议。实验表明所有构建者都面临困难:创建 Agent 很少成功,编辑 Agent 只交付部分能力或一无所获,优化的收益不一致且常常对可见开发用例过拟合。轨迹分析识别出反复出现的失败模式,包括过拟合、执行时失败的空洞运行时,以及无依据的完成声明。后续消融实验发现,少量开发用例有帮助,但更多开发用例没有帮助;延长预算不能缩小泛化差距;结果在不同 harness 与模型的组合以及重复构建之间差异很大。
创建运行显示出罕见且特定于任务的成功,大多数结果很低或为零,没有构建者能够可靠地生成所请求的 Agent。编辑只产生部分能力或完全没有交付,优化收益在各任务上较小且不一致。总体而言,三个生命周期阶段的留出性能仍然较弱。创建成功罕见且集中,大多数运行得分为零或接近零,只有少数运行超过 50。编辑要么实现部分能力,要么结束时没有候选结果;优化收益强烈依赖于任务,BrowseComp 大多有所改善,而 PinchBench 大多恶化。
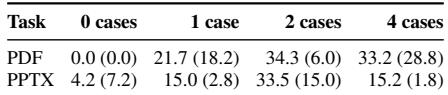
在三次构建者运行中,当给构建者提供一到两个开发用例时,PDF 翻译和 PPTX 生成的留出性能有所提升,其中两个用例带来的增益最大。在没有开发用例的情况下,PDF 翻译在所有运行中得分为零;在有四个用例时,性能没有进一步提升,并且 PPTX 生成相对于两个用例条件出现下降。从零个开发用例增加到两个开发用例,两个任务族的留出平均得分都提高;PDF 翻译在没有开发用例时从零开始。超过两个开发用例后,PDF 的平均得分趋于平稳,而 PPTX 得分从两个用例的峰值回落,PDF 的逐次运行差异扩大。
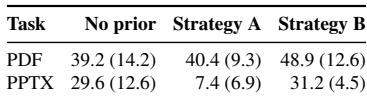
提示先验对不同任务的影响不同。指定设计先验使 PDF 翻译性能几乎不变,但显著降低 PPTX 生成性能。自测先验仅在逐次运行差异范围内带来有限的 PDF 提升,并使 PPTX 平均性能保持稳定,同时缩小其分布范围。策略 A 对 PDF 翻译几乎没有影响,但显著降低 PPTX 生成得分。策略 B 仅在逐次运行差异范围内提高 PDF 得分,并缩小 PPTX 结果的波动性,而不改变其平均值。
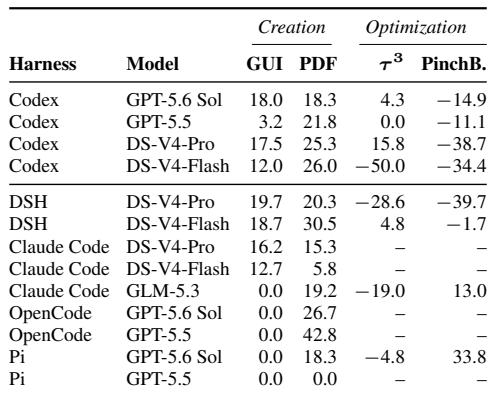
留出的创建和优化得分在不同 harness 与模型组合之间发生显著变化,即使模型保持不变。没有一个 harness 在所有模型或任务上都领先,因此结果支持评估特定组合,而不是仅评估模型。DeepSeek-V4-Flash 在 DSH 下表现远好于在 Codex 下,其留出创建得分更高,优化得分的负值幅度也更小。对于 DeepSeek-V4-Pro,harness 效果好坏参半:Codex 产生更强的 PDF 创建得分,而 DSH 产生更强的 GUI 创建得分。
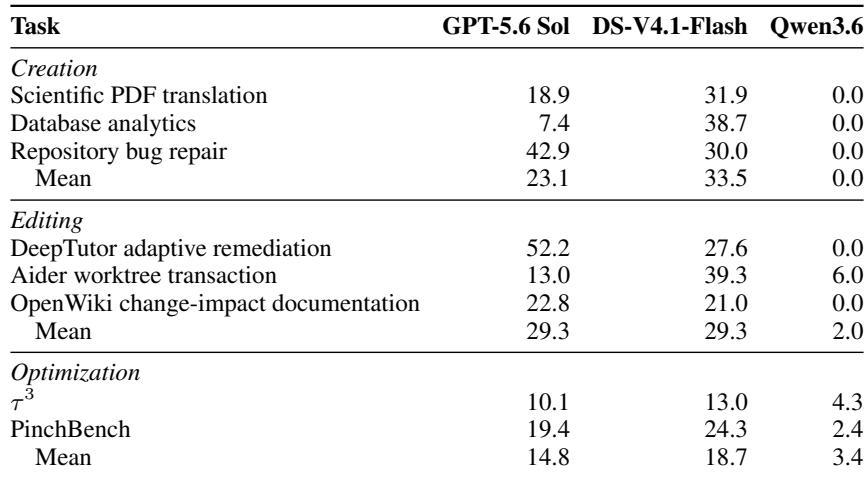
在 AgentSWE-Lite 中,重复构建的留出平均结果同时取决于构建者和任务。DeepSeek-V4.1-Flash 在创建任务上的平均表现最强,尤其是在 PDF 翻译和数据库分析上,而 GPT-5.6 Sol 在仓库缺陷修复和 DeepTutor 编辑任务上领先。Qwen3.6 在所有列出的任务上留出结果为零,同一组合的重复构建可能变化很大。DeepSeek-V4.1-Flash 在创建平均分上领先,而 GPT-5.6 Sol 在仓库缺陷修复和 DeepTutor 编辑任务上领先。Qwen3.6 在所有列出的创建和编辑任务上留出得分为零,并且同一组合内的重复构建可能差异很大。
实验在留出任务上评估了跨创建、编辑和优化的 Agent 构建,包括 PDF 翻译、PPTX 生成、BrowseComp、PinchBench 和 AgentSWE-Lite。总体留出性能较弱且不一致,没有构建者能够可靠地生成所请求的 Agent,编辑常常只产生部分候选或没有候选,优化收益较小且依赖任务。提供一到两个开发用例可以改善 PDF 翻译和 PPTX 生成,但更多用例会趋于平稳或损害 PPTX;提示先验和 harness 与模型的组合会因任务和模型不同而对结果产生不同影响;多个构建者(如 Qwen3.6)得分为零,重复构建变化很大。