Command Palette
Search for a command to run...
首次实现世界地图按需生成,谷歌 DeepMind 发布 AlphaEarth Foundations
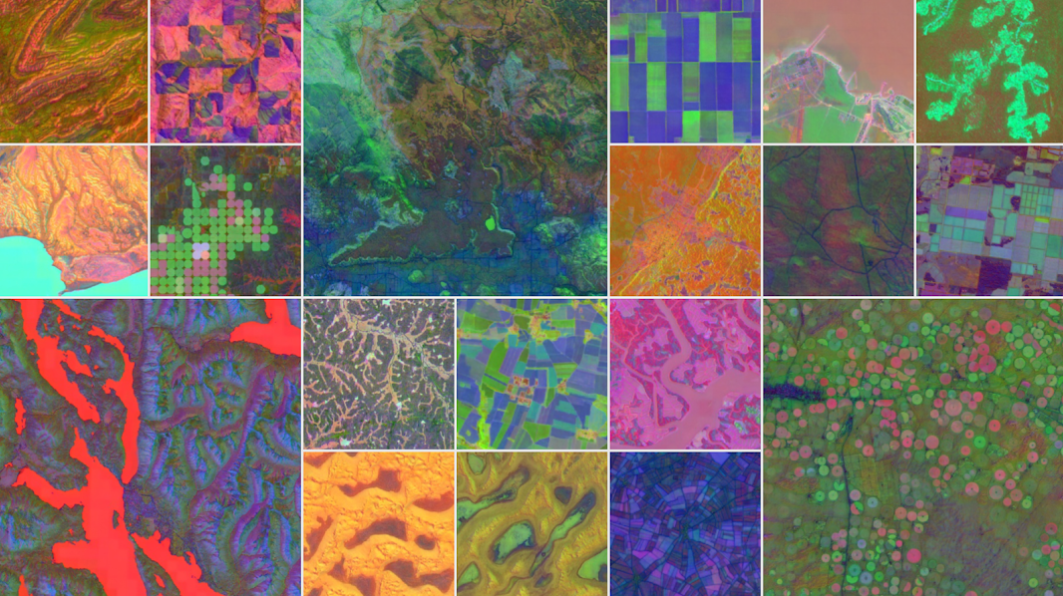
随着卫星技术的发展,人类已经能够近乎实时地观测地球。然而,海量、多模态、更新频繁的遥感数据虽然信息丰富,却也带来了新的难题——数据来源分散、格式不一、使用复杂,如何将这些零散的信息整合为一致、可用的地球视角,成为科学家与政策制定者面临的重大挑战。谷歌 DeepMind 最新发布的 AlphaEarth Foundations 正式回应了这一挑战。这款模型可以被视为一颗「虚拟卫星」,融合 PB 级地球观测数据,生成一种计算系统能够高效处理的数字化地球嵌入(embedding)。这一创新技术为农业监测、环境保护、城市扩张、水资源管理等关键议题带来了前所未有的全局视角。
* 论文链接:
高度紧凑的数据减少存储空间
AlphaEarth Foundations 最核心的创新,在于它解决了遥感数据的两个核心难题:一是信息过载,二是数据不一致。为此,该模型汇集了来自数十个公共数据源的信息,包括光学卫星图像、雷达数据、三维激光扫描、气候模拟等,并将这些多源数据整合分析,以 10 米 x 10 米为单位,对全球陆地与沿海区域进行高精度建模。
该系统的核心创新在于其能够为每个方格生成高度紧凑的摘要,与其他人工智能系统相比,这些摘要所需的存储空间仅为其 1/16,这极大地降低了行星级分析的成本。
换句话说,这一模型首次实现了「全球地图按需生成」,研究人员无需等待特定卫星经过上空、也无需面对云层遮挡等传统难题,可以通过 AlphaEarth Foundations 的嵌入向量,即刻获取清晰、结构化、连贯的地球图谱。
性能全面领先于其他模型
AlphaEarth Foundations 的工作原理如下图所示,该系统通过从视频序列中提取非均匀采样帧来索引任意时间点。这有助于模型构建该位置的连续视图,同时解释大量测量数据。

这种优势使得该系统成为科研与公共服务领域不可替代的工具。例如在厄瓜多尔,该模型能够穿透常年云层,细致描绘不同农业地块的发展阶段;在南极洲,即便是卫星成像频率极低的区域,模型也能稳定还原地表结构;在加拿大,其描绘出的农田利用差异,甚至超越了肉眼可见的细节。

目前最大规模 AI 地球嵌入数据集之一
为了推动更广泛的应用,谷歌现已将 AlphaEarth Foundations 生成的年度嵌入向量集合,以「卫星嵌入数据集(Satellite Embedding dataset)」的形式发布在 Google Earth Engine 平台上。这一数据集覆盖全球每年超过 1.4 万亿个嵌入点,成为目前最大规模的 AI 地球嵌入数据集之一。
过去一年中,已有 50 多家组织试用了该数据集,覆盖学术界、政府机构与非营利组织。全球生态系统地图计划(Global Ecosystems Atlas)就是其中的典型案例,该项目旨在打造全球生态系统的首个系统性分类资源。借助 AlphaEarth 的数据,其成功将过去未分类的生态区域归入「滨海灌丛」、「极干旱沙漠」等类别,为各国优化自然保护与恢复行动提供科学依据。
詹姆斯库克大学全球生态实验室主任 Nick Murray 表示,「这个数据集正在彻底改变我们对未绘制生态系统的认知,对于制定保护区优先级至关重要。」
在巴西,环保组织 MapBiomas 正在利用该数据集深入研究农业用地和环境变化,特别是在亚马逊等关键生态区。项目创始人 Tasso Azevedo 指出,「有了这个工具,我们绘制地图的精度、速度、覆盖范围都有了质的飞跃。以前完全无法做到的,现在都变得可能。」
未来,这种技术可能不仅用于静态地图,还能实时驱动灾害预警、气候变化模拟、粮食安全管理等全球性议题。谷歌方面也表示,他们将持续优化该模型,并扩大其数据集规模和应用边界。