HyperAI
Command Palette
Search for a command to run...
Papers
Daily updated cutting-edge AI research papers to help you keep up with the latest AI trends
3,198 papers
Multi-Stream Attention Residuals
VIS-Ground: Video Interactive Storytelling with Contextual Grounding
Thinking Inertia: LLMs Keep Thinking When Told Not To
SCALING AGENTIC DATA FOR LONG-HORIZON TERMINAL INTELLIGENCE
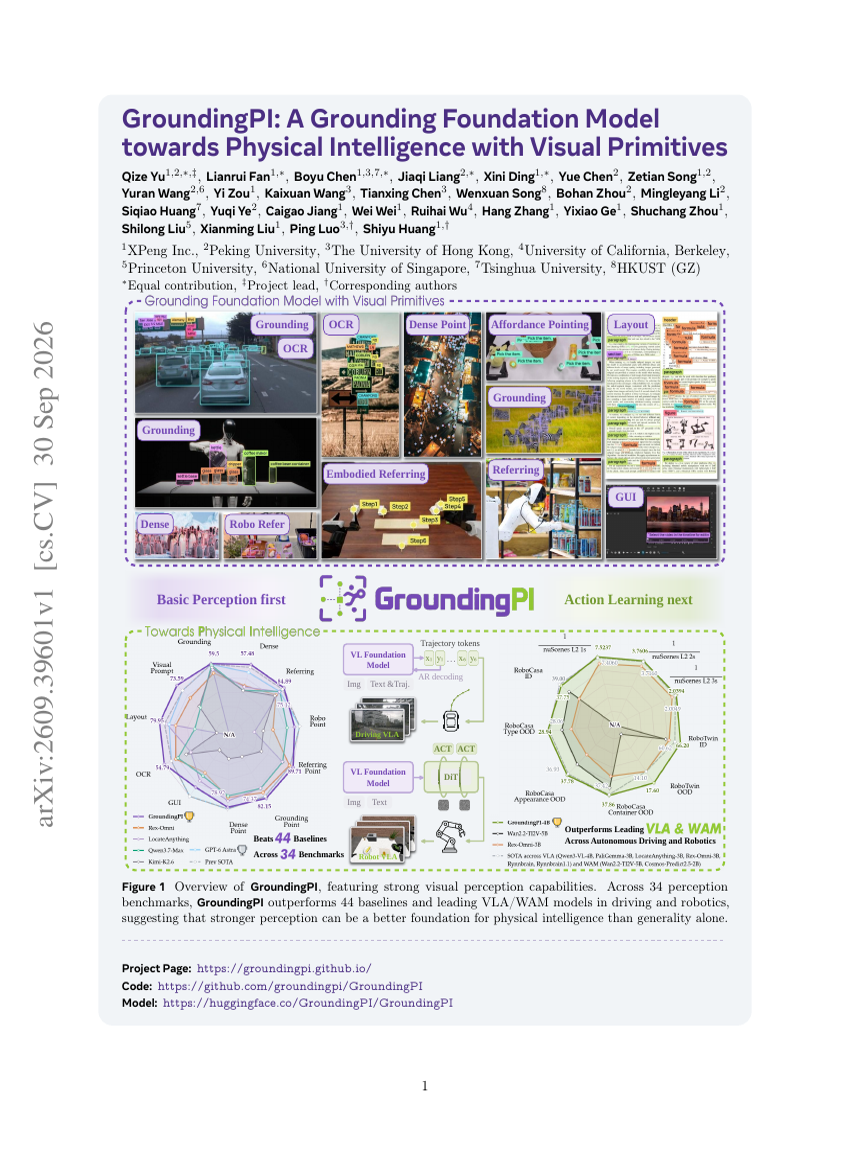
GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
AGENTSWE: CAN CODING AGENTS BUILD THE AGENT YOU ACTUALLY WANT?
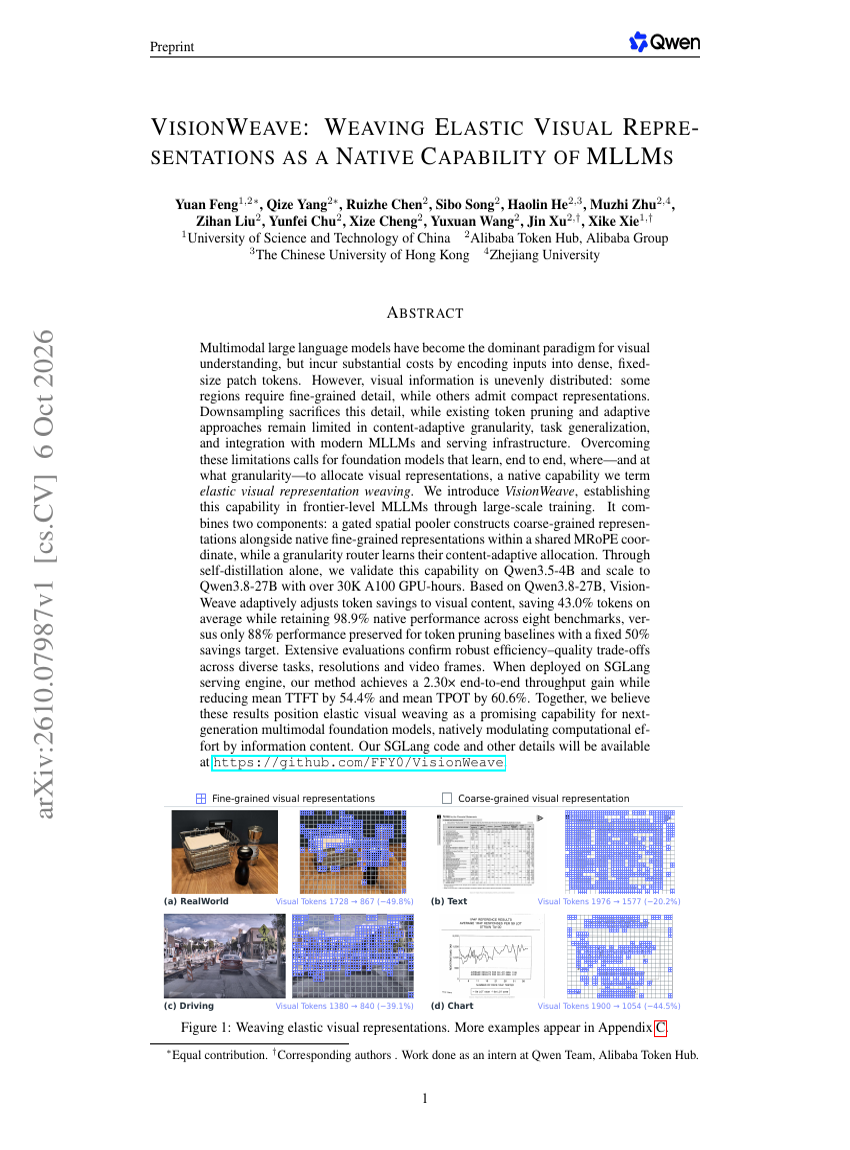
VISIONWEAVE: WEAVING ELASTIC VISUAL REPRESENTATIONS AS A NATIVE CAPABILITY OF MLLMS
EmbodiedCLBench: Evaluating Continual Learning for Self-Evolving Embodied Agents
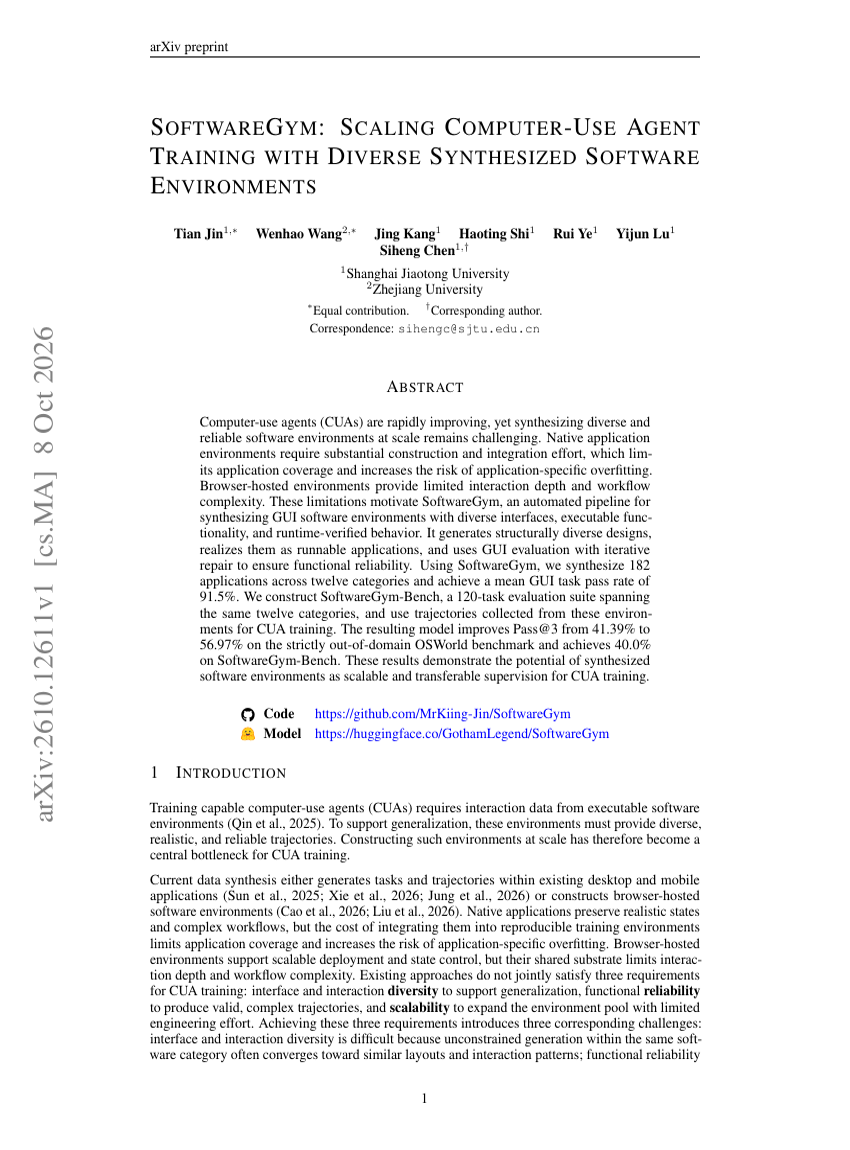
SOFTWAREGYM: SCALING COMPUTER-USE AGENT TRAINING WITH DIVERSE SYNTHESIZED SOFTWARE ENVIRONMENTS
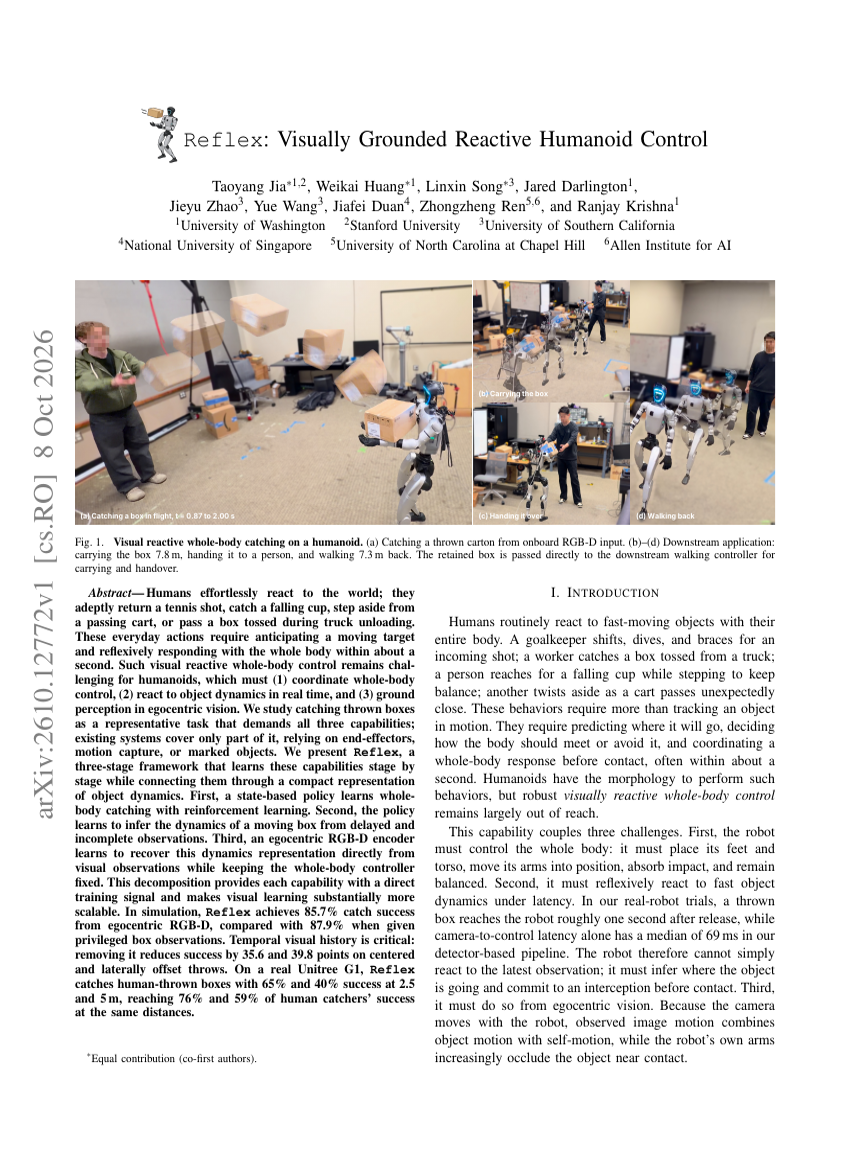
Reflex: Visually Grounded Reactive Humanoid Control
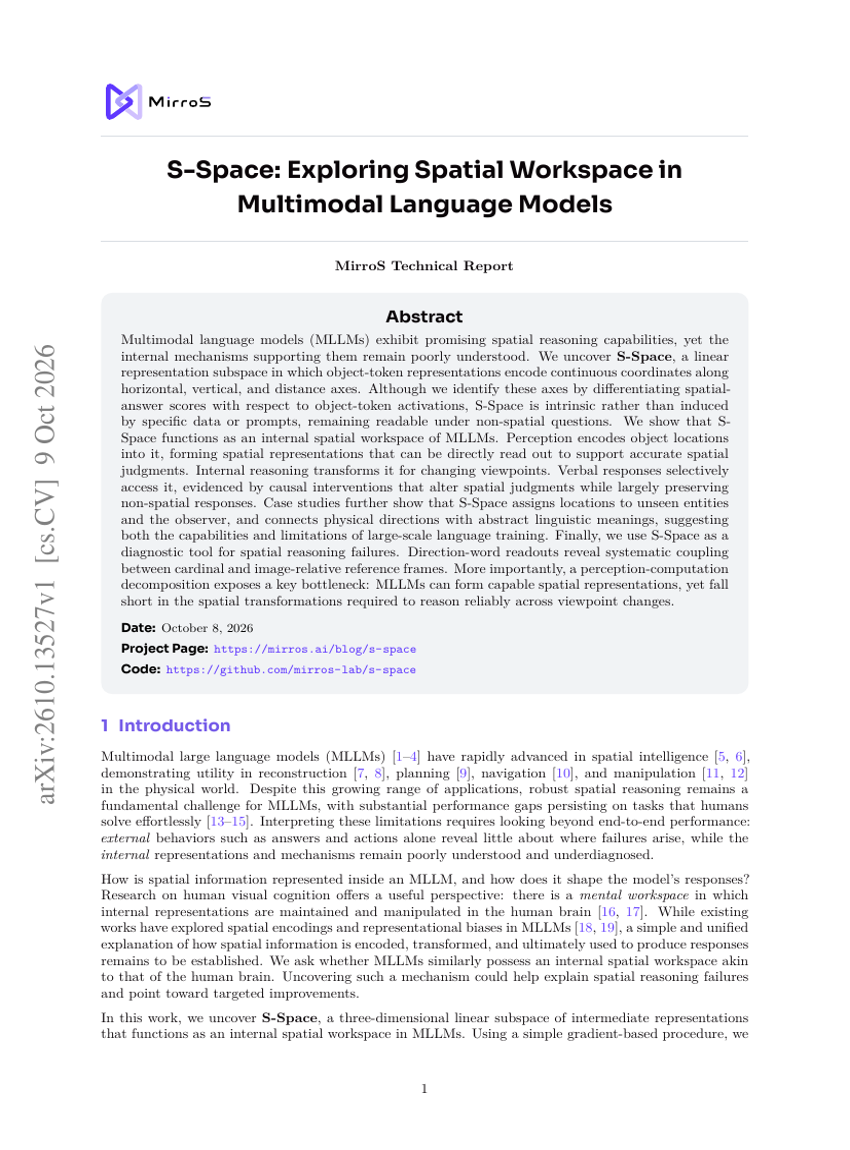
S-Space: Exploring Spatial Workspace in Multimodal Language Models
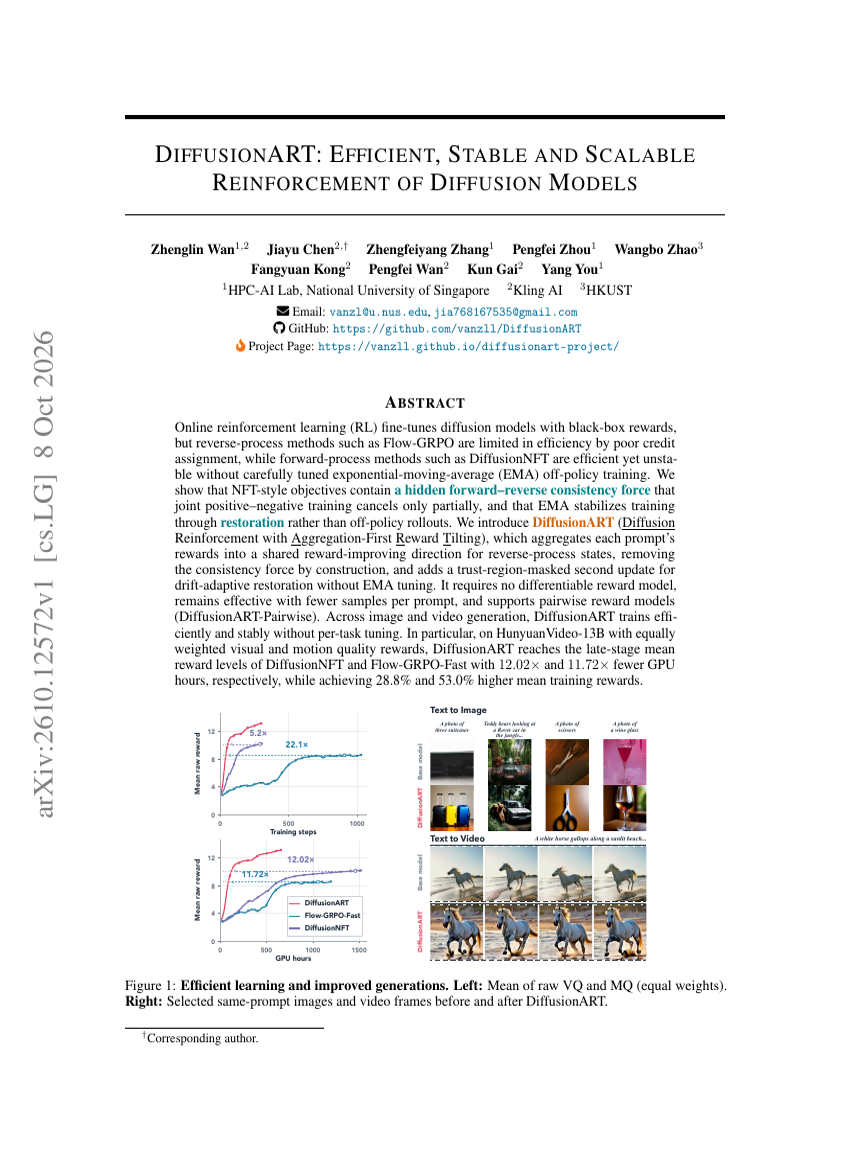
DIFFUSIONART: EFFICIENT, STABLE AND SCALABLE REINFORCEMENT OF DIFFUSION MODELS
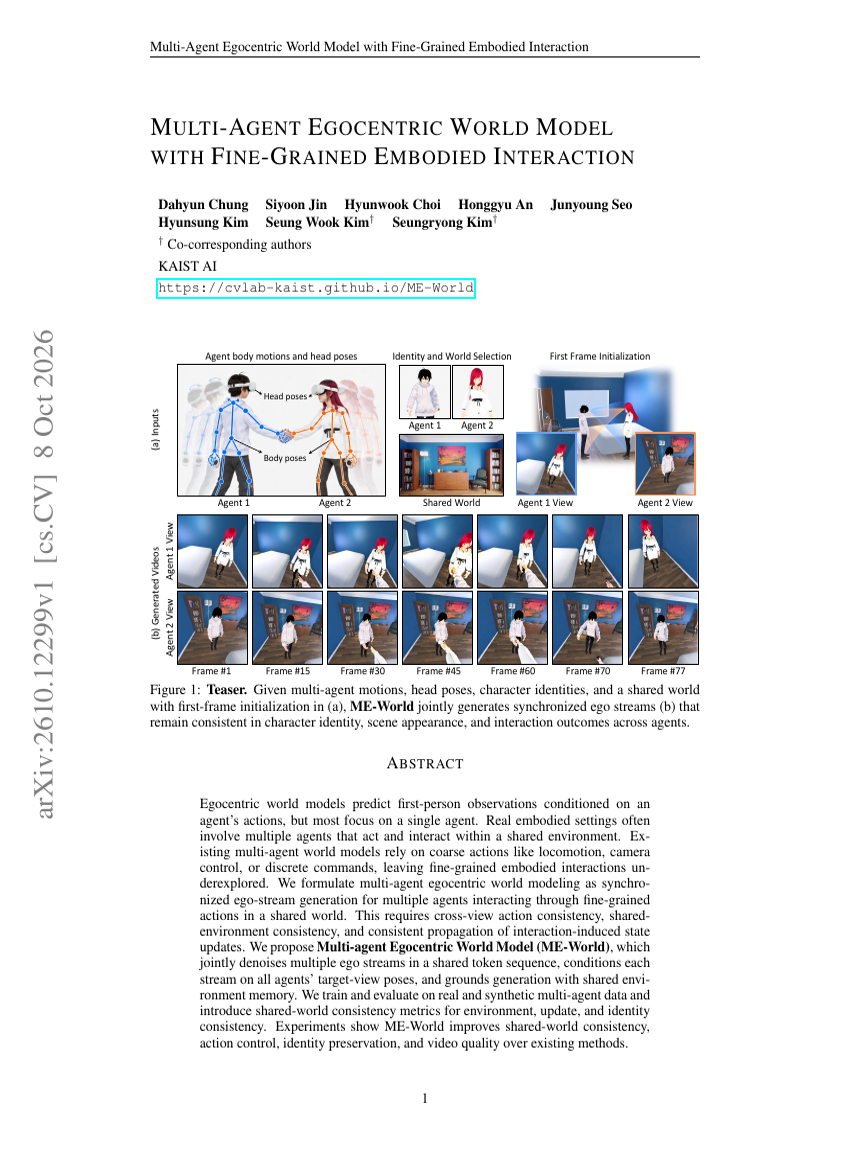
MULTI-AGENT EGOCENTRIC WORLD MODEL WITH FINE-GRAINED EMBODIED INTERACTION
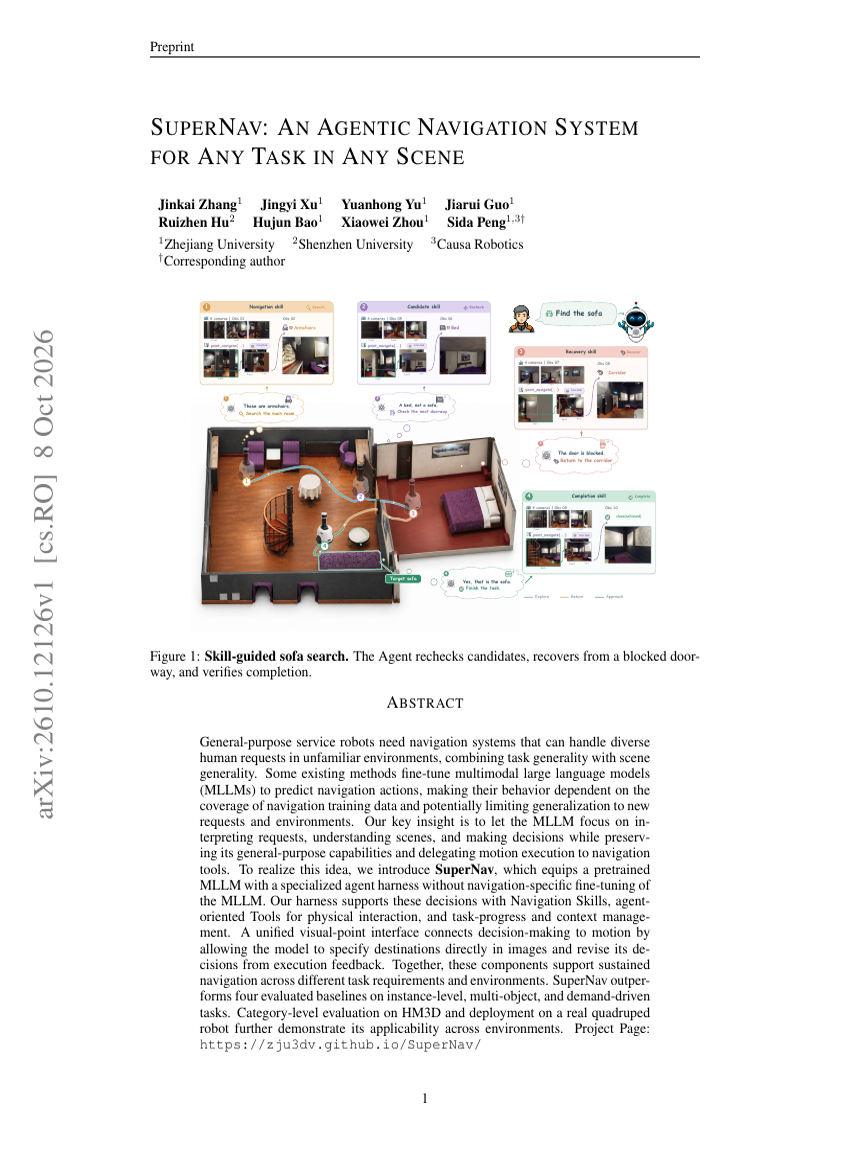
SUPERNAV: AN AGENTIC NAVIGATION SYSTEM FOR ANY TASK IN ANY SCENE
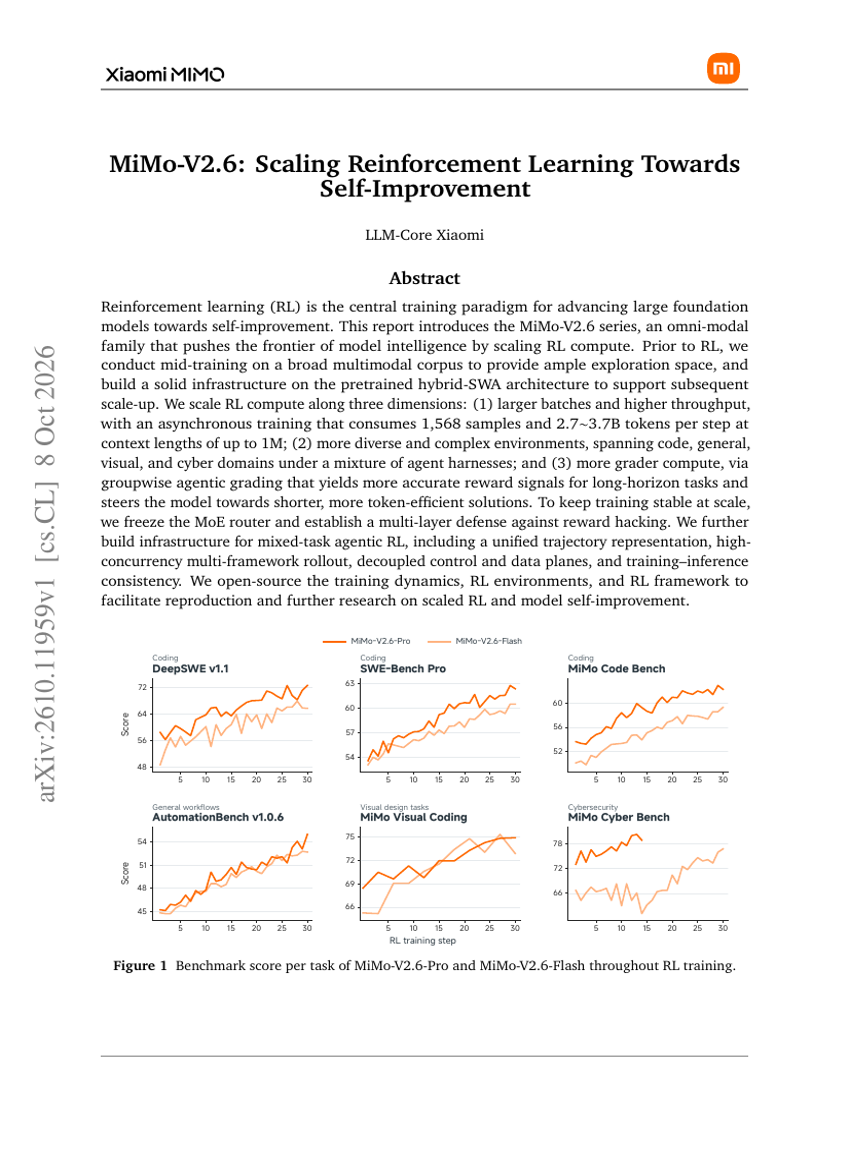
MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
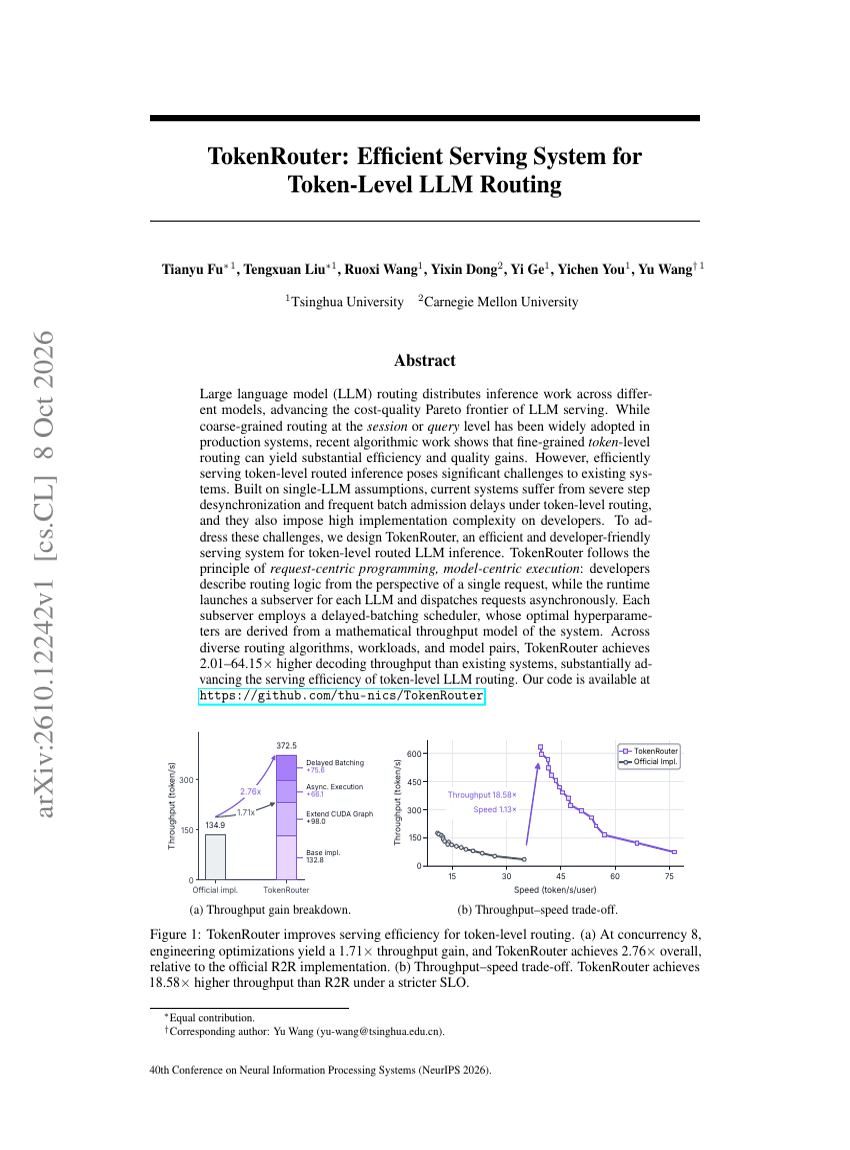
TokenRouter: Efficient Serving System for Token-Level LLM Routing
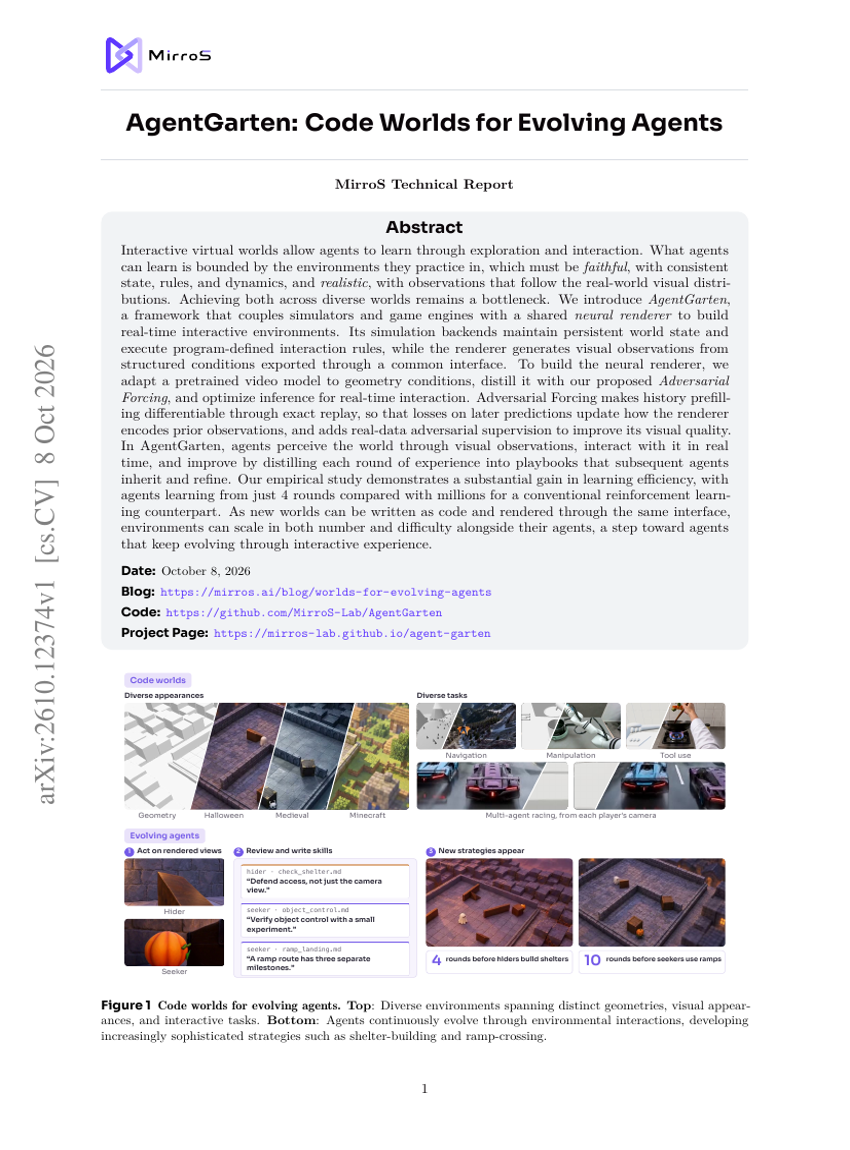
AgentGarten: Code Worlds for Evolving Agents
From Traces to Agentic Worlds: Agentic Language World Models for Interactive Environment Simulation
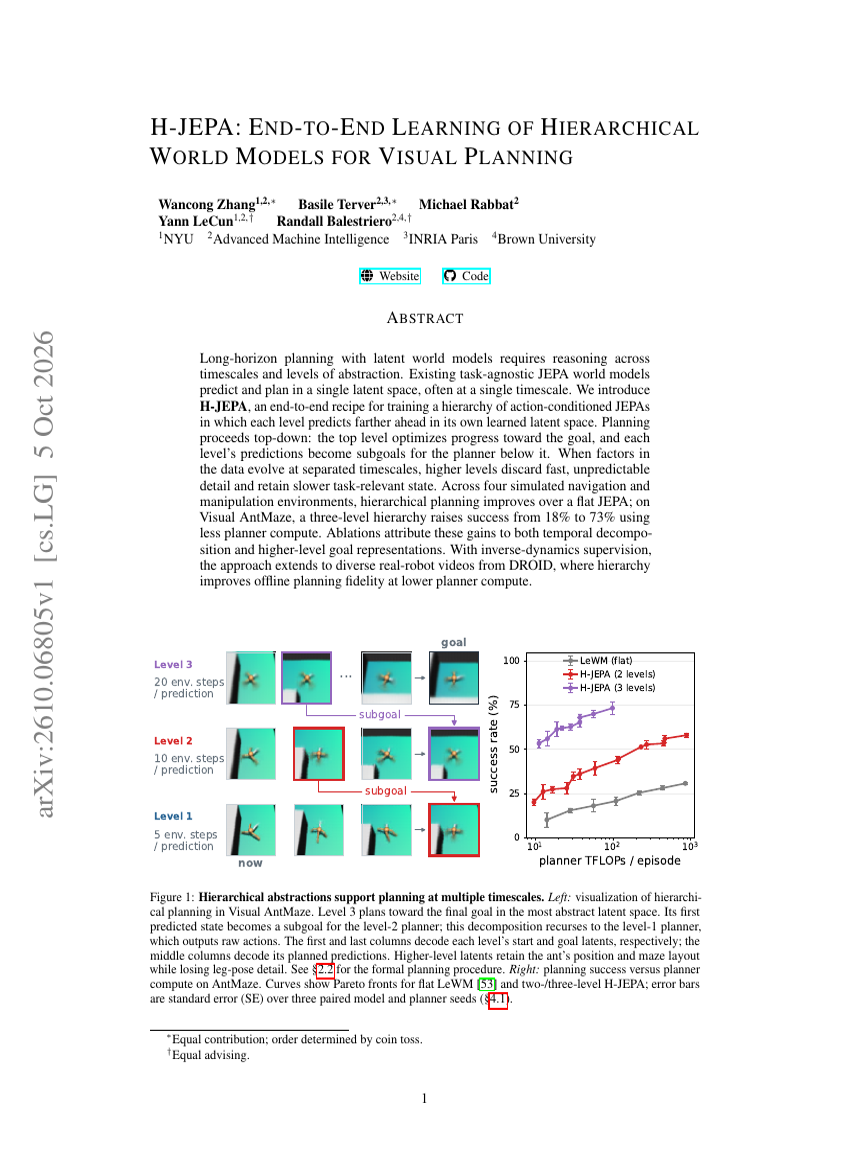
H-JEPA: END-TO-END LEARNING OF HIERARCHICAL WORLD MODELS FOR VISUAL PLANNING
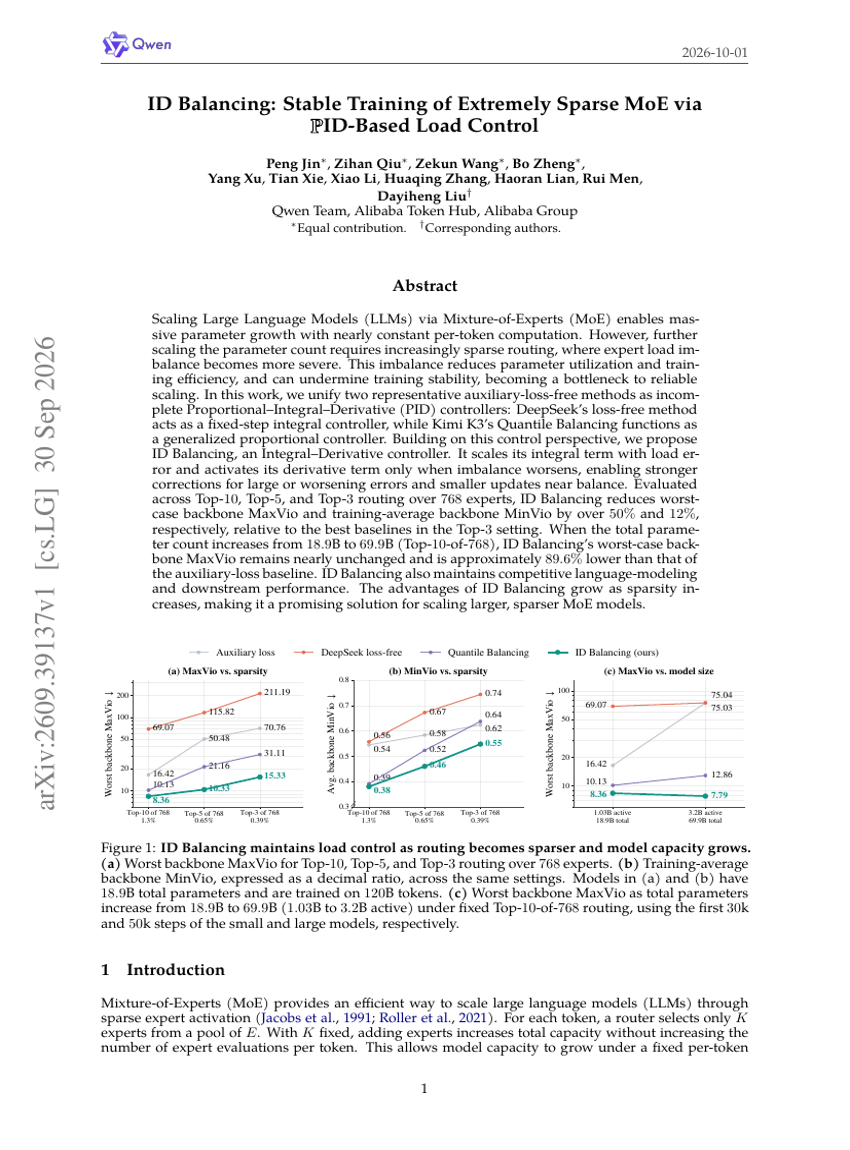
ID Balancing: Stable Training of Extremely Sparse MoE via PID-Based Load Control
GPU-Accelerated Astrodynamics World Models for Spacecraft Rendezvous and Proximity Operations
4DCodeBench: Benchmarking Agents on Inverse Graphics of Dynamic Scenes
QUESTIONING THE QUESTIONS: SUSTAINING SELF-EVOLUTION IN REASONING MODELS
DECEPEVAL: A BENCHMARK FOR EVALUATING DE-CEPTION IN LLM AGENTS
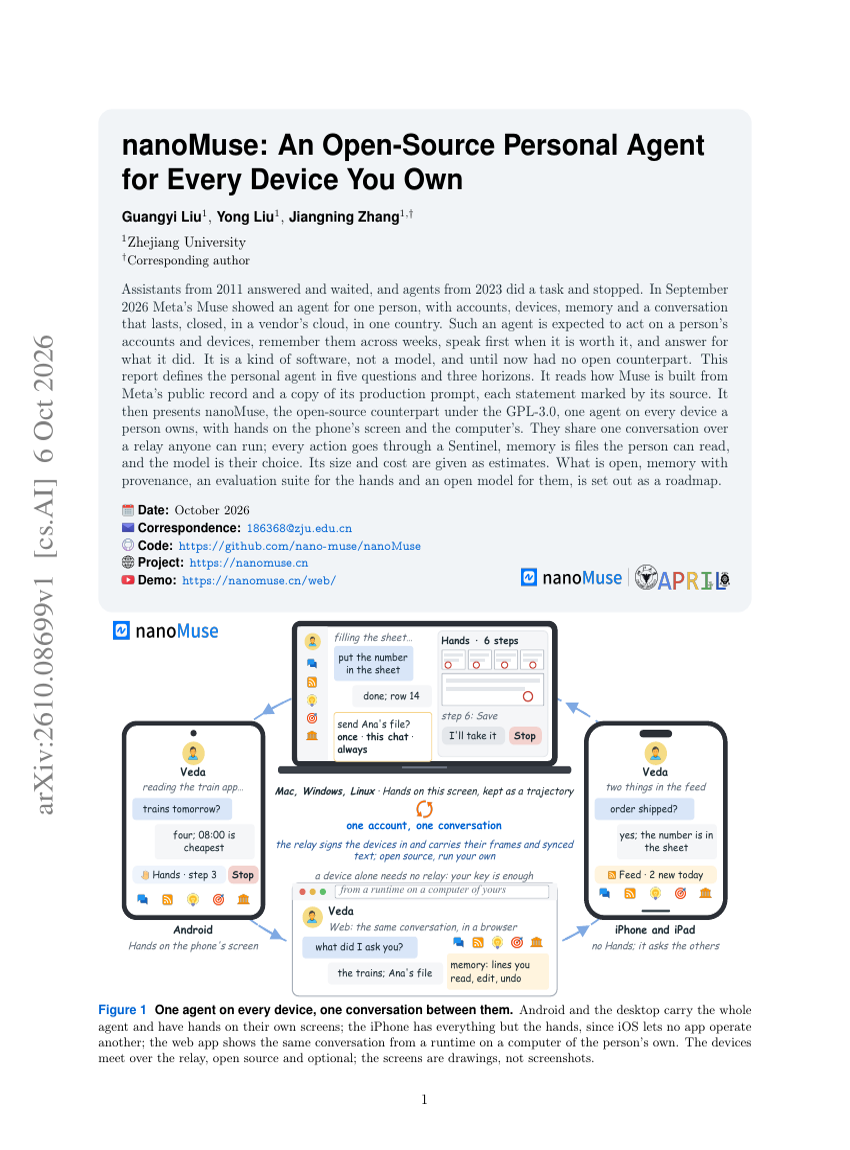
nanoMuse: An Open-Source Personal Agent for Every Device You Own
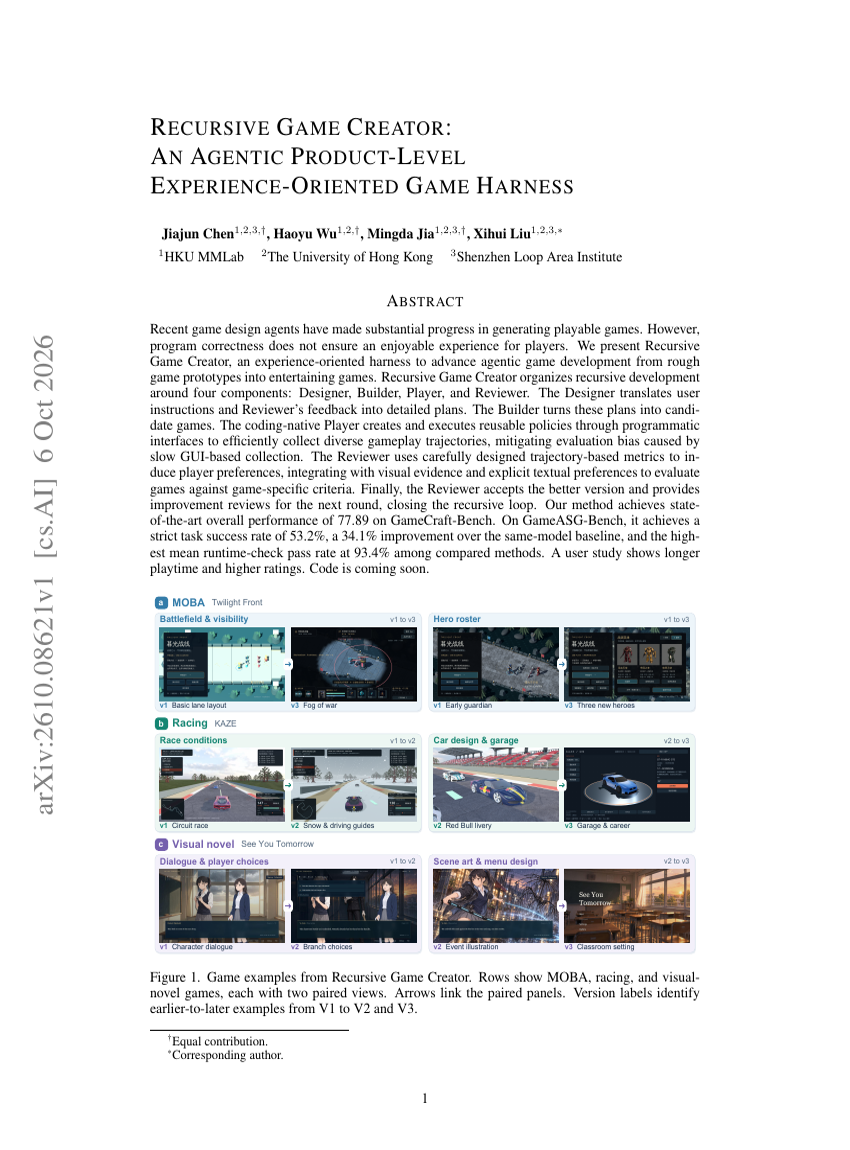
RECURSIVE GAME CREATOR: AN AGENTIC PRODUCT-LEVEL EXPERIENCE-ORIENTED GAME HARNESS
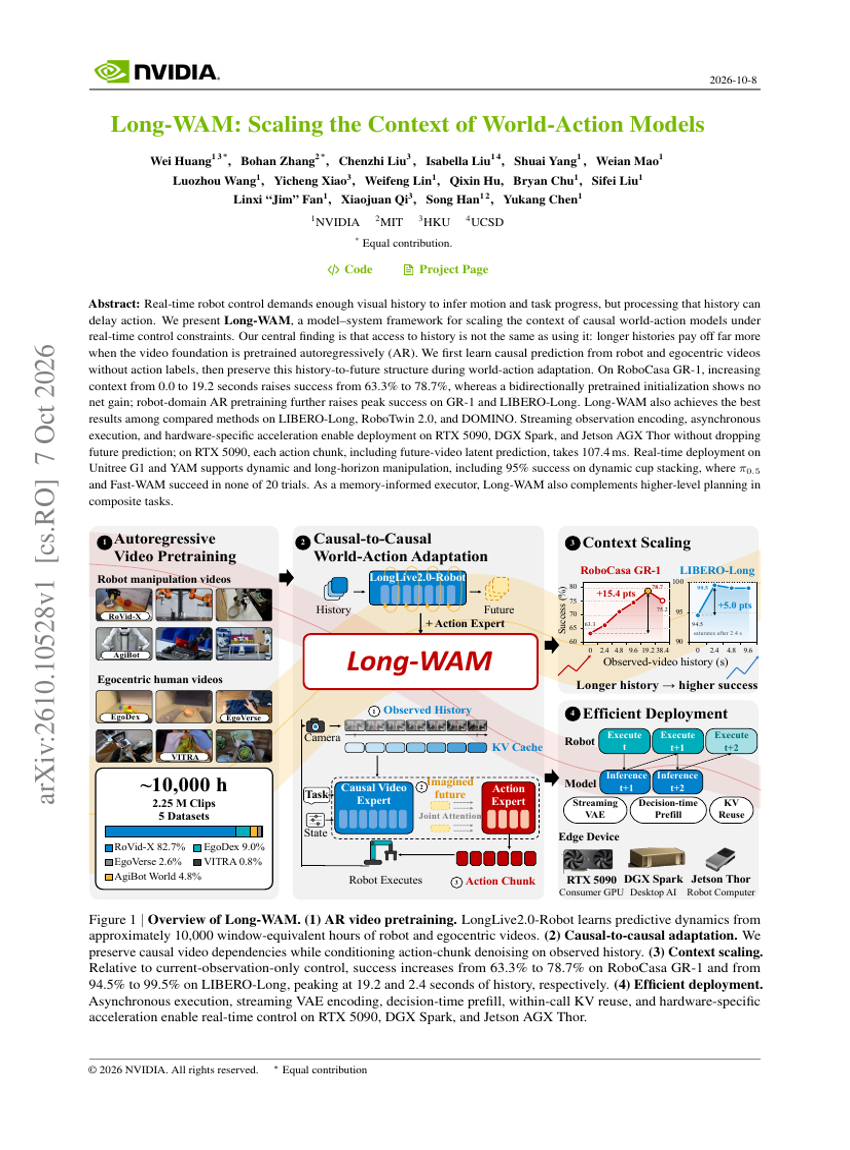
Long-WAM: Scaling the Context of World-Action Models
STEPQUANT: WHEN AND WHERE ERRORS MATTER IN DELTA-RULE RECURRENT STATE QUANTIZATION
WING: World Action Learning via INteraction-Centric Spectral Latent Guidance
FROM EVIDENCE TO ACTION: HOW TOOL-USING AGENTS FAIL
EVISKILL: GROUNDING SKILL EVOLUTION IN RE-PLAYABLE EVIDENCE
TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models