HyperAI
Command Palette
Search for a command to run...
Papers
Daily updated cutting-edge AI research papers to help you keep up with the latest AI trends
papers
DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation
RETHINKING CROSS-TOKENIZER ON-POLICY DISTILLATION: FROM ALIGNMENT COVERAGE TO SUPERVISION RELIABILITY
OPTIMIZING THE OPTIMIZER: LANGUAGE MODELS DISCOVER FASTER MOLECULAR RELAXATION
FOUNDATIONS OF PROACTIVE AGENTS: PRINCIPLES, TECHNICAL LAYERS, AND PROACTIVITY-GYM
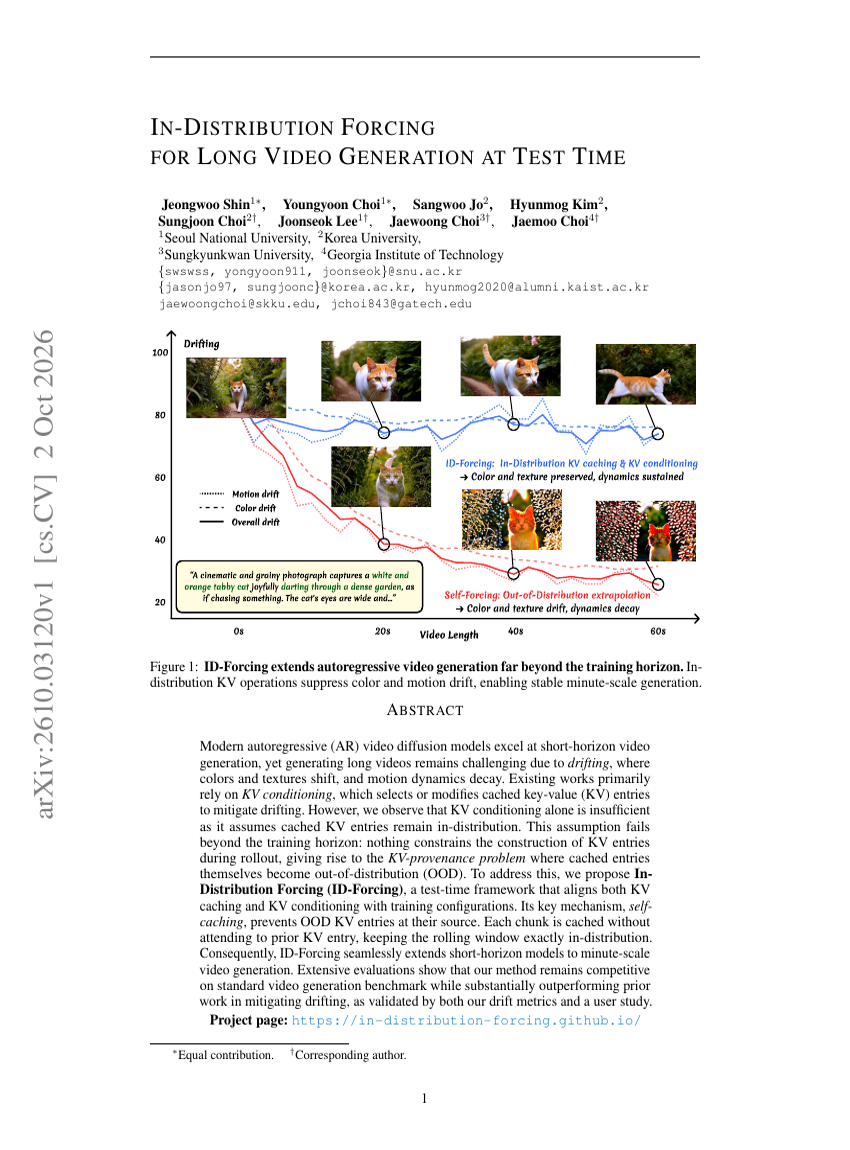
IN-DISTRIBUTION FORCING FOR LONG VIDEO GENERATION AT TEST TIME
MEMADAPTER: COUNTERFACTUAL ADAPTATION AGAINST MEMORY-INDUCED SYCOPHANCY
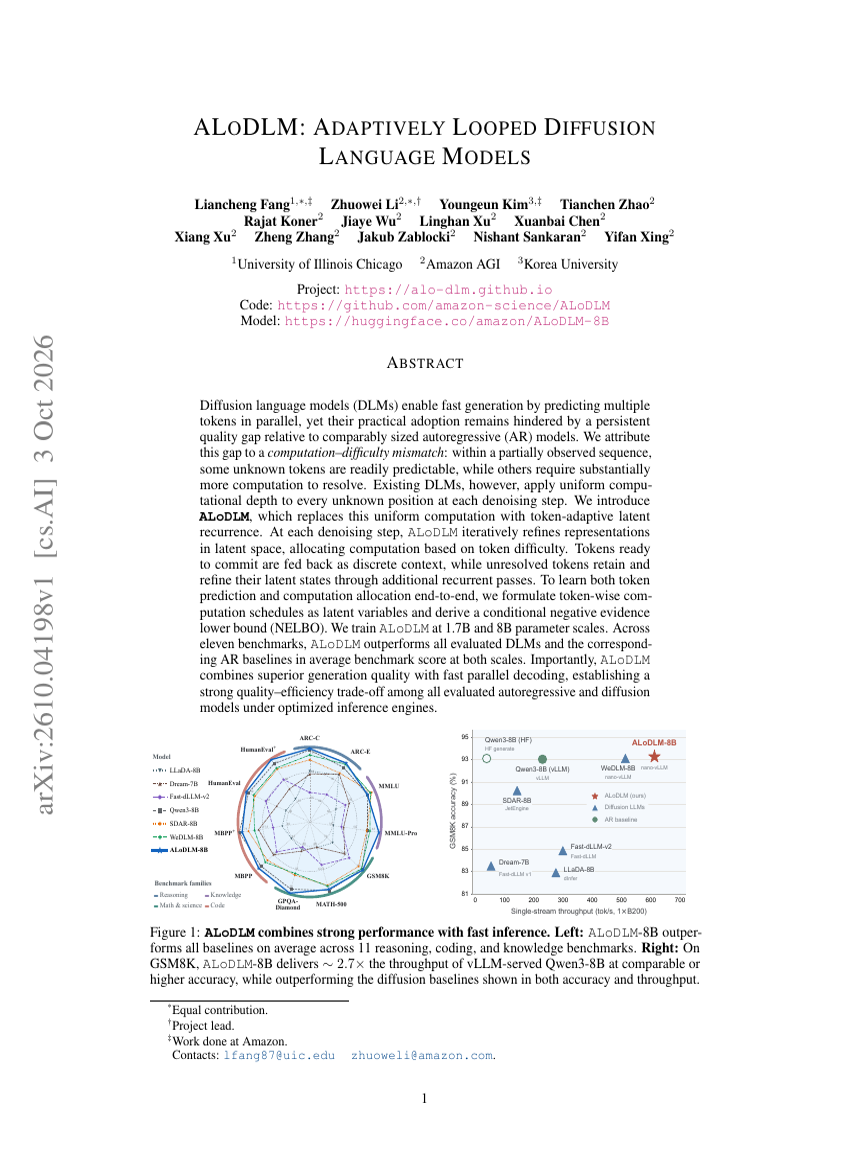
ALODLM: ADAPTIVELY LOOPED DIFFUSION LANGUAGE MODELS
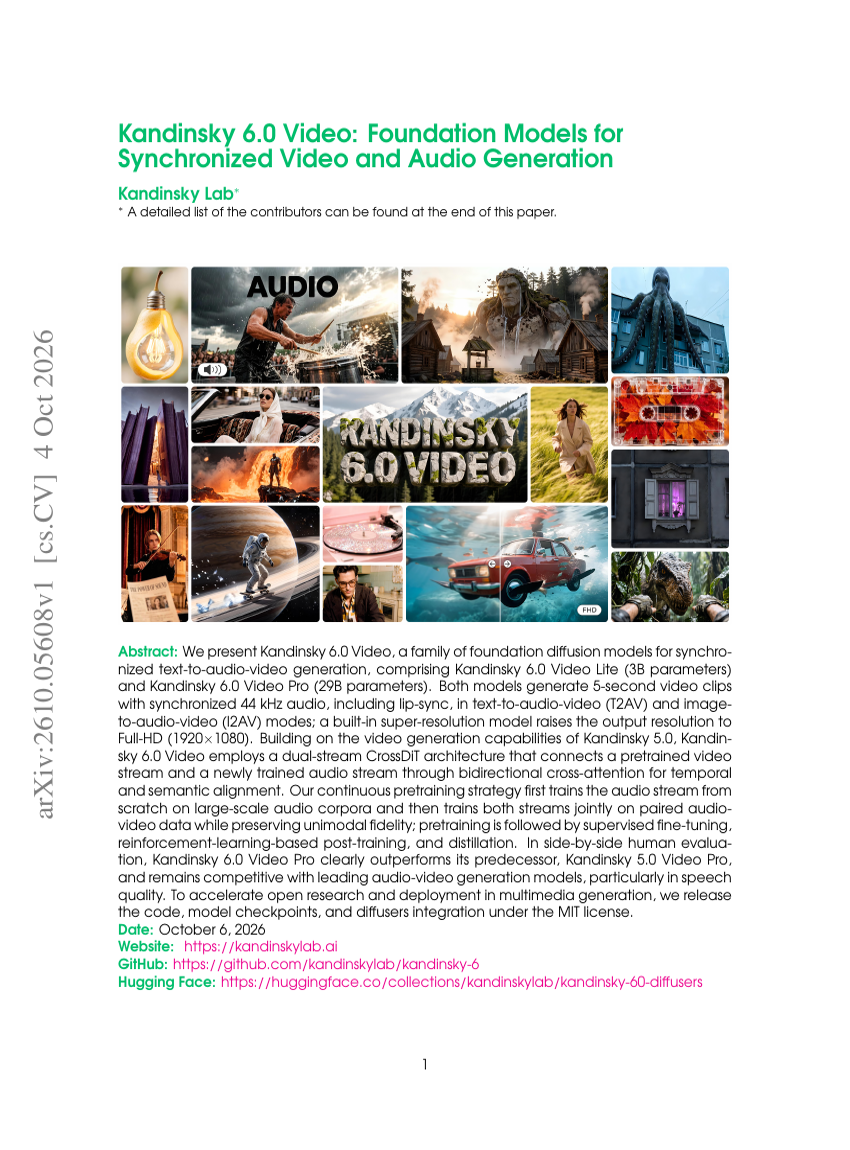
Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
On-Policy Parameter Update Direction Underlies Generalization in LLM Post-Training
World Action Modeling with Progressive Visual Planning
Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
FRAMEMORROW: FUTURE-GUIDED FRAME SELECTION WITH PROSPECTIVE TOKENS FOR LONG-HORIZON VIDEO GENERATION
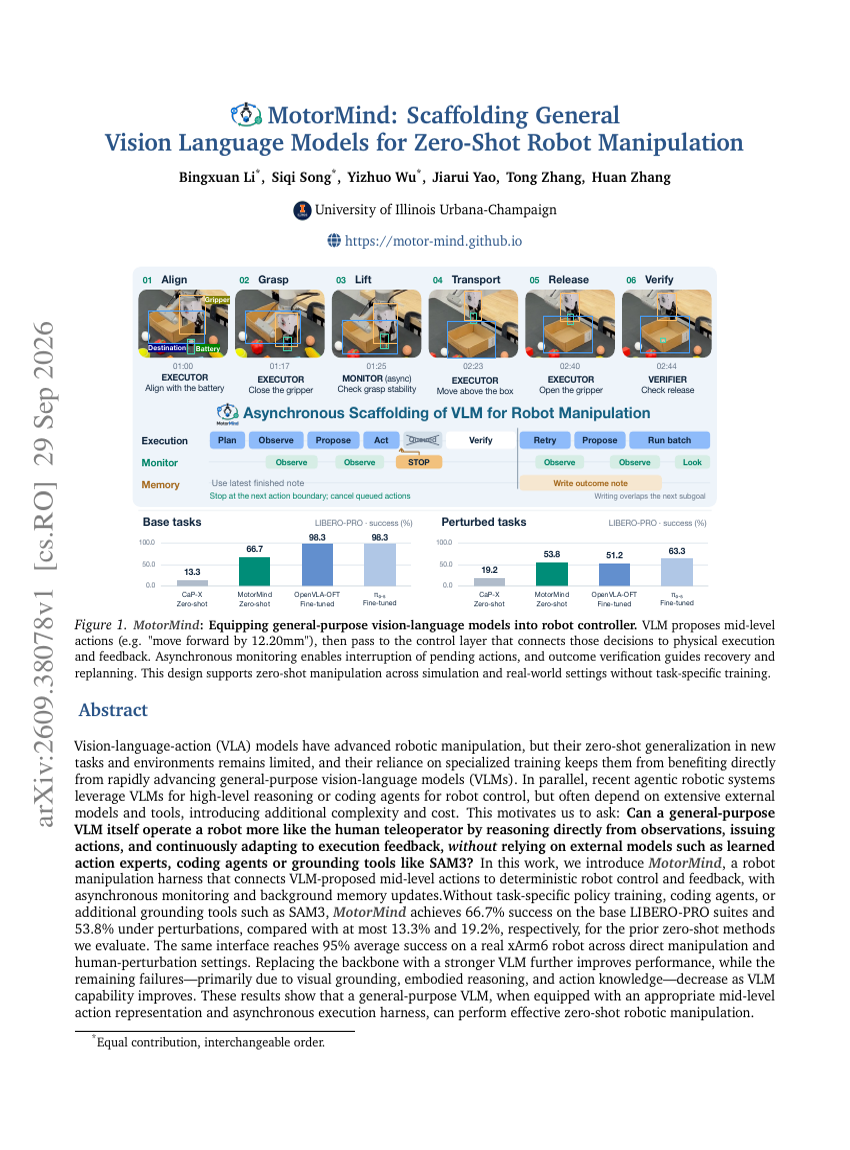
MotorMind: Scafolding General Vision Language Models for Zero-Shot Robot Manipulation
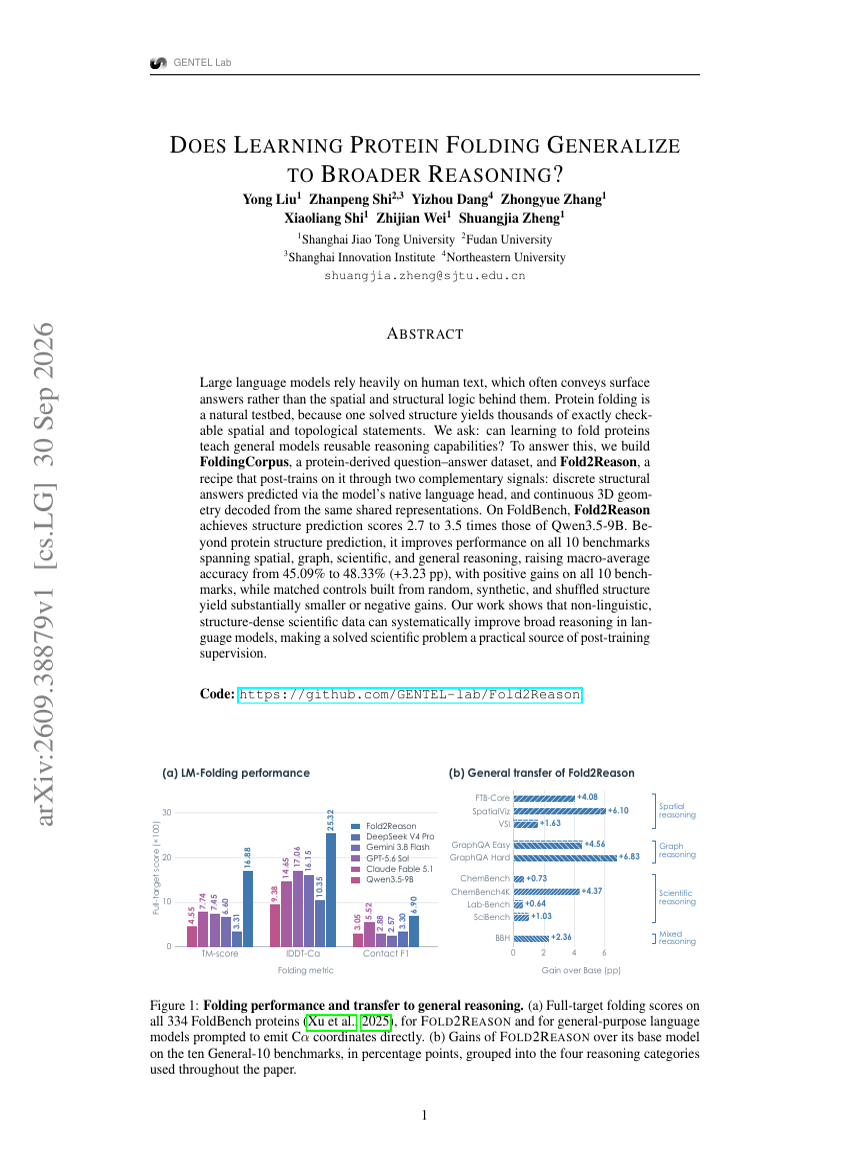
DOES LEARNING PROTEIN FOLDING GENERALIZE TO BROADER REASONING?
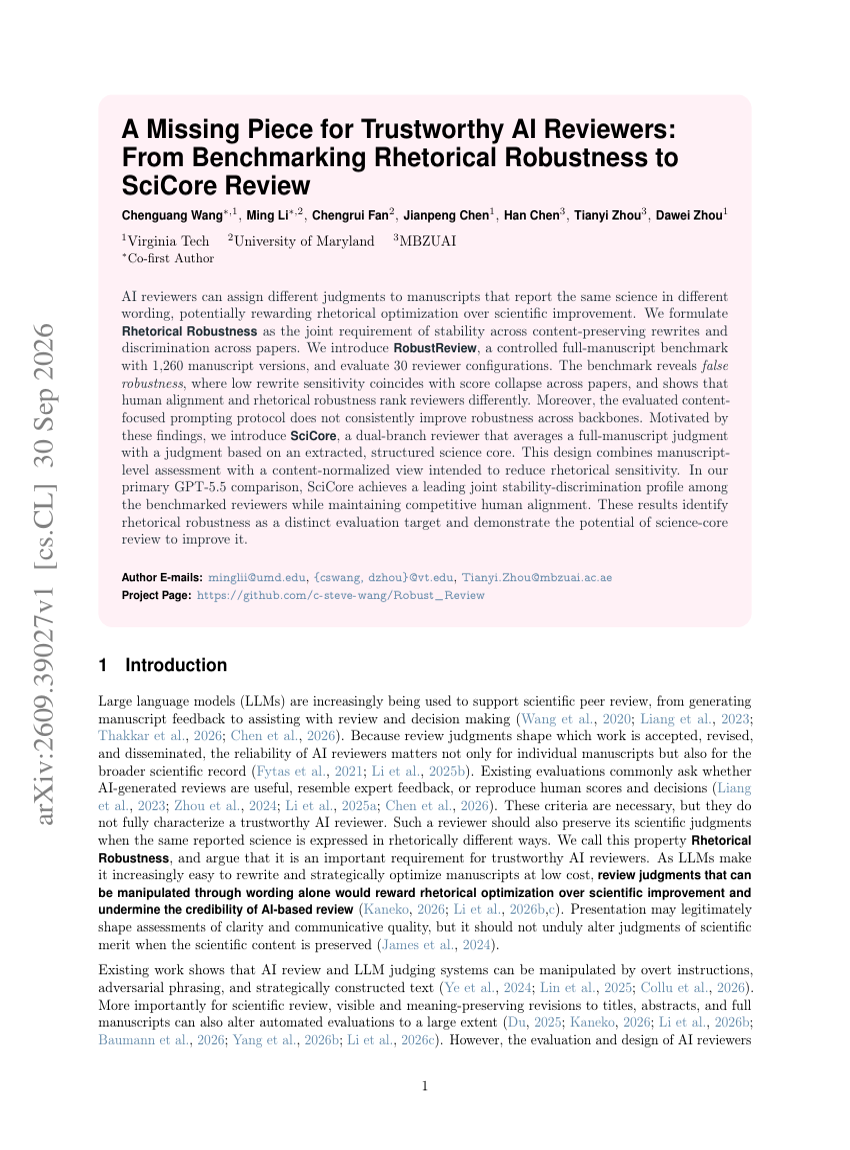
A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review
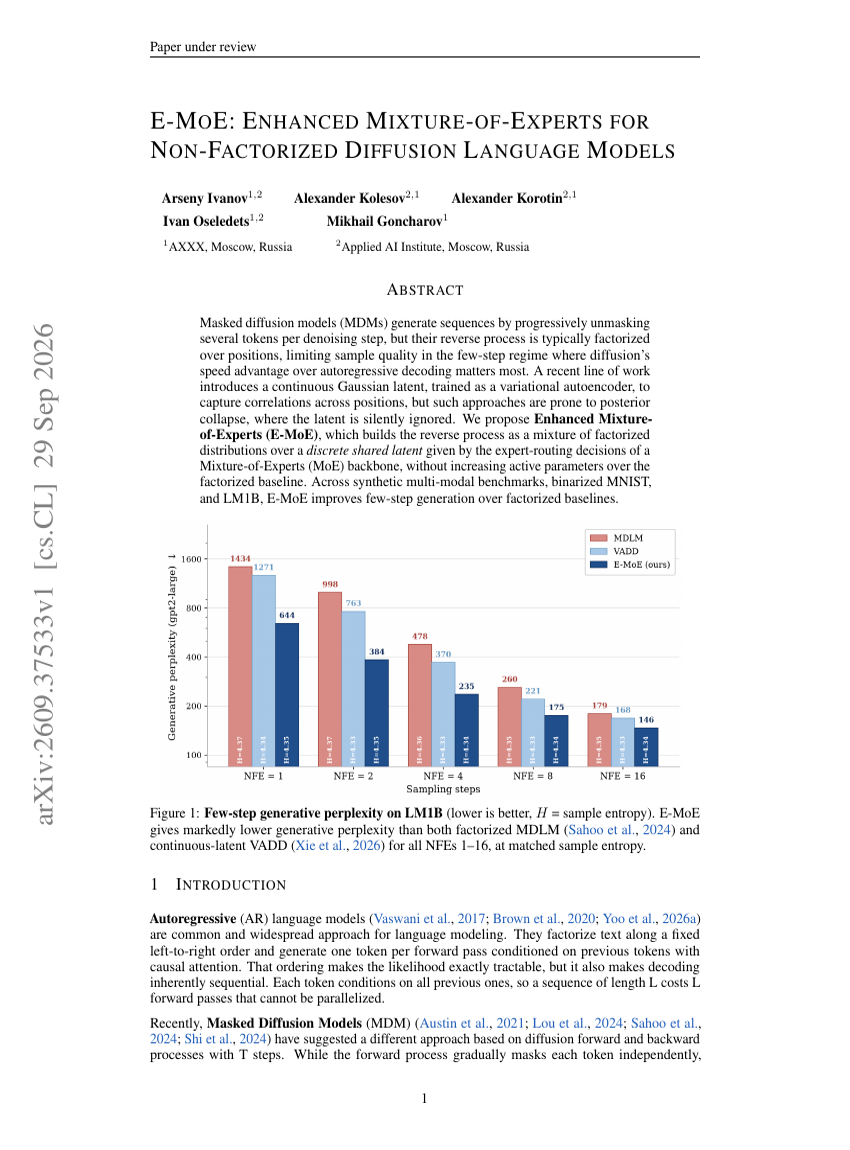
E-MOE: ENHANCED MIXTURE-OF-EXPERTS FOR NON-FACTORIZED DIFFUSION LANGUAGE MODELS
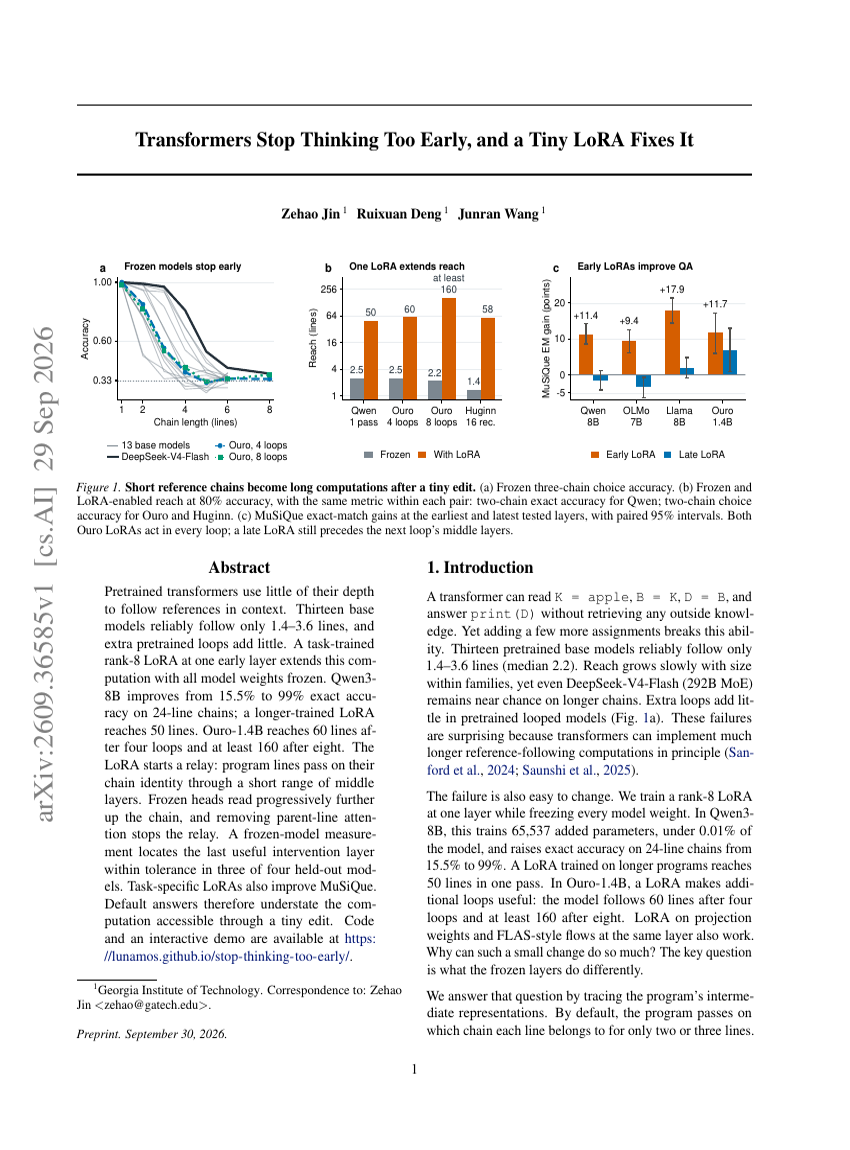
Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
ADAPTIVE REWARD ROUTING: DYNAMIC MULTI-REWARD OPTIMIZATION FOR JOINT AUDIO-VIDEO DIFFUSION VIA FORWARD-PROCESS RL
OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
ON-POLICY OR OFF-POLICY LEARNING? A SYSTEMATIC STUDY OF DISTILLATION DYNAMICS
EVODUET: Bilevel Co-Evolution of Web Searching and Task Solving for Scientific Discovery
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
AREX-2: Advancing Self-Improving Agents through Long-Horizon Reflective Tasks
FALSE FRONTIERS: DIAGNOSING AND MITIGATING CO-CHEATING IN SELF-EVOLVING SEARCH AGENTS
UNIEVO-VL: AN ON-POLICY SELF-DISTILLATION TRAINING RECIPE FOR MULTIMODAL MODEL SELF-IMPROVEMENT
THE TEACHER IS A DIRECTION, NOT A DESTINATION: EXTRAPOLATING RL-INDUCED REPRESENTATION RESIDUALS IN ON-POLICY DISTILLATION
What Makes World Action Models Generalize? An Empirical Study of Test-Time Future Modeling
MaLiang-Harness: A Programmable Path to Image and Video Generation
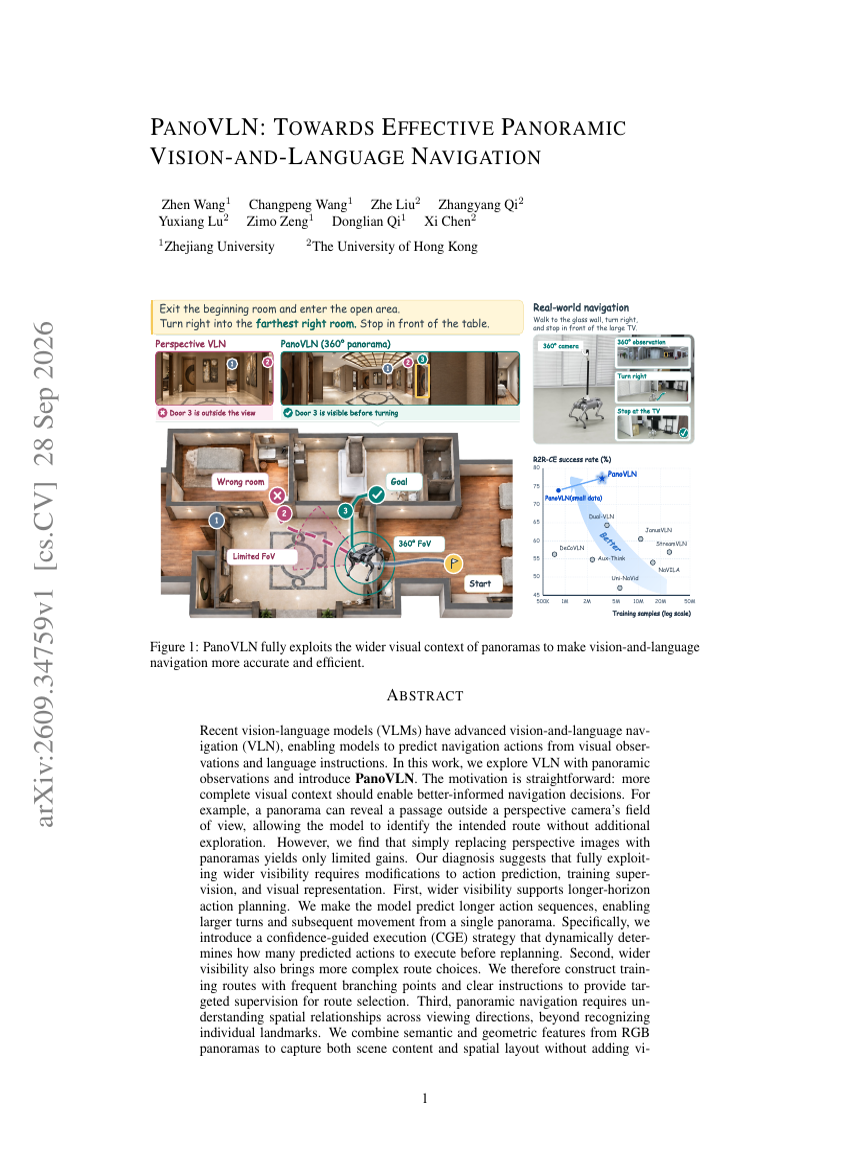
PANOVLN: TOWARDS EFFECTIVE PANORAMIC VISION-AND-LANGUAGE NAVIGATION
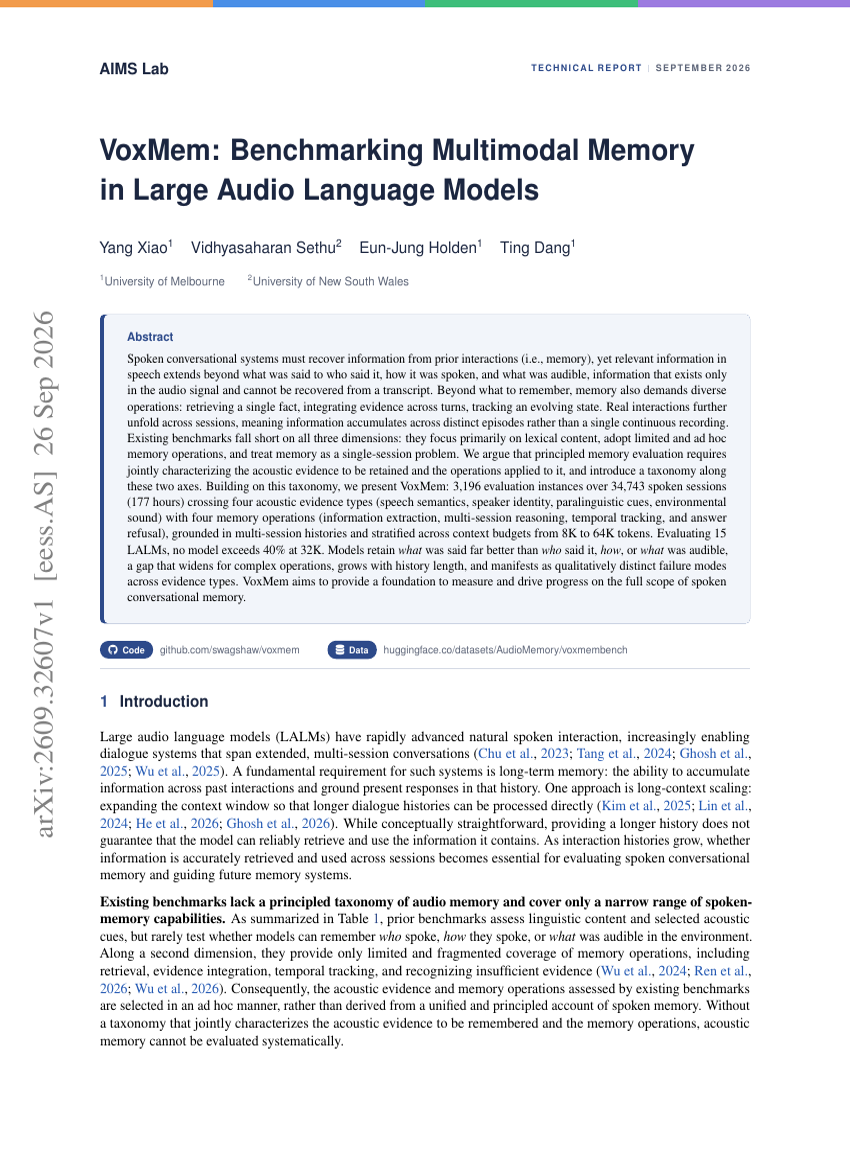
VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models
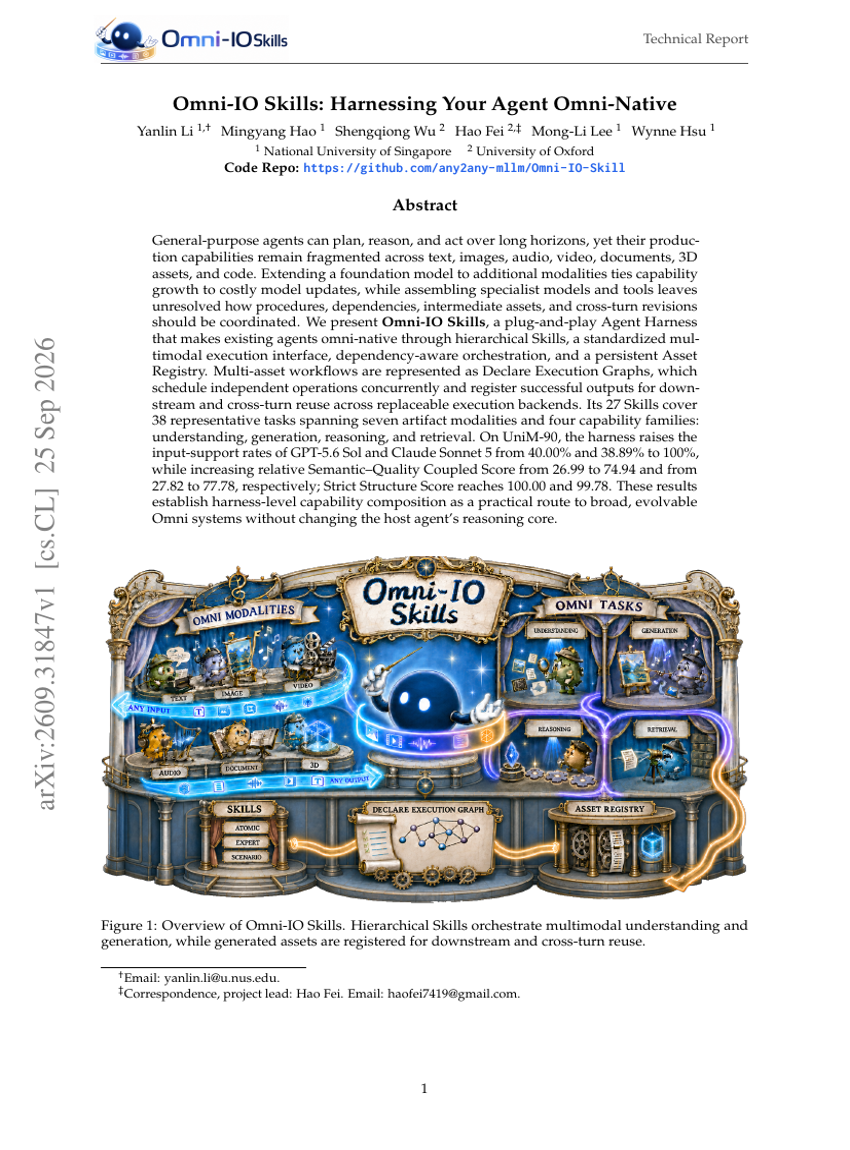
Omni-IO Skills: Harnessing Your Agent Omni-Native
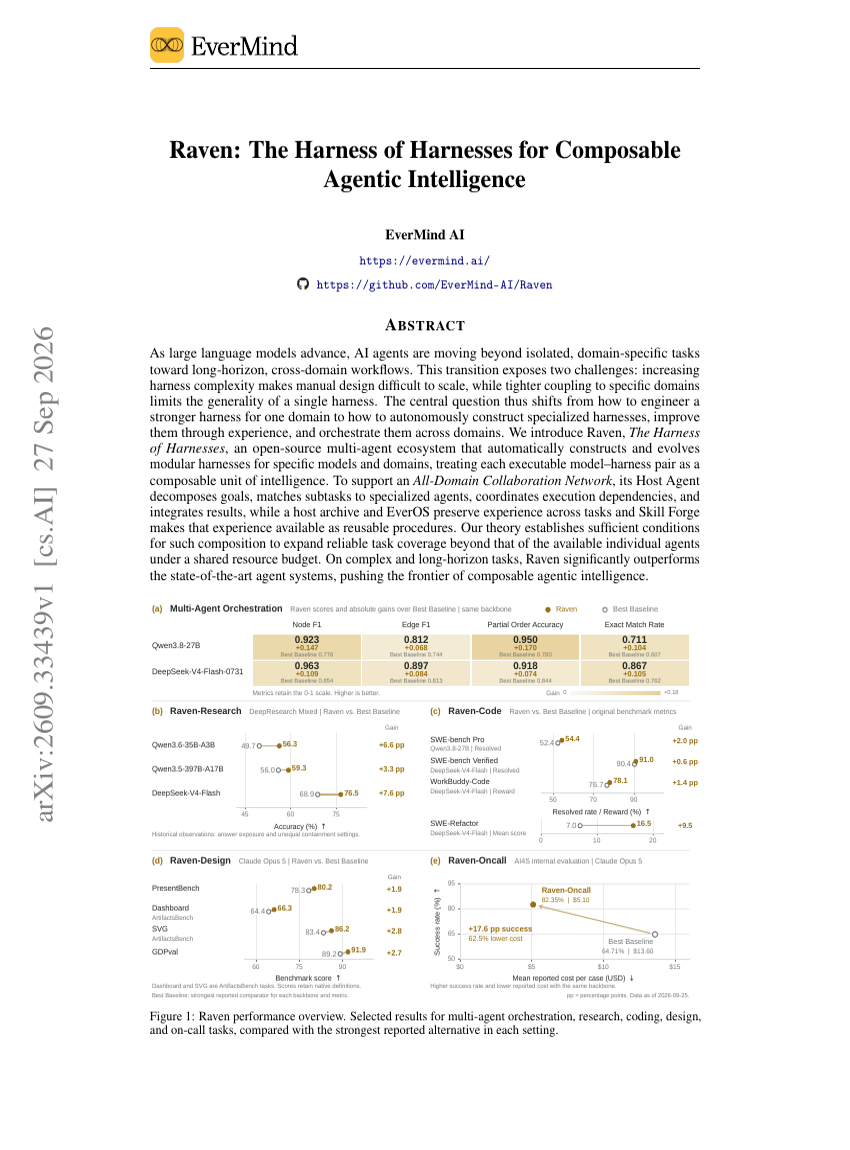
Raven: The Harness of Harnesses for Composable Agentic Intelligence